3.2. List
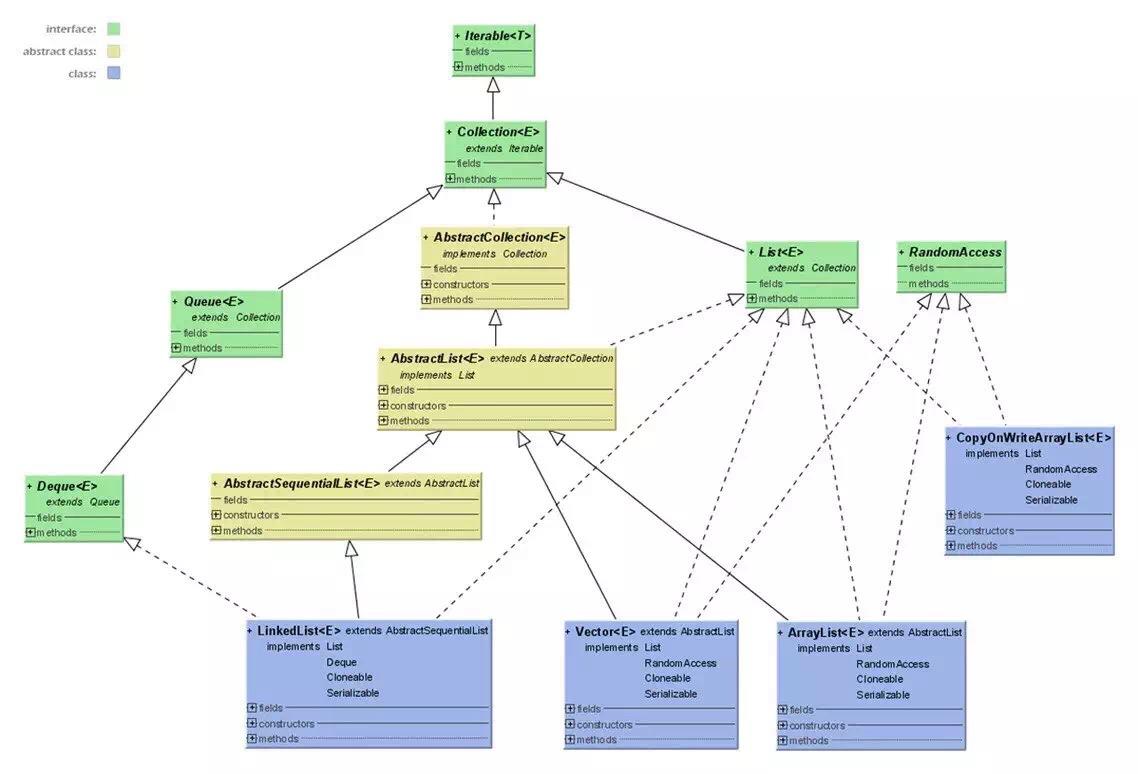
Java 的List 是非常常用的数据类型。List 是有序的 Collection。Java List 一共三个实现类:
分别是 ArrayList、Vector 和 LinkedList。
3.2.1. ArrayList(数组)
ArrayList 是最常用的 List 实现类,内部是通过数组实现的,它允许对元素进行快速随机访问。数组的缺点是每个元素之间不能有间隔,当数组大小不满足时需要增加存储能力,就要将已经有数
组的数据复制到新的存储空间中。当从 ArrayList 的中间位置插入或者删除元素时,需要对数组进行复制、移动、代价比较高。因此,它适合随机查找和遍历,不适合插入和删除。
3.2.2. Vector(数组实现、线程同步)
Vector与ArrayList一样,也是通过数组实现的,不同的是它支持线程的同步,即某一时刻只有一个线程能够写 Vector,避免多线程同时写而引起的不一致性,但实现同步需要很高的花费,因此,
访问它比访问ArrayList 慢。
3.2.3. LinkList(链表)
LinkedList 是用链表结构存储数据的,很适合数据的动态插入和删除,随机访问和遍历速度比较慢。另外,他还提供了 List 接口中没有定义的方法,专门用于操作表头和表尾元素,可以当作堆
栈、队列和双向队列使用。
全站分卷索引 · 248 卷
- 12. JVM
- 22.1. 线程
- 32.2. JVM内存区域
- 42.2.1. 程序计数器(线程私有)
- 52.2.3. 本地方法区(线程私有)
- 62.3. JVM运行时内存
- 71:eden、servicorFrom 复制到ServicorTo,年龄+1
- 82.4. 垃圾回收与算法
- 92.4.2. 标记清除算法(Mark-Sweep)
- 102.4.4. 标记整理算法(Mark-Compact)
- 112.4.5. 分代收集算法
- 122.5. JAVA 四中引用类型
- 132.6.2. 分区收集算法
- 142.7.3. Parallel Scavenge收集器(多线程复制算法、高效)
- 152.7.5. Parallel Old收集器(多线程标记整理算法)
- 162.7.6.2. 并发标记
- 172.8.2. 非阻塞IO模型
- 182.8.4. 信号驱动IO模型
- 192.8.2. JAVA NIO
- 202.8.2.1. NIO的缓冲区
- 212.8.3. Channel
- 222.9. JVM 类加载机制
- 232.9.1.5. 符号引用
- 242.9.2.1. 启动类加载器(Bootstrap ClassLoader)
- 252.9.4. OSGI(动态模型系统)
- 263. JAVA集合
- 273.2. List
- 283.3. Set
- 293.3.1.2. TreeSet(二叉树)
- 303.4. Map
- 313.4.1.2. JAVA8实现
- 323.4.2.3. 并行度(默认16)
- 333.4.3. HashTable(线程安全)
- 344. JAVA多线程并发
- 354.1.2.3. ExecutorService、Callable<Class>、Future有返回值线程
- 364.1.2.4. 基于线程池的方式
- 374.1.3.1. newCachedThreadPool
- 384.1.3.3. newScheduledThreadPool
- 394.1.4.2. 就绪状态(RUNNABLE):
- 404.1.5. 终止线程4种方式
- 414.1.5.4. stop方法终止线程(线程不安全)
- 424.1.7. start与run区别
- 434.1.9. JAVA锁
- 44自旋锁的开启
- 454.1.9.5. ReentrantLock
- 46公平锁
- 47Condition类和Object类锁方法区别区别
- 48Semaphore 与ReentrantLock
- 494.1.9.9. 公平锁与非公平锁
- 504.1.9.12. 重量级锁(Mutex Lock)
- 51减少锁持有时间
- 524.1.10.1. 线程等待(wait)
- 534.1.10.5. Join等待其他线程终止
- 544.1.11. 线程上下文切换
- 554.1.11.6. 上下文切换的活动:
- 564.1.13.3. 拒绝策略
- 574.1.14. JAVA阻塞队列原理
- 584.1.14.1. 阻塞队列的主要方法
- 59获取数据操作:
- 604.1.14.3. ArrayBlockingQueue(公平、非公平)
- 614.1.14.7. SynchronousQueue(不存储数据、可用于传递数据)
- 624.1.15. CyclicBarrier、CountDownLatch、Semaphore的用法
- 634.1.15.3. Semaphore(信号量-控制同时访问的线程个数)
- 644.1.16. volatile关键字的作用(变量可见性、禁止重排序)
- 654.1.17. 如何在两个线程之间共享数据
- 66Runnable对象作为一个类的内部类
- 674.1.18. ThreadLocal作用(线程本地存储)
- 68使用场景
- 694.1.19.2. 两者的不同点:
- 70ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成
- 714.1.21.3. JVM的线程调度实现(抢占式调度)
- 724.1.22.2. 高优先权优先调度算法
- 734.1.22.3. 基于时间片的轮转调度算法
- 744.1.23.2. 原子包 java.util.concurrent.atomic(锁自旋)
- 754.1.23.3. ABA问题
- 76Exclusive独占资源-ReentrantLock
- 77同步器的实现是ABS核心(state资源状态计数)
- 785. JAVA基础
- 795.1.1.3. 异常的处理方式
- 805.1.2. JAVA反射
- 81的编译时类型无法获取具体方法
- 825.1.2.7. 创建对象的两种方法
- 835.1.3. JAVA注解
- 845.1.3.3. 注解处理器
- 855.1.4. JAVA内部类
- 865.1.4.2. 成员内部类
- 875.1.4.4. 匿名内部类(要继承一个父类或者实现一个接口、直接使用new来生成一个对象的引用)
- 885.1.5. JAVA泛型
- 895.1.5.3. 类型通配符?
- 90序列化并不保存静态变量
- 915.1.7.3. 深复制(复制对象和其应用对象)
- 926. Spring 原理
- 936.1.2. Spring 核心组件
- 946.1.4. Spring 主要包
- 956.1.6. Spring 第三方结合
- 966.1.7. Spring IOC原理
- 971.1..1.1.1 BeanDefinitionRegistry注册表
- 981.1..1.1.6 AutowireCapableBeanFactory自动装配
- 99WebApplication体系架构
- 100prototype:原型模式每次使用时创建
- 101ApplicationContextAware实现
- 1026.1.7.6. Spring 依赖注入四种方式
- 103setter方法注入
- 1046.1.7.7. 5种不同方式的自动装配
- 1056.1.8. Spring APO原理
- 1066.1.8.1. AOP两种代理方式
- 107CGLib动态代理
- 1086.1.9. Spring MVC原理
- 109Http请求到DispatcherServlet
- 1106.1.10. Spring Boot原理
- 1116.1.11.1. 分布式事务
- 1126.1.11.1. 两阶段提交
- 1136.1.12. Mybatis缓存
- 1146.1.12.1. Mybatis的一级缓存原理(sqlsession级别)
- 115具体使用需要配置:
- 1167. 微服务
- 1177.1.1.3. 客户端发现
- 1187.1.1.4. 服务端发现
- 1197.1.2.1. 请求转发
- 1207.1.2.5. 安全认证
- 1217.1.6. 服务熔断(Hystrix)
- 1227.1.6.1. Hystrix断路器机制
- 1238. Netty 与RPC
- 1248.1.2.1. 异步通讯NIO
- 1258.1.2.2. 零拷贝(DIRECT BUFFERS使用堆外直接内存)
- 126Reactor多线程模型
- 1278.1.2.5. 无锁设计、线程绑定
- 128小包封大包,防止网络阻塞
- 1298.1.3.1. 消息编解码
- 130序列化
- 131监听消息的线程收到消息,找到callback上的锁并唤醒
- 1328.1.5. Protoclol Buffer
- 1338.1.5.1. 特点
- 1349. 网络
- 1359.1.2. TCP/IP原理
- 1369.1.3. TCP三次握手/四次挥手
- 1379.1.3.2. 三次握手
- 1389.1.3.3. 四次挥手
- 1399.1.4. HTTP原理
- 1402:封装HTTP请求数据包
- 1419.1.4.3. HTTPS
- 142建立连接获取证书
- 1439.1.5.2. 负载均衡系统:
- 14410. 日志
- 14510.1.4. ELK
- 14611. Zookeeper
- 14711.1.1.1. ZAB协议
- 148Discovery(发现阶段-接受提议、生成epoch、接受epoch)
- 14911.1.2. Zookeeper工作原理(原子广播)
- 15012. Kafka
- 15112.1.2.2. 数据文件分段segment(顺序读写、分段命令、二分查找)
- 15212.1.3.2. 批量发送
- 15312.1.1.1. Consumer Group
- 15413. RabbitMQ
- 15513.1.2.1. Message
- 15613.1.2.10. Broker
- 15713.1.3.3. topic 交换器(模式匹配)
- 15814. Hbase
- 15914.1.3. Hbase核心概念
- 16014.1.4.1. Client:
- 16114.1.4.5. Region寻址方式(通过zookeeper .META)
- 16214.1.5. Hbase的写逻辑
- 163全局内存控制
- 16415. MongoDB
- 16516. Cassandra
- 166虚拟节点(down机多节点托管)
- 167Gossip节点的通信方式及收敛性
- 16816.1.6. 数据写请求和协调者
- 16916.1.8. 数据存储(CommitLog、MemTable、SSTable)
- 17016.1.10. 数据读写
- 171墓碑
- 172行缓存和键缓存请求流程图
- 173Bloom Filter(查找数据可能对应的SSTable)
- 17417. 设计模式
- 17517.1.21. 状态模式
- 17618. 负载均衡
- 177haproxy:天生负载均衡技能,全面支持七层代理,会话保持,标记,路径转移;
- 17818.1.2.6. 最少连接数均衡(Least Connection)
- 17918.1.3. LVS
- 18018.1.3.1. LVS NAT 模式
- 18118.1.3.2. LVS DR 模式(局域网改写mac地址)
- 18218.1.3.3. LVS TUN 模式(IP封装、跨网段)
- 18318.1.3.4. LVS FULLNAT模式
- 18418.1.4. Keepalive
- 18518.1.5.1. upstream_module和健康检测
- 18618.1.6. HAProxy
- 18719. 数据库
- 18819.1.1.3. TokuDB(Fractal Tree-节点带数据)
- 18919.1.2.1. 常见索引原则有
- 19019.1.3.3. 第三范式(3rd NF- 不存在对非主键列的传递依赖)
- 191隔离性(Isolation)
- 19219.1.7.2. 悲观锁
- 19319.1.10. 分区分表
- 19419.1.11.1. 准备阶段
- 19519.1.12. 三阶段提交协议
- 196异步确保型
- 19719.1.14. CAP
- 19820. 一致性算法
- 1991.崩溃恢复:主要就是Leader选举过程
- 20020.1.3.3. 选举(Election)
- 20120.1.4. NWR
- 20220.1.6. 一致性Hash
- 203考察cache 的变动
- 20421. JAVA算法
- 20521.1.3. 插入排序算法
- 20621.1.4. 快速排序算法
- 20721.1.1. 希尔排序算法
- 20821.1.2. 归并排序算法
- 20921.1.3. 桶排序算法
- 21021.1.4. 基数排序算法
- 21121.1.5. 剪枝算法
- 21222. 数据结构
- 21322.1.4. 散列表(Hash Table)
- 21422.1.5.2. 删除操作
- 21522.1.5.3. 查询操作
- 21622.1.6.1. 右旋
- 21722.1.6.1. 添加
- 21822.1.6.2. 删除
- 21922.1.7. B-TREE
- 22022.1.8. 位图
- 22123. 加密算法
- 22223.1.3. CRC
- 22324. 分布式缓存
- 22425. Hadoop
- 22525.1.3. MapReduce
- 22625.1.3.3. TaskTracker
- 22725.1.4. Hadoop MapReduce 作业的生命周期
- 22826. Spark
- 22926.1.3. 核心组件
- 23026.1.5. SPARK计算模型
- 23126.1.6. SPARK运行流程
- 2321. 构建Spark Application的运行环境,启动SparkContext
- 233(2)RDD的两种操作算子(转换(Transformation)与行动(Action))
- 23427. Storm
- 23527.1.1.4. Task
- 23627.1.2.5. Stream
- 23727.1.3.3. Task(最终运行spout或bolt中代码的单元)
- 23827.1.4.1. huffle Grouping
- 23927.1.4.4. Global grouping
- 24028. YARN
- 24128.1.4. ApplicationMaster
- 24228.1.5. YARN运行流程
- 24329. 机器学习
- 24430. 云计算
- 24530.1.4.2. Namespaces
- 24630.1.4.3. 进程(CLONE_NEWPID 实现的进程隔离)
- 24730.1.4.5. 资源隔离与CGroups
- 24830.1.5. Openstack