第 3 节:HashMap 源码分析(下)
第 3 节:HashMap 源码分析(下)
在上一章节我们讲解并用数据验证了,HashMap 中的,散列表的实现、扰动函数、
负载因子以及扩容拆分等核心知识点以及相应的作用。
除了以上这些知识点外,HashMap 还有基本的数据功能;存储、删除、获取、遍历,
在这些功能中经常会听到链表、红黑树、之间转换等功能。而红黑树是在 jdk1.8
引入到 HashMap 中解决链表过长问题的,简单说当链表长度>=8时,将链表转换
位红黑树 ( 当然这里还有一个扩容的知识点,不一定都会树化
[MIN_TREEIFY_CAPACITY])。
那么本章节会进行讲解以下知识点;
1.数据插入流程和源码分析 2.链表树化以及树转链表
3.遍历过程中的无序 Set的核心知识
一、插入
1. 疑问点&考题
通过上一章节的学习,大家对于一个散列表数据结构的 HashMap 往里面插入数据
时,基本已经有了一个印象。简单来说就是通过你的 Key 值取得哈希再计算下标,
之后把相应的数据存放到里面。
但再这个过程中会遇到一些问题,比如;
1.如果出现哈希值计算的下标碰撞了怎么办?
| 2. | 如果碰撞了是扩容数组还是把值存成链表结构,让一个节点有多个值存放呢? |
|---|---|
| 3. | 如果存放的数据的链表过长,就失去了散列表的性能了,怎么办呢? |
| 4. | 如果想解决链表过长,什么时候使用树结构呢,使用哪种树呢? |
这些疑问点都会在后面的内容中逐步讲解,也可以自己思考一下,如果是你来设
计,你会怎么做。
2. 插入流程和源码分析
HashMap 插入数据流程图
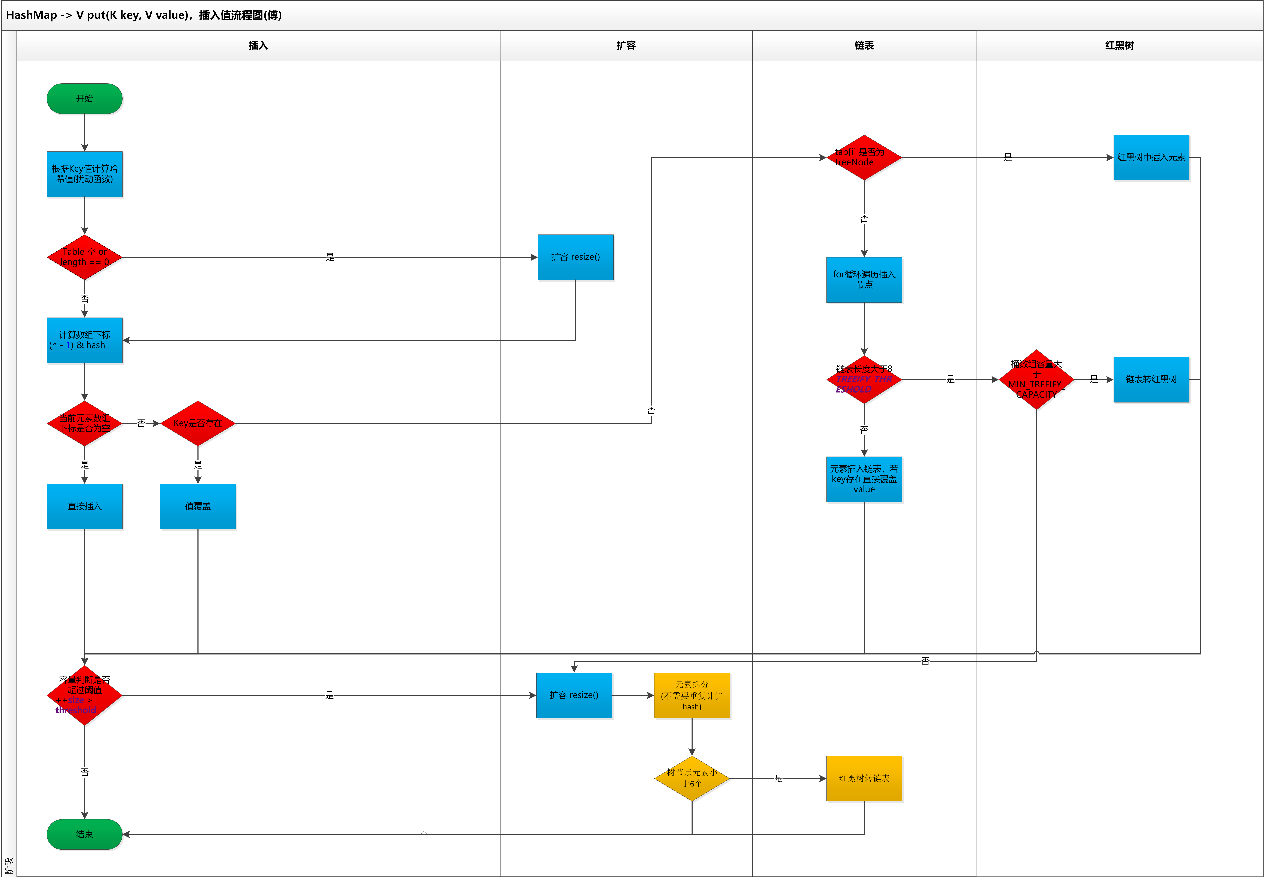
公众号:bugstack 虫洞栈,HashMap 插入数据流程图
visio原版流程图,可以通过关注公众号:bugstack虫洞栈,进行下载
以上就是 HashMap 中一个数据插入的整体流程,包括了;计算下标、何时扩容、
何时链表转红黑树等,具体如下;
1. 首先进行哈希值的扰动,获取一个新的哈希值。(key == null) ? 0 : (h
= key.hashCode()) ^ (h >>> 16);
- 判断 tab 是否位空或者长度为 0,如果是则进行扩容操作。
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
3. 根据哈希值计算下标,如果对应小标正好没有存放数据,则直接插入即可
否则需要覆盖。tab[i = (n - 1) & hash])
4. 判断 tab[i]是否为树节点,否则向链表中插入数据,是则向树中插入节
点。
5. 如果链表中插入节点的时候,链表长度大于等于 8,则需要把链表转换为
红黑树。treeifyBin(tab, hash);
- 最后所有元素处理完成后,判断是否超过阈值;threshold,超过则扩容。
7. treeifyBin,是一个链表转树的方法,但不是所有的链表长度为 8 后都会
转成树,还需要判断存放 key 值的数组桶长度是否小于 64
MIN_TREEIFY_CAPACITY。如果小于则需要扩容,扩容后链表上的数据会被
拆分散列的相应的桶节点上,也就把链表长度缩短了。
JDK1.8 HashMap 的 put 方法源码如下:
return putVal(hash(key), key, value, false, true);
}
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
boolean evict) {
Node<K,V>[] tab; Node<K,V> p; int n, i;
// 初始化桶数组 table,table 被延迟到插入新数据时再进行初始化
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
// 如果桶中不包含键值对节点引用,则将新键值对节点的引用存入桶中即可
if ((p = tab[i = (n - 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);
else {
Node<K,V> e; K k;
// 如果键的值以及节点 hash 等于链表中的第一个键值对节点时,则将 e 指向该键值对
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
e = p;
// 如果桶中的引用类型为 TreeNode,则调用红黑树的插入方法
else if (p instanceof TreeNode)
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
else {
// 对链表进行遍历,并统计链表长度
for (int binCount = 0; ; ++binCount) {
// 链表中不包含要插入的键值对节点时,则将该节点接在链表的最后
if ((e = p.next) == null) {
p.next = newNode(hash, key, value, null);
// 如果链表长度大于或等于树化阈值,则进行树化操作
if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
treeifyBin(tab, hash);
break;
}
// 条件为 true,表示当前链表包含要插入的键值对,终止遍历
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
break;
全站分卷索引 · 320 卷
- 1介绍
- 介绍
- 欢迎来到这里,很高兴你能拿到这本书。如果你能坚持看完书中每章节的内容,
- 那么不仅可以在你的面试求职上有所帮助,也更能让你对 Java 核心技术有更
- 《Java 面经手册》是一本以面试题为入口讲解 Java 核心技术的 PDF 书籍,
- 书中内容也极力的向你证实代码是对数学逻辑的具体实现。为什么这么说?当你仔
- 细阅读书籍时,会发现这里有很多数学知识,包括:扰动函数、负载因子、拉链
- 编码只是在确定了研发设计后的具体实现,而设计的部分包括:数据结构、算法
- 逻辑以及设计模式等,而这部分数据结构和算法逻辑在 Java 的核心 API 中体
- 现的淋漓尽致。那么,也就解释了为什么这些内容成为了热点面试题,虽然可能
- 那么,🚕汽车 75 马力就够奔跑了,那你怎么还想要 2.0 涡轮+9AT 呢?大桥两边
- 很多时候,你额外的能力才是自身价值的体现,不要以为你的能力就只是做个业
- 务开发每天 CRUD。其实有时候并不是产品让你写 CRUD,而是因为你的能力只能
- 23. 阅读建议
- 3目录
- 4第 5 章 JVM 虚拟机
- 5本书源码
- 6第 1 章 谈谈面试(4节)
- 第 1 章谈谈面试(4 节)
- 第 1 节:面试官都问我啥
- 一直以来都有小伙伴问我什么时候出一些面试系列的文章,脑袋一热一口答应下
- 来,《重学 Java 设计模式》写完就安排。但是怎么写,要写成什么样才对读者
- 再三思考,面试只是一时的,工作、学习,才是长久坚持的。很多人面试不理想
- 多半也是来自于自我学习能力的不足和工作内容的单一以及业务体量小导致。所
- 以我想从全局培养人才的角度出发,也算是技术成长的经历中提取学习框架,帮
- 招聘一个合格的研发有多难?近半年我差不多收了 400 份简历,筛选简历到初面
- 通过的不足 10%。这里面很多人连简历都写不好,面试时也经常回答不到点上,
- 技术栈广度不够深度不足,项目经验缺乏,没有解决复杂场景的经验等等。但也
- 同样有很多优秀的,手里有多个 offer 最后流失。对于企业是损失,但对于个人
- 有时候不是面试难,而是年龄与能力不匹配,对企业招聘来说,同样能力下你价
- 7二、谢飞机简历
- 8三、面试框架
- 91. 自我介绍
- 1. 自我介绍
- 1. 1 分钟左右的自我介绍,简要的描述出;姓名、毕业时间、工作年限、
- 2. 如果有较大型项目或者大家有一致性认知的项目和技术难点攻克,可以
- 3. 方法论沉淀相关;架构设计能力、带过小组或者团队、跨部门协调、流
- 你要透露出的核心点就是个人的一个基本信息,以及项目和技术上的沉淀,给面
- 试官留出和你聊下去的话题
- 例如:
- 面试官好,我叫谢飞机,16 年毕业于天津工业大学,软件工程专业,目前已工作
- 4 年。我从毕业后就职于途乐数字科技,负责营销和订单系统开发。在系统搭建、
- 代码优化、问题处理上有较丰富的经验和处理能力。同时也喜欢写一些技术博客
- 和看一些技术书籍,另外在 Spring、Dubbo 等源码学习上有过一些研究以及复用
- 2. 面试类型
- 103. 算法
- 114.1.2 Redis
- 124.2 框架
- 134.2.2 Mybatis
- 3. Spring 事务中的隔离级别有哪几种
- 4. schedule 使用
- 1. mybatis 在 spring 的使用中,只需要定义接口,就可以和 xml 中的配置
- 的 sql 语句,进行关联,执行数据库增删改查操作。怎么实现的
- 2. session 是怎么管理的
- 1. SpringBoot 怎么开发一个自己的 Stater
- 1. spring cloud 断路器的作用是什么
- 2. spring cloud 的核心组件有哪些 Eureka:服务注册于发现。 Feign:
- 基于动态代理机制,根据注解和选择的机器,拼接请求 url 地址,发起
- Hystrix:提供线程池,不同的服务走不同的线程池,实现了不同服务调
- 用的隔离,避免了服务雪崩的问题。 Zuul:网关管理,由 Zuul 网关转
- 4.3 组件
- 144.3.4 Hbase
- 154.5.4 分布式任务
- 165.3 技术沉淀
- 176. 个人&面试官
- 18第 2 节:认知自己的技术栈盲区
- 第 2 节:认知自己的技术栈盲区
- 讲到技术盲区,先说说我自己。几年前我也是从传统行业跨到互联网,同时还是
- 从 C#开发转到 Java 开发,与其说转不如说是回归 Java。从上大学到毕业实习,
- 我都是做 Java 的,但入职第一家公司,由于技术积累以及需要用 C#与中继器、
- IO 板卡、摄像头等进行交互,以及开发的软件是部署到客户端的,所以整套服务
- 但可能由于自身仍有一股热爱 Java 的兴趣,把公司里我接触到的 C#软件,都用
- Java 去实现了一遍。比如 Java 与 RS232 串口进行通信操作,读取摄像头扫描信
- 息等等。最终承载着这份兴趣跳槽了,刚出来的时候面试也是晕的,毕竟很多技
- 术栈的内容是我没用过的,好在研究过 Netty,算是当时一个技术亮点勉强通过,
- 可能每个人或多或少都有一些未接触的技术,虽然这些技术栈可能是整套架构中
- 包括的,但可能由于经常忙于业务需求开发、技术组内缺少分享传承、再者是自
- 己懒于探索究竟,而导致自己的技术盲区越来越多,久而久之就成了技术组里的
- 192. 汇总出来的技术栈列表
- 20二、汇总技术架构图
- 211. 负载
- 223. 架构
- 2. 为了方便客户端调用微服务,所以设计出了网关。在微服务实例地址发
- 3. 网关可以完成的功能:路由、反向代理、日志记录、权限控制、限流、
- 切量、黑白名单等
- 3. 架构
- 1. 大家最先接触的架构基本都是 MVC,后来进入互联网企业开始逐渐有了
- 2. 随着 SpringBoot 的兴起,DDD 领域驱动设计下的微服务逐渐起来了,这
- 3. SOA 是面向服务的架构模型,它将应用程序的不同功能单元(称为服
- 4. 治理
- 2. 这里的思想是为了进行统一管理控制,各业务系统都是一个个自服务,
- 5.框架语言
- 1. 这一层就是大家日常开发的技术语言层,用到各个技术栈来满足开发需
- 3. 同时这里也会涉及到很多的盲区技术,因业务开发的特性不同,所需要
- 238. 环境
- 1. 数据是整个系统的价值体现,因业务的体量发展从单库单表到分库分
- 2. 同时在 DB 数据的同步过程中一般会使用基于 binlog 的 otter 进行同步
- 3. 以及 Neo4j 是一个高性能的,NOSQL 图形数据库,它将结构化数据存储
- 在网络上而不是表中。它是一个嵌入式的、基于磁盘的、具备完全的事
- 务特性的 Java 持久化引擎,但是它将结构化数据存储在网络(从数学角
- 8. 环境
- 1. 在项目开发完成后一般会部署到自己的服务上或者云服务,以及选择不
- 2. 再比如现在比较火的 Docker 和 K8S,虽然不是日常开发的一部分,但也
- 9. 支撑服务
- 1. 这一部分包括的是;部署、压测、日志、JVM监控、业务全链路监控、
- 2. 除此之外还有一些工具类的软件,比如:IDEA、navicat、Xshell、
- 三、总结
- 24一、我的简历都石沉大海
- 25二、修改后电话约面不断
- 26三、简历好也要做好准备
- 271.4 Rpc框架 - Dubbo
- 282. 源码理解
- 29五、总结
- 30第 4 节:大厂都爱聊啥
- 312. 地理位置
- 322. 大厂考题
- 但你可能忽略了,你的这份简历才更多的决定了你会遇到一个什么样的公司、什
- 在与很多小伙伴沟通中发现,其实很大一部分程序员都不会写简历的,或者说写
- 不好简历。好像是有话说不出来,或者是不知道该把这些话说在哪。一份简历主
- 而这份简历想达到最终的效果,也就是拿 Offer。那么一定要给面试官挖坑,当
- 然这个坑不是真坑。而是你要在简历中突出自己的优势项、技术亮点、优秀经历,
- 但如果说你胡乱写简历,说自己懂 HashMap。那面试官来劲了,问你:Hash 为什
- 么用 31 计算、扰动函数的作用是什么,以及它可以被应用在哪些地方、负载因子嘎哈的、
- HashMap 是开放寻址还是拉链寻址、链表什么时候树化以及迁移数据算法是什么、2-3 树
- 2. 大厂考题
- 以下这部分考题分析数据是通过抽样的方式,从 Boss 直聘中选取六个互联公司,
- 样例数据
- 332.1 阿里、百度、腾讯
- 343. 考点总结
- 35三、总结
- 36第 2 章 数据结构和算法(11节)
- 第 2 章数据结构和算法(11 节)
- 在面经手册的前两篇介绍了《面试官都问我啥》和《认知自己的技术栈盲区》,
- 这两篇内容主要为了说明面试过程的考查范围,包括个人的自我介绍、技术栈积
- 累、项目经验等,以及在技术栈盲区篇章中介绍了一个整套技术栈在系统架构用
- 的应用,以此全方面的扫描自己有哪些盲区还需要补充。而接下来的章节会以各
- 个系列的技术栈中遇到的面试题作为切入点,讲解技术要点,了解技术原理,包
- 数组(Array)、栈(Stack)、队列(Queue)、链表(LinkList)、树(Tree)、散列表(Hash)、
- 而本文主要讲解的就是与散列表相关的 HashCode,本来想先讲 HashMap,但随着
- 整理资料发现与 HashMap 的实现中,HashCode 的散列占了很重要的一设计思路,
- 一、面试题
- 说到 HashCode 的面试题,可能这是一个非常核心的了。其他考点;怎么实现散
- 37二、资源下载
- 382. 来自stackoverflow的回答
- 在获取 hashCode的源码中可以看到,有一个固定值 31,在 for 循环每次执行时
- 进行乘积计算,循环后的公式如下; s[0]*31^(n-1) + s[1]*31^(n-2) + ... +
- 2. 来自 stackoverflow 的回答
- 在 stackoverflow 关于为什么选择 31 作为固定乘积值,有一篇讨论文章,Why
- does Java's hashCode() in String use 31 as a multiplier? 这是一个时间
- 413 个赞👍的回答
- 2. 另外在二进制中,2 个 5 次方是 32,那么也就是 31 * i == (i << 5) -
- i。这主要是说乘积运算可以使用位移提升性能,同时目前的 JVM 虚拟机
- 393. Hash值碰撞概率统计
- 403.3 Hash碰撞概率计算
- 414. Hash值散列分布
- 公众号:bugstack 虫洞栈,hash 碰撞图表
- 1. 乘数是 2 时,hash 的取值范围比较小,基本是堆积到一个范围内了,后
- 2. 乘数是 3、5、7、17 等,都有较大的碰撞概率
- 4. 顺着往下看,你会发现 199 的碰撞概率更小,这就相当于一排奇数的茅
- 坑量多,自然会减少碰撞。但这个范围值已经远超过 int 的取值范围
- 4. Hash 值散列分布
- 除了以上看到哈希值在不同乘数的一个碰撞概率后,关于散列表也就是 hash,
- 还有一个非常重要的点,那就是要尽可能的让数据散列分布。只有这样才能减少
- 那么怎么看散列分布呢?如果我们能把 10 万个 hash 值铺到图表上,形成的一张
- 图,就可以看出整个散列分布。但是这样的图会比较大,当我们缩小看后,就成
- 一个了大黑点。所以这里我们采取分段统计,把 2 ^ 32 方分 64 个格子进行存
- 424.1 哈希值分段存放
- 434.2.1 乘数2散列
- 44四、总结
- 文中引用
- http://www.tianxiaobo.com/2018/01/18/String-
- hashCode-%E6%96%B9%E6%B3%95%E4%B8%BA%E4%BB%80%E4%B9%88%E9%80%89
- %E6%8B%A9%E6%95%B0%E5%AD%9731%E4%BD%9C%E4%B8%BA%E4%B9%98%E5%AD%
- 90/
- https://stackoverflow.com/questions/299304/why-does-javas-
- hashcode-in-string-use-31-as-a-multiplier
- 四、总结
- 以上主要介绍了 hashCode 选择 31 作为乘数的主要原因和实验数据验
- 证,算是一个散列的数据结构的案例讲解,在后续的类似技术中,就可
- 看过本文至少应该让你可以从根本上解释了 hashCode 的设计,关于他的
- 所有问题也就不需要死记硬背了,学习编程内容除了最开始的模仿到深
- 45第 2 节:HashMap 源码分析(上)
- 第 2 节:HashMap 源码分析(上)
- 得益于 Doug Lea老爷子的操刀,让 HashMap成为使用和面试最频繁的 API,没办
- HashMap 最早出现在 JDK 1.2 中,底层基于散列算法实现。HashMap 允许 null
- 键和 null 值,在计算哈键的哈希值时,null 键哈希值为 0。HashMap 并不保
- 另外,需要注意的是,HashMap 是非线程安全类,在多线程环境下可能会存在问
- HashMap 最早在 JDK 1.2 中就出现了,底层是基于散列算法实现,随着几代的优
- 化更新到目前为止它的源码部分已经比较复杂,涉及的知识点也非常多,在 JDK
- 1.8 中包括;1、散列表实现、2、扰动函数、3、初始化容量、4、负载因子、5、扩容元
- 素拆分、6、链表树化、7、红黑树、8、插入、9、查找、10、删除、11、遍历、12、分
- 段锁等等,因涉及的知识点较多所以需要分开讲解,本章节我们会先把目光放在
- 数据结构相关往往与数学离不开,学习过程中建议下载相应源码进行实验验证,
- 一、资源下载
- 461.1 代码实现
- 问题:假设我们有一组 7 个字符串,需要存放到数组中,但要求在获取每个元
- 素的时候时间复杂度是 O(1)。也就是说你不能通过循环遍历的方式进行获取,
- 方案:如果说我们需要通过 ID 从数组中获取元素,那么就需要把每个字符串都
- 计算出一个在数组中的位置 ID。字符串获取 ID 你能想到什么方式?一个字符
- 串最直接的获取跟数字相关的信息就是 HashCode,可 HashCode 的取值范围太大
- 了[-2147483648, 2147483647],不可能直接使用。那么就需要使用 HashCode 与
- 数组长度做与运算,得到一个可以在数组中出现的位置。如果说有两个元素得到
- 以上呢其实就是我们要把字符串散列到数组中的一个基本思路,接下来我们就把
- 1.1 代码实现
- 471.2 Hash散列示意图
- 481.3 这个简单的HashMap有哪些问题
- bugstack.cn Hash 散列示意图
- 这张图就是上面代码实现的全过程,将每一个字符串元素通过 Hash 计算
- 黄色的索引 ID 是没有元素存放、绿色的索引 ID 存放了一个元素、红色
- 1.3 这个简单的 HashMap 有哪些问题
- 以上我们实现了一个简单的 HashMap,或者说还算不上 HashMap,只能算做一个
- 1. 这里所有的元素存放都需要获取一个索引位置,而如果元素的位置不够
- 散列碰撞严重,那么就失去了散列表存放的意义,没有达到预期的性
- 2. 在获取索引 ID 的计算公式中,需要数组长度是 2 的倍数,那么怎么进行
- 4. 目前存放 7 个元素,已经有两个位置都存放了 2 个字符串,那么链表越
- 5. 随着元素的不断添加,数组长度不足扩容时,怎么把原有的元素,拆分
- 以上这些问题可以归纳为;扰动函数、初始化容量、负载因子、扩容方法以及链表和
- 492. 扰动函数
- 2. 扰动函数
- 在 HashMap 存放元素时候有这样一段代码来处理哈希值,这是 java 8的散列值
- 2.1 为什么使用扰动函数
- 理论上来说字符串的hashCode是一个int类型值,那可以直接作为数组下标了,
- 且不会出现碰撞。但是这个hashCode的取值范围是[-2147483648, 2147483647],
- 我们默认初始化的 Map 大小是 16 个长度 DEFAULT_INITIAL_CAPACITY = 1 << 4,
- 所以获取的 Hash 值并不能直接作为下标使用,需要与数组长度进行取模运算得
- 那么,hashMap 源码这里不只是直接获取哈希值,还进行了一次扰动计算,(h =
- key.hashCode()) ^ (h >>> 16)。把哈希值右移 16 位,也就正好是自己长度的一
- 半,之后与原哈希值做异或运算,这样就混合了原哈希值中的高位和低位,增大
- 502.2 实验验证扰动函数
- 512.2.2 扰动函数散列图表
- 523. 初始化容量和负载因子
- 从这两种的对比图可以看出来,在使用了扰动函数后,数据分配的更加
- 数据分配均匀,也就是散列的效果更好,减少了 hash 的碰撞,让数据存
- 3. 初始化容量和负载因子
- 接下来我们讨论下一个问题,从我们模仿 HashMap 的例子中以及 HashMap 默认的
- 初始化大小里,都可以知道,散列数组需要一个 2 的倍数的长度,因为只有 2 的
- 那么这里就有一个问题,我们在初始化 HashMap 的时候,如果传一个 17 个的值
- 3.1 寻找 2 的倍数最小值
- 阀值 threshold,通过方法 tableSizeFor进行计算,是根据初始化来计
- 这个方法也就是要寻找比初始值大的,最小的那个 2 进制数值。比如传
- 533.2 负载因子
- 544. 扩容元素拆分
- 554.2 数据迁移
- 这里我们随机使用一些字符串计算他们分别在 16 位长度和 32 位长度数
- 同时,这里还可以观察🕵出一个非常重要的信息,原哈希值与扩容新增
- 出来的长度 16,进行&运算,如果值等于 0,则下标位置不变。如果不为
- 0,那么新的位置则是原来位置上加 16。{这个地方需要好好理解下,
- 并看实验数据}
- 4.2 数据迁移
- bugstack.cn 数据迁移
- 其中黄色区域元素 zuio因计算结果 hash & oldCap 不为 1,则被迁移到
- 同时还是用重新计算哈希值的方式验证了,确实分配到 24 的位置,因为
- 这是在二进制计算中补 1 的过程,所以可以通过上面简化的方式确定哈
- 三、总结
- 如果你能坚持看完这部分内容,并按照文中的例子进行相应的实验验
- 56第 3 节:HashMap 源码分析(下)
- 第 3 节:HashMap 源码分析(下)
- 在上一章节我们讲解并用数据验证了,HashMap 中的,散列表的实现、扰动函数、
- 除了以上这些知识点外,HashMap 还有基本的数据功能;存储、删除、获取、遍历,
- 在这些功能中经常会听到链表、红黑树、之间转换等功能。而红黑树是在 jdk1.8
- 引入到 HashMap 中解决链表过长问题的,简单说当链表长度>=8时,将链表转换
- 位红黑树 ( 当然这里还有一个扩容的知识点,不一定都会树化
- 一、插入
- 1. 疑问点&考题
- 通过上一章节的学习,大家对于一个散列表数据结构的 HashMap 往里面插入数据
- 时,基本已经有了一个印象。简单来说就是通过你的 Key 值取得哈希再计算下标,
- 这些疑问点都会在后面的内容中逐步讲解,也可以自己思考一下,如果是你来设
- 2. 插入流程和源码分析
- 573. 扩容机制
- 584. 链表树化
- 4. 链表树化
- HashMap 这种散列表的数据结构,最大的性能在于可以 O(1)时间复杂度定位到元
- 素,但因为哈希碰撞不得已在一个下标里存放多组数据,那么 jdk1.8 之前的设
- 计只是采用链表的方式进行存放,如果需要从链表中定位到数据时间复杂度就是
- O(n),链表越长性能越差。因为在 jdk1.8 中把过长的链表也就是 8 个,优化为
- 自平衡的红黑树结构,以此让定位元素的时间复杂度优化近似于 O(logn),这样
- 来提升元素查找的效率。但也不是完全抛弃链表,因为在元素相对不多的情况下,
- 以上就是一组链表转换为红黑树的情况,元素包括;40、51、62、73、84、95、
- 150、161 这些是经过实际验证可分配到 Idx:12的节点
- 通过这张图,基本可以有一个链表换行到红黑树的印象,接下来阅读下对应的源
- 链表树化源码
- 595. 红黑树转链
- 60二、查找
- 61三、删除
- 62四、遍历
- 633. 测试结果分析
- 64五、总结
- 65第 4 节:2-3树与红黑树学习(上)
- 第 4 节:2-3 树与红黑树学习(上)
- 很多时候大部分程序员👨💻头疼于,查询慢、效率低、一堆的关联 SQL,主要原
- 因是在程序设计上没有做出很好的数据结构。当然也还有一部分是由于老业务代
- 数据结构、算法、设计模式,是每一个程序员成长过程中的内功心法修炼,而你
- 的新技能用的再绚、多线程使的再 6、加锁玩的再牛🐂,也只能说明你这个人身
- 这一章节是结合 HashMap的延展,在 Jdk1.8 中 HashMap 是使用桶数组+链表和红黑
- 树实现,所以顺着上一章节的核心原理和 API 功能讲解后,本来这一章节想直接
- 进入到红黑树,但如果想把红黑树学明白,就需要了解他的来龙去脉,也就是它
- 一、面试题
- 谢飞机,考你几个简单的知识点
- 二、什么是 2-3 树
- 日常的学习和一部分伙伴的面试中,竟然会听👂到的是;从 HashMap 中文红黑树、
- 662. 二叉搜索树退化链表
- 673. 2-3树解决平衡问题
- 68三、2-3树使用
- 692. 数据插入
- 703. 数据删除
- 714. 数据索引
- 72四、总结
- 73第 5 节:2-3树与红黑树学习(下)
- 第 5 节:2-3 树与红黑树学习(下)
- Rudolf Bayer 于 1978 年发明红黑树,在当时被称为对称二叉 B 树(symmetric
- binary B-trees)。后来,在 1978 年被 Leo J. Guibas 和 Robert Sedgewick 修
- 红黑树具有良好的效率,它可在近似 O(logN) 时间复杂度下完成插入、删除、查
- 找等操作,因此红黑树在业界也被广泛应用,比如 Java 中的 TreeMap,JDK 1.8
- 红黑树的结构和设计都非常优秀,也同样在实现上有着复杂的处理逻辑,包括插
- 入或者删除节点时;颜色变化、旋转操作等操作。但如果只把这些知识点硬背下
- 一、面试题
- 谢飞机,考你几个红黑树的知识点
- 二、2-3 树与红黑树的等价性
- 红黑树规则
- 741. 为什么既有2-3树要有红黑树
- 753. 复杂2-3树转红黑树
- 761.1 左旋转
- 771.3 左右旋综合运用
- 781.4 染色
- 793. 删除操作
- 803.2.1 被删节点兄弟为黑色&含右子节点
- 813.3. 删除右侧节点
- 82四、总结
- 83第 6 节:ArrayList 详细分析
- 第 6 节:ArrayList 详细分析
- 说到数据结构基本包括;数组、链表、队列、红黑树等,但当你看到这些数据结
- 其实这些知识点你并不是没有用到的,而是 Java 中的 API 已经将各个数据结构
- 封装成对应的工具类,例如 ArrayList、LinkedList、HashMap 等,就像在前面
- 的章节中,小傅哥写了 5 篇文章将近 2 万字来分析 HashMap,从而学习它的核心
- 可能有人觉得这类知识就像八股文,学习只是为了应付面试。如果你真的把这些
- 用于支撑其整个语言的根基当八股文学习,那么硬背下来不会有多少收获。理科
- 学习更在乎逻辑,重在是理解基本原理,有了原理基础就复用这样的技术运用到
- 那么,你什么时候会用到这样的技术呢?就是,当你考虑体量、夯实服务、琢磨
- 性能时,就会逐渐的深入到数据结构以及核心的基本原理当中,那里的每一分深
- 一、面试题
- 谢飞机,听说你最近在家很努力学习 HashMap?那考你个 ArrayList 知识点
- 84二、数据结构
- 851.1 方式01;普通方式
- 861.3.1 ArrayList构造函数
- 871.3.2 Arrays.asList
- 881.4 方式04;Collections.ncopies
- Arrays 类中,这部分源码;private static class ArrayList<E>
- extends AbstractList<E> implements RandomAccess,
- java.io.Serializable
- 此外,Arrays 是一个工具包,里面还有一些非常好用的方法,例如;二分查找
- Arrays.binarySearch、排序Arrays.sort等
- 1.4 方式 04;Collections.ncopies
- Collections.nCopies 是集合方法中用于生成多少份某个指定元素的方法,接下
- 2. 插入
- 2.1 普通插入
- 当我们依次插入添加元素时,ArrayList.add 方法只是把元素记录到数组的各个
- 892.2 插入时扩容
- 902.3 指定位置插入
- 912.3.2 元素迁移
- 923. 删除
- 934. 扩展
- 944.2 代码操作(获取元素)
- 95第 7 节:LinkedList、ArrayList,插入分析
- 第 7 节:LinkedList、ArrayList,插入分析
- 🚕汽车 75 马力就够奔跑了,那你怎么还想要 2.0 涡轮+9AT 呢?大桥两边的护栏
- 很多时候,你额外的能力才是自身价值的体现,不要以为你的能力就只是做个业
- 务开发每天 CRUD,并不是产品让你写 CRUD,而是因为你的能力只能产品功能设
- 就像数据结构、算法逻辑、源码技能,它都是可以为你的业务开发赋能的,也是
- 本文涉及了较多的代码和实践验证图稿,欢迎关注公众号:bugstack 虫洞栈,回
- 一、面试题
- 谢飞机,ArrayList 资料看了吧?嗯,那行问问你哈
- 答:啊,这我知道了。ArrayList 是基于数组实现、LinkedList 是基于双向链表
- 实现,所以基于数据结构的不同,遍历和查找多的情况下用 ArrayList、插入和
- 其实,飞机回答的也不是不对,只是不全面。出门后不甘心买瓶肥宅水又回来,
- 96二、数据结构
- 97三、源码分析
- 982. 插入
- 992.1.1 源码
- 1002.1.2 验证
- 1012.2 尾插
- 1022.2.2 验证
- 1032.3 中间插
- 1042.3.1 源码
- 1052.3.2 验证
- 1063. 删除
- 1073.2 源码
- 1084. 遍历
- 1094.2 增强for循环
- 110四、总结
- 111第 8 节:双端队列、延迟队列、阻塞队列
- 112一、面试题
- 113二、数据结构
- 1141.1 功能使用
- 1151.2 源码分析
- 1162. 双端队列ArrayDeque
- 1. Stack 栈是在 JDK1.0 时代时,基于继承Vector,实现的。本身Vector就是
- 一个不推荐使用的类,主要在于它的一些操作方法锁🔒(synchronized)的力度太
- 2. Stack 栈底层是使用Vector 数组实现,在学习ArrayList 时候我们知道,
- 数组结构在元素添加和擅长需要通过System.arraycopy,进行扩容操作。而
- 3.同时在这个方法的注释上也明确标出来,推荐使用Deque<Integer> stack =
- new ArrayDeque<Integer>();,虽然这也是数组结构,但是它没有粗粒度
- 的锁,同时可以申请指定空间并且在扩容时操作时也要优于Stack。并且它还是
- 2. 双端队列 ArrayDeque
- ArrayDeque 是基于数组实现的可动态扩容的双端队列,也就是说你可以在队列
- 的头和尾同时插入和弹出元素。当元素数量超过数组初始化长度时,则需要扩容
- 1172.1 功能使用
- 1182.2.1 初始化
- 1192.2.3 两倍扩容,数据迁移
- 1203. 双端队列LinkedList
- 1213.1 功能使用
- 1223.2 源码分析
- 1234. 延时队列DelayQueue
- 1244.2 源码分析
- 1254.2.2 元素出栈
- 1265. 还有哪些队列?
- 1275.2 使用案例
- 128四、总结
- 129第 9 节:java.util.Collections、排序、二分、洗牌、旋转算法
- 第 9 节:java.util.Collections、排序、二分、洗牌、
- 旋转算法
- 好的算法搭配上合适的数据结构,可以让代码功能大大的提升效率。当然,算法
- 学习不只是刷题,还需要落地与应用,否则到了写代码的时候,还是会 for 循环
- 当开发一个稍微复杂点的业务流程时,往往要用到与之契合的数据结构和算法逻
- 辑,在与设计模式结合,这样既能让你的写出具有高性能的代码,也能让这些代
- 那么,有了这些数据结构的基础,接下来我们再学习一下 Java 中提供的算法工
- 一、面试题
- 问:那数据结构看的差不多了吧,你有考虑过,数据结构里涉及的排序、二分
- 飞机悄然的出门了,但这次面试题整体回答的还是不错的,面试官决定下次再给
- 二、Collections 工具类
- java.util.Collections,是 java 集合框架的一个工具类,主要用于 Collection
- 1301. Collections.sort 排序
- 1311.4 reverseOrder倒排
- 1322. Collections.binarySearch 二分查找
- 1332.2 源码分析
- 此功能就是上图中的具体实现效果,通过 Collections.binarySearch 定位
- 测试结果:二分查找:4
- 2.2 源码分析
- 这段二分查找的代码还是蛮有意思的,list instanceof RandomAccess 这是为什
- 么呢?因为 ArrayList 有实现 RandomAccess,但是 LinkedList 并没有实现
- 这个接口。同时还有元素数量阈值的校验 BINARYSEARCH_THRESHOLD = 5000,小
- 于这个范围的都采用indexedBinarySearch 进行查找。那么这里其实使用
- LinkedList 存储数据,在元素定位的时候,需要 get 循环获取元素,就会比
- Collections.indexedBinarySearch(list, key):
- 以上这段代码就是通过每次折半二分定位元素,而上面所说的耗时点就是
- Collections.iteratorBinarySearch(list, key):
- 1343. Collections.shuffle 洗牌算法
- 1354. Collections.rotate 旋转算法
- 1364.1 功能应用
- 1374.2.1 旋转算法,rotate1
- 1384.2.2 旋转算法,rotate2
- 1395. 其他API介绍
- 1405.3 连续集合位置判断
- 141第 10 节:StringBuilder 与 String 对比
- 第 10 节:StringBuilder 与 String 对比
- 面我的题开发都用不到,你为什么要问?可能这是大部分程序员求职时的经历,
- 甚至也是大家讨厌和烦躁的点。明明给的是拧螺丝的钱、明明做的是写 CRUD 的
- 明明... 有很多,可明明公司不会招 5 年开发做 3 年经验的事、明明公司也更喜
- 欢具有附加价值的研发。有些小公司不好说,但在一些互联网大厂中,我们都希
- 望招聘到具有培养价值的,也更喜欢能快速打怪升级的,也更愿意让这样的人承
- 一、面试题
- 谢飞机,总感觉自己有技术瓶颈、有知识盲区,但是又不知道在哪。所以约面试
- 谢飞机:还有?啊,这样 String str = new String("abc"); 😄
- 面试官:你不懂 String,你没看过源码。还可以这样;new String(new char[]{'c',
- 1421.1 String
- 1432. StringBuilder 比 String 快, 为什么?
- 144三、String 源码分析
- 一看指令码,这不是在循环里(if_icmpgt)给我 new 了 StringBuilder 了吗,
- 怎么还这么慢呢?再仔细看,其实你会发现,这 new 是在循环里吗呀,我们把这
- 现在再看这段代码就很清晰了,所有的字符串链接操作,都需要实例化一次
- StringBuilder,所以非常耗时。并且你可以验证,这样写代码耗时与字符串直接
- 三、String 源码分析
- 1. 初始化
- 在与谢飞机的面试题中,我们聊到了 String 初始化的问题,按照一般我们应
- 用的频次上,能想到的只有直接赋值,String str = "abc";,但因为 String 的
- 底层数据结构是数组 char value[],所以它的初始化方式也会有很多跟数组相关
- 1452. 不可变(final)
- 以上这些方式都可以初始化,并且最终的结果是一致的,abc。如果说初始化的
- 方式没用让你感受到它是数据结构,那么 str_01.charAt(0);呢,只要你往源码
- 里一点,就会发现它是 O(1) 的时间复杂度从数组中获取元素,所以效率也是非
- 2. 不可变(final)
- 字符串创建后是不可变的,你看到的+加号连接操作,都是创建了新的对象把数据
- 从源码中可以看到,String 的类和用于存放字符串的方法都用了 final 修饰,
- 举个例子
- 不考虑其他情况,对于程序初始化。以上这些代码 str_01、str_02、str_03,都
- 会初始化几个对象呢?其实这个初始化几个对象从侧面就是反应对象是否可变
- 反编译下
- str_02 = "abc" + "def",指令码:3: ldc // String abcdef,得
- str_03 = str_01 + "def",指令码:invokevirtual,这个就不一样
- 1463. intern()
- 1473.3 问题图解
- 1481. 初始化
- 1492.2 扩容操作
- 1502.4 toString()
- 151六、常用API
- 152七、总结
- 153第 11 节:ThreadLocal 源码分析
- 154二、ThreadLocal 分析
- 谢飞机:嗯,ThreadLocal 要解决的是线程内资源共享 (This class provides
- thread-local variables.),所以一般会用在全链路监控中,或者是像日志框架
- 面试官:飞机不错哈,最近确实学习了。那你知道 ThreadLocal是怎样的数据结
- 面试官:那 ThreadLocal 有内存泄漏的风险,是怎么发生的呢?另外你了解在
- 二、ThreadLocal 分析
- ThreadLocal,作者:Josh Bloch and Doug Lea,两位大神👍
- 如果仅是日常业务开发来看,这是一个比较冷门的类,使用频率并不高。并且它
- 提供的方法也非常简单,一个功能只是潦潦数行代码。但,如果深挖实现部分的
- 源码,就会发现事情并不那么简单。这里涉及了太多的知识点,包括;数据结构、
- 拉链存储、斐波那契散列、神奇的 0x61c88647、弱引用 Reference、过期 key 探测清理
- 接下来,我们就逐步学习这些盲区知识。本文涉及了较多的代码和实践验证图稿,
- 欢迎关注公众号:bugstack 虫洞栈,回复下载得到一个链接打开后,找到 ID:19
- 1551.1.1 线程不安全验证
- 1561.1.2 使用 ThreadLocal 优化
- 1571.2 链路追踪
- 1.2 链路追踪
- 近几年基于谷歌 Dapper 论文实现非入侵全链路追踪,使用的越来越广了。简单
- 说这就是一套监控系统,但不需要你硬编码的方式进行监控方法,而是基于它的
- 设计方案采用 javaagent + 字节码插桩的方式,动态采集方法执行信息。如果
- 你想了解字节码插桩技术,可以阅读我的字节码编程专栏:
- https://bugstack.cn/itstack-demo-agent/itstack-demo-agent.html
- 重点,动态采集方法执行信息。这块是主要部分,跟 ThreadLocal 相关。字节码
- 插桩解决的是非入侵式编程,那么在一次服务调用时,在各个系统间以及系统内
- 多个方法的调用,都需要进行采集。这个时候就需要使用 ThreadLocal 记录方
- 法执行 ID,当然这里还有跨线程调用使用的也是增强版本的 ThreadLocal,但无
- 这里举例全链路方法调用链追踪,部分代码
- 1581.2.2 测试结果
- 1592. 数据结构
- 1603. 散列算法
- 2. Entry,这里没用再打开,其实它是一个弱引用实现,static class Entry
- extends WeakReference<ThreadLocal<?>>。这说明只要没用强引用存
- 3.数据元素采用哈希散列方式进行存储,不过这里的散列使用的是斐波那契
- 树,而是使用拉链法进行存储。也就是同一个下标位置发生冲突时,则+1 向后寻
- 3. 散列算法
- 但我们翻阅源码后,发现这个哈希计算与 HashMap 中的散列求数组下标计算的
- 3.1 神秘的数字 0x61c88647
- 讲到这里,其实计算哈希的方式,绝不止是我们平常看到 String 获取哈希值的
- 一种方式,还包括;除法散列法、平方散列法、斐波那契(Fibonacci)散列法、随机
- 而 ThreadLocal 使用的就是斐波那契(Fibonacci)散列法 + 拉链法存储数据到
- 具体来自数学公式的计算求值,公式:f(k) = ((k * 2654435769) >> X) << Y 对
- 1613.2 验证散列
- 1623.2.2 单元测试
- 1634. 源码解读
- 1644.2 设置元素
- 1654.2.2 源码分析
- 1664.3 扩容机制
- 1674.4 获取元素
- 1684.5 元素清理
- 1694.5.2 启发式清理[cleanSomeSlots]
- 170三、总结
- 171第 3 章 码农会锁(5节)
- 172二、volatile 讲解
- 1732. 加上volatile关键字
- 1743. volatile怎么保证的可见性
- 1754. 反编译解毒可见性
- 1764.2 查看汇编指令
- 从 JVM 指令码中只会发现多了,ACC_VOLATILE,并没有什么其他的点。所以,也
- 4.2 查看汇编指令
- 通过 Class 文件查看汇编,需要下载hsdis-amd64.dll 文件,复制到
- JAVA_HOME\jre\bin\server 目录下。下载资源如下:
- 另外是执行命令,包括:
- 1.基础指令:java -Xcomp -XX:+UnlockDiagnosticVMOptions -
- XX:+PrintAssembly
- 2.指定打印:-XX:CompileCommand=dontinline,类名.方法名
- 3.指定打印:-XX:CompileCommand=compileonly,类名.方法名
- 4.输出位置:> xxx
- 最终使用:java -Xcomp -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly
- 指令可以在IDEA中的 Terminal 里使用,也可以到 DOS黑窗口中使用
- 1775. 不加volatile也可见吗
- 178三、总结
- 179第 2 节:synchronized
- 1801. 对象结构
- 1811.2 验证对象结构
- 1821.2.2 指针压缩关闭
- 1831.2.3 对象头哈希值存储验证
- 1841.3 Monitor 对象
- 1852. synchronized 特性
- 源码地址:jdk8/hotspot/file/vm/runtime/objectMonitor.hpp
- ObjectMonitor,有两个队列:_WaitSet、_EntryList,用来保存
- 锁🔒执行效果如下:
- 如图 15-06,每个 Java 对象头中都包括 Monitor 对象(存储的指针的指向),
- synchronized也就是通过这一种方式获取锁,也就解释了为什么
- 2. synchronized 特性
- 2.1 原子性
- 案例代码
- 这段代码开启了 10 个线程来累加 counter,按照预期结果应该是 100000。但
- 实际运行会发现,counter 值每次运行都小于 10000,这是因为 volatile 并不
- 修改方法 add(),添加 synchronized:
- 因为 synchronized 可以保证统一时间只有一个线程能拿到锁,进入到代码块
- 1862.2 可见性
- 同步方法
- ACC_SYNCHRONIZED 这是一个同步标识,对应的 16 进制值是 0x0020
- 这 10 个线程进入这个方法时,都会判断是否有此标识,然后开始竞争 Monitor
- 同步代码
- monitorenter,在判断拥有同步标识 ACC_SYNCHRONIZED 抢先进入此方法
- 2.2 可见性
- 在上一章节 volatile 篇中,我们知道它保证变量对所有线程的可见性。最终的
- 效果就是在添加 volatile 的属性变量时,线程 A 修改值后,线程 B 使用此变量
- 这是两个线程操作一个变量的例子,因为线程间对变量 sign 的不可见性,线程
- Thread01 中的 while (!sign) 会一直执行,不会随着线程 Thread02 修改
- 现在我们给方法 add 添加 synchronized 关键字修饰,如下:
- 添加后运行结果:
- 1872.3 有序性
- 1882.4 可重入性
- 1893. 锁升级过程
- 1903.1 偏向锁
- 1913.2 轻量级锁
- 偏斜锁会延缓 JIT 预热进程,所以很多性能测试中会显式地关闭偏斜锁,偏斜
- 锁并不适合所有应用场景,撤销操作(revoke)是比较重的行为,只有当存在较
- 3.2 轻量级锁
- 当锁是偏向锁的时候,被另一个线程所访问,偏向锁就会升级为轻量级锁,其他
- 在代码进入同步块的时候,如果同步对象锁状态为无锁状态(锁标志位为“01”
- 状态,是否为偏向锁为“0”),JVM 虚拟机首先将在当前线程的栈帧中建立一个
- 名为锁记录(Lock Record)的空间,用于存储锁对象目前的 Mark Word 的拷贝,
- 3.3 自旋锁
- 自旋锁是指尝试获取锁的线程不会立即阻塞,而是采用循环的方式去尝试获取锁,
- 自旋锁的默认大小是 10 次,可以调整:-XX:PreBlockSpin
- 如果自旋 n 次失败了,就会升级为重量级的锁。重量级的锁,在 1.3 Monitor 对象
- 之前一直了解到 Java 不会进行锁降级,但最近整理了大量的资料发现锁降级
- 192四、傅诗一手
- 193第 3 节:ReentrantLock 和 公平锁
- 第 3 节:ReentrantLock 和公平锁
- 最近经常有小伙伴问我,以为我的经验来看,学多少够,好像更多的是看你的野
- 但反之我遇到一个国内大学 TOP2 毕业的娃,这货就是 Offer 收割机:腾讯、阿
- 里、字节还有国外新加坡的工作机会等等,薪资待遇也是贼高,可能超过你对白
- 一、面试题
- 谢飞机,小记,刚去冬巴拉泡完脚放松的飞机,因为耐克袜子丢了,骂骂咧咧的赴
- 谢飞机:啊。。。我没去会所呀!!!你咋知道
- 面试官:我说 Java 锁,你想啥呢!你了解公平锁吗,知道怎么实现的吗,给我
- 谢飞机:公平锁!?嗯,是不 ReentrantLock 中用到了,我怎么感觉似乎有印
- 二、ReentrantLock 和公平锁
- 1. ReentrantLock 介绍
- 鉴于上一篇小傅哥已经基于,HotSpot 虚拟机源码分析 synchronized 实现和相
- 1942. ReentrantLock 知识链条
- 相比,它更加灵活、强大、增加了轮询、超时、中断等高级功能以及可以创建公
- 2. ReentrantLock 知识链条
- ReentrantLock 是基于 Lock 实现的可重入锁,所有的 Lock 都是基于 AQS 实
- 现的,AQS 和 Condition 各自维护不同的对象,在使用 Lock 和 Condition
- 时,其实就是两个队列的互相移动。它所提供的共享锁、互斥锁都是基于对 state
- 的操作。而它的可重入是因为实现了同步器 Sync,在 Sync 的两个实现类中,
- 这个公平锁的具体实现,就是我们本章节要介绍的重点,了解什么是公平锁、公
- 平锁的具体实现。学习完基础的知识可以更好的理解 ReentrantLock
- 3. ReentrantLock 公平锁代码
- 3.1 初始化
- 1953.2 公平锁、非公平锁,选择
- 196三、什么是公平锁
- 197四、公平锁实现
- 1981.3 代码讲解
- 1992. MCSLock
- 2002.1 代码讲解
- 2013. TicketLock
- 2023.3 代码讲解
- 203二、ReentrantLock 和 AQS
- 2042. 写一个简单的 AQS 同步类
- 2052.2 单元测试
- 2063. CAS 介绍
- 2074.2 lock
- 2084.3 compareAndSetState
- 2094.4 (AQS)acquire
- 2104.6 addWaiter
- 这部分获取锁的逻辑比较简单,主要包括两部分:
- 2.如果 current == getExclusiveOwnerThread(),也就是当前线程持有
- 锁,则需要调用 setState 进行锁重入操作。setState 不需要加锁,因为是在自
- 4.6 addWaiter
- 当执行方法 addWaiter,那么就是 !tryAcquire = true,也就是
- 接下来就是把当前线程封装到 Node 节点中,加入到 FIFO 队列中。因为先进先
- 出,所以后来的队列加入到队尾
- compareAndSetTail 不一定一定成功,因为在并发场景下,可能会出现操作
- enq
- 第二次循环时,则会把当前线程的节点添加到队尾。head 节是一个无用节点,这
- 和我们做CLH实现时类似
- 2114.7 acquireQueued
- 注意,从尾节点逆向遍历
- 4.7 acquireQueued
- 当获取锁流程走到这,说明节点已经加入队列完成。看源码中接下来就是让该方
- setHead
- 在学习 CLH 公平锁数据结构中讲到 Head 节点是一个虚节点,如果当前节点的
- 前驱节点是 Head 节点,那么说明此时 Node 节点排在队列最前面,可以尝试获取
- 获取锁后设置 Head 节点,这个过程就是一个出队列过程,原来节点设置 Null 方
- shouldParkAfterFailedAcquire
- 你是否还 CANCELLED、SIGNAL、CONDITION、PROPAGATE,这四种状态,在这个
- 方法中用到了两种如下:
- 那么,以上这段代码主要的执行内容包括:
- 1.如果前一个节点状态是 SIGNAL,则返回 true。安心睡觉😪等着被叫醒
- 2124.8 parkAndCheckInterrupt
- 213第 5 节:AQS 共享锁,Semaphore、CountDownLatch
- 2142. Semaphore 共享锁使用
- AQS(AbstractQueuedSynchronizer),是 Java 并发包中非常重要的一个类,
- 大部分锁的实现也是基于 AQS 实现的,包括:
- Semaphore,信号量锁。主要用于控制流量,比如:数据库连接池给你分配10
- CountDownLatch,闭锁。Latch 门闩的意思,比如:说四个人一个漂流艇,坐
- 这一章节我们主要来介绍 Semaphore,信号量锁的实现,其实也就是介绍一个
- 2. Semaphore 共享锁使用
- 这里我们模拟了一个在高速服务区,厕所排队蹲坑的场景。由于坑位有限,为了
- 避免造成拥挤和踩踏,保安人员在门口拦着,感觉差不多,一次释放两个进去,
- 一直到都释放。你也可以想成早上坐地铁上班,或者旺季去公园,都是一批一批
- 的放行
- 测试结果
- 2153. Semaphore 源码分析
- 测试运行时,会先输出0坑、1 坑,之后 2 坑、3 坑...,每次都是这样两个,两
- 3. Semaphore 源码分析
- 3.1 构造函数
- permits:n. 许可证,特许证(尤指限期的)
- 默认情况下只需要传入 permits 许可证数量即可,也就是一次允许放行几个线
- 程。构造函数会创建非公平锁。如果你需要使用 Semaphore 共享锁中的公平锁,
- 那么可以传入第二个构造函数的参数 fair = false/true。true:FairSync,公
- 平锁。在我们前面的章节已经介绍了公平锁相关内容和实现,以及 CLH、MCS《公
- 平锁介绍》
- 初始许可证数量
- 在构造函数初始化的时候,无论是公平锁还是非公平锁,都会设置 AQS 中 state
- 3.2 acquire 获取信号量
- 2163.3 acquire 释放信号量
- semaphore.acquire()一次获取一个信号量,响应中断
- semaphore.acquire(2)
- sync.acquireSharedInterruptibly(1)。也就是相应中断,一次只占一
- 3.3 acquire 释放信号量
- semaphore.release()一次释放一个信号量
- semaphore.release(2)一次获取 n个信号量
- 有获取就得有释放,获取了几个信号量就要释放几个信号量。当然你可以尝试一
- 下,获取信号量semaphore.acquire(2)两个,释放信号量
- semaphore.release(1),看看运行效果
- 3.4 公平锁实现
- 信号量获取过程,一直到公平锁实现。 semaphore.acquire->
- sync.acquireSharedInterruptibly(permits) -> tryAcquireShared(arg)
- 2173.5 非公平锁实现
- 2183.6 获取信号量失败,加入同步等待队列
- 2194. CountDownLatch 共享锁使用
- 首先 doAcquireSharedInterruptibly 方法来自 AQS 的内部方法,与我
- addWaiter(Node.SHARED),tryAcquireShared,我们主要介绍下这内
- final boolean isShared() { return nextWaiter == SHARED; }
- tryAcquireShared,主要是来自 Semaphore 共享锁中公平锁和非公平锁的
- setHeadAndPropagate(node, r),如果 r > 0,同步成功后则将当前线程结
- shouldParkAfterFailedAcquire(p, node),调整同步队列中 node 结
- parkAndCheckInterrupt(),判断是否需要被中断,如果中断直接抛出异
- 4. CountDownLatch 共享锁使用
- CountDownLatch 也是共享锁的一种类型,之所以在这里体现下,是因为它和
- CountDownLatch 更多体现的组团一波的思想,同样是控制人数,但是需要够一
- 窝。比如:我们说过的 4 个人一起上皮划艇、两个人一起上跷跷板、2个人一起
- 测试结果
- 220三、总结
- 221第 4 章 多线程(4节)
- 第 4 章多线程(4 节)
- 第 1 节:Thread.start() 启动原理
- 刚开始听这句话还在上学,既不卓越、也不优秀,甚至可能还有点笨!但突然从
- 某次爬到班级的前几名后,开始喜欢上了这种感觉,原来前面的风景是如此灿烂
- 优秀和卓越差的不是一个等级,当你感觉自己优秀后,还能保持空瓶的心态开始,
- 是不小时候更容易学会更多的知识,但越大越笨了!人可能很容易被自己的年纪
- 大了,当成长者。却很少能保持一个低姿态谦卑的心态,不断的学习。所以最后,
- 喜欢一句话,蓝是天的颜色、红是火的象征,我不学大海抄袭天的蓝、也不学晚霞模拟火
- 的红。我就是我,生命是我的、命运是我的。健身也是你的、学习也是你的,只要你
- 一、面试题
- 面试官:那我顺便考你个题,看看你进大厂的几率大不。嗯... Java 线程如何启
- 222二、线程启动分析
- 223三、线程启动过程
- 2242. Java 层面 Thread 启动
- 2252.2 start0() 本地方法
- Causes this thread to begin execution; the Java Virtual
- Machine calls the run method of this thread. 这段话的意思
- 是:由 JVM 调用此线程的 run 方法,使线程开始执行。其实这就是一个 JVM 的
- 回调过程,下文源码分析中会讲到
- 另外 start() 是一个 synchronized 方法,但为了避免多次调用,在方法中
- start0(),是一个本地方法,通过 JNI 方式调用执行。这一步的操作才是启动
- 2.2 start0() 本地方法
- registerNatives(),这个方法是用于注册线程执行过程中需要的一些本地方
- 2263. JVM 创建线程
- 2273.2 JavaThread
- 这部分代码比较多,但核心内容主要是创建线程和启动线程,另外
- &thread_entry 也是一个方法,如下:
- thread_entry,线程入口
- 重点,在创建线程引入这个线程入口的方法时,thread_entry 中包括了 Java 的
- vmSymbols::run_method_name(),就是那个被回调的方法,源码如下:
- 源码:
- https://github.com/JetBrains/jdk8u_hotspot/blob/master/src/share/vm/
- classfile/vmSymbols.hpp
- 这个 run 就是我们的 Java 程序中会被调用的 run 方法。接下来我们继续按照
- 3.2 JavaThread
- 2283.3 os::create_thread
- 2293.4 java_start
- 2304. JVM 启动线程
- 2314.2 os::start_thread(thread)
- 源码:
- https://github.com/JetBrains/jdk8u_hotspot/blob/master/src/share/vm/
- runtime/thread.cpp
- 如果没有禁用线程 DisableStartThread 并且是 Java 线程
- os::start_thread(thread),调用线程启动方法。不同的 OS 会有不同的
- 启动代码逻辑
- 4.2 os::start_thread(thread)
- 源码:
- https://github.com/JetBrains/jdk8u_hotspot/blob/master/src/share/vm/
- runtime/os.hpp
- osthread->set_state(RUNNABLE),设置线程状态 RUNNABLE
- pd_start_thread(thread),启动线程,这个就由各个 OS 实现类,实现各
- 2324.3 pd_start_thread(thread)
- 233四、总结
- 源码:
- https://github.com/JetBrains/jdk8u_hotspot/blob/master/src/share/vm/
- runtime/thread.cpp
- thread_entry,方法最终会调用到 JavaCalls::call_virtual 里的
- vmSymbols::run_method_name()。也就是 run() 方法,至此线程启动完
- 四、总结
- Java 创建线程和启动、调用本地方法 start0()、JVM 中
- JVM_StartThread 的创建和启动、设置线程状态等待被唤醒、根据不同
- 用死记硬背。如果需要获得以上高清大图,可以添加小傅哥微信(fustack),备
- 注:Thread 大图
- 234第 2 节:Thread,状态转换、方法使用、原理分析
- 第 2 节:Thread,状态转换、方法使用、原理分析
- 大部分考试考的,基本都是不怎么用的。例外的咱们不说😄 就像你做程序开发,
- 尤其在 RPC+MQ+分库分表,其实很难出现让你用一个机器实例编写多线程压榨
- CPU 性能。很多时候是扔出一个 MQ,异步消费了。如果没有资源竞争,例如库表
- 但!凡有例外,比如你需要开发一个数据库路由中间件,那么就肯定会出现在一
- 台应用实例上分配数据库资源池的情况,如果出现竞争就要合理分配资源。如此,
- 一、面试题
- 面试官:嗯,我看你简历里写了不少线程的东西,看来了解的不错。问你一个线
- 二、Thread 状态关系
- Java 的线程状态描述在枚举类 java.lang.Thread.State 中,共包括如下五种
- 状态:
- 这五种状态描述了一个线程的生命周期,其实这种状态码的定义在我们日常的业
- 235三、Thread 状态测试
- 2364. WAITING
- 2375. TIMED_WAITING
- 2386. TERMINATED
- 6. TERMINATED
- 四、Thread 方法使用
- 一般情况下 Thread 中最常用的方法就是 start 启动,除此之外一些其他方法
- 可能在平常的开发中用的不多,但这些方法在一些框架中却经常出现。因此只了
- 解它们的概念,但是却缺少一些实例来参考!接下来我们就来做一些案例来验
- 1. yield
- yield 方法让出 CPU,但不一定,一定让出!。这种可能会用在一些同时启动的
- 线程中,按照优先级保证重要线程的执行,也可以是其他一些特殊的业务场景(例
- 为了验证这个方法,我们做一个例子:启动 50 个线程进行,每个线程都进行 1000
- 次的加和计算。其中 10 个线程会执行让出 CPU 操作。那么,如果让出 CPU 那 10
- 案例代码
- 测试结果
- 2392. wait & notify
- 2403. join
- 241五、总结
- 242第 3 节:ThreadPoolExecutor
- 243二、线程池讲解
- 2442.2 实现代码
- 2453. 线程池源码分析
- addWorker,主要是类 Worker 的具体操作,创建并执行线程。这里还包括了
- 好,那么以上呢,就是这个简单线程池实现的具体体现。但如果深思熟虑就会发
- 现这里需要很多完善,比如:线程池状态呢,不可能一直奔跑呀!?、线程池的锁呢,
- 不会有并发问题吗?、线程池拒绝后的策略呢?,这些问题都没有在主流程解决,也
- 接下来,我们就开始分析线程池的源码,与我们实现的简单线程池参考对比,会
- 3. 线程池源码分析
- 3.1 线程池类关系图
- 以围绕核心类 ThreadPoolExecutor 的实现展开的类之间实现和继承关系,如图
- 接口 Executor、ExecutorService,定义线程池的基本方法。尤其是
- ThreadPoolExecutor,是整个线程池最核心的工具类方法,所有的其他类和
- 2463.2 高3位与低29位
- 2473.2 线程池状态
- 2483.3 提交线程(execute)
- 2493.5 添加执行任务(addWorker)
- 2503.6 执行线程(runWorker)
- 添加执行任务的流程可以分为两块看,上面代码部分是用于记录线程数量、下面
- 代码部分是在独占锁里创建执行线程并启动。这部分代码在不看锁、CAS等操作,
- 那么就和我们最开始手写的线程池基本一样了
- if (rs >= SHUTDOWN &&! (rs == SHUTDOWN &&firstTask ==
- null &&! workQueue.isEmpty())),判断当前线程池状态,是否为
- SHUTDOWN、STOP、TIDYING、TERMINATED 中的一个。并且当前状态为
- compareAndIncrementWorkerCount,CAS 操作,增加线程数量,成功就会
- 3.6 执行线程(runWorker)
- 其实,有了手写线程池的基础,到这也就基本了解了,线程池在干嘛。到这最核
- 2513.7 队列获取任务(getTask)
- 252三、总结
- 253第 4 节:线程池讲解以及JVMTI监控
- 第 4 节:线程池讲解以及 JVMTI 监控
- 哈哈哈,是不你总买五常大米,其实五常和榆树是挨着的,榆树大米也好吃,榆
- 为什么提这个呢,因为阿里不允许使用 Executors 创建线程池!其他很多大厂
- 好,本篇就带你学习四种线程池的不同使用方式、业务场景应用以及如何监控线
- 一、面试题
- 谢飞机,小记!,上次从面试官那逃跑后,恶补了多线程,自己好像也内卷了,所
- 面试官:嗯,不常用确实记不住。不过你可以选择跳槽,来大厂,大厂的业务体
- 二、四种线程池使用介绍
- Executors 是创建线程池的工具类,比较典型常见的四种线程池包括:
- newFixedThreadPool、 newSingleThreadExecutor、 newCachedThreadPool、
- newScheduledThreadPool。每一种都有自己特定的典型例子,可以按照每种的特
- 1. newFixedThreadPool
- 2542. newSingleThreadExecutor
- 2553. newCachedThreadPool
- 2564. newScheduledThreadPool
- 图解
- 代码:new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L,
- TimeUnit.SECONDS, new SynchronousQueue<Runnable>())
- 介绍:首先 SynchronousQueue 是一个生产消费模式的阻塞任务队列,只要有
- 4. newScheduledThreadPool
- 图解
- 代码:public ScheduledThreadPoolExecutor(int corePoolSize)
- { super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
- new ScheduledThreadPoolExecutor.DelayedWorkQueue()); }
- 时任务。同样它也是一个无限大小的线程池 Integer.MAX_VALUE。它提供的
- 257三、线程池使用场景说明
- 调用方法比较多,包括:scheduleAtFixedRate、
- 三、线程池使用场景说明
- 说简单是当为了给老板省钱的时候,因为使用线程池可以降低服务器资源的投入,
- 所以如果说的高大上一点,那么是在符合科特尔法则和阿姆达尔定律的情况下,
- 假如:我们有一套电商服务,用户浏览商品的并发访问速率是:1000 客户/每分
- 钟,平均每个客户在服务器上的耗时 0.5 分钟。根据利特尔法则,在任何时刻,
- 服务端都承担着 1000*0.5=500 个客户的业务处理量。过段时间大促了,并发访
- 所以:在有些场景下会把串行的请求接口,压缩成并行执行,如图 22-5
- 但是,线程池的使用会随着业务场景变化而不同,如果你的业务需要大量的使用
- 因为这些线程池的创建都不够精细化,也非常容易造成 OOM 风险,而且随着业务
- 最终,大家使用的线程池都是使用 new ThreadPoolExecutor() 创建的,当然也
- 有基于 Spring 的线程池配置
- 258四、获取线程池监控信息
- 2592. 基于IVMTI方式监控
- 2602.1 先做一个监控例子
- 2612.2 扩展线程监控
- 262五、总结
- 263第 5 章 JVM 虚拟机(5节)
- 第 5 章 JVM 虚拟机(5 节)
- 第 1 节:JDK、JRE、JVM
- 😄其实小傅哥就是借着面经的幌子在讲 Java 核心技术,探索这些核心知识点面
- 想问一些面试官,是因为大家都在问所以你问,还是你想从这里问出什么?其
- 实可能很多面试官如果不了解这些技术,往往会被求职者的答案击碎内心,哈哈
- 哈哈哈哈。比如:梅森旋转算法、开放寻址、斐波那契散列、启发式清理、Javassist
- 一、面试题
- 二、Java 平台标准(JDK 8)
- Oracle has two products that implement Java Platform Standard Edition
- (Java SE) 8: Java SE Development Kit (JDK) 8 and Java SE Runtime
- JDK 8 is a superset of JRE 8, and contains everything that is in JRE
- 8, plus tools such as the compilers and debuggers necessary for
- 264三、JDK 目录结构和作用
- 265四、JDK 是什么?
- 266五、JRE 是什么?
- 267六、JVM 是什么?
- 其实简单说 JVM 就是运行 Java 字节码的虚拟机,JVM 是一种规范,各个供应
- 商都可以实现自己 JVM 虚拟机。就像小傅哥自己也按照虚拟机规范和手写 JVM
- 源码地址:https://github.com/fuzhengwei/itstack-demo-jvm
- 内容简介:本代码主要介绍如何通过 java 代码来实现 JVM 的基础功能(搜索
- 解析 class 文件、字节码命令、运行时数据区等),从而让 java 程序员通过最
- 当然,我们下载 Oracle 公司的 JVM 与自己实现的相比,要高级的多。他们的
- 另外,JVM 之所以称为虚拟机,主要就是因为它为了实现 “write-once-run-
- 1. Client 模式、Server 模式
- 修改配置模式文件:C:\Program Files\Java\jre1.8.0_45\lib\amd64\jvm.cfg
- 2682. JVM 结构和执行器
- 269第 2 节:JVM 类加载实践
- 270二、类加载过程描述
- 271三、写个代码加载下
- 2722. 代码讲解
- 2732.3 压缩包形式路径(ZipEntry)
- 2742.4 混合形式路径(CompositeEntry)
- 2752.5 通配符类型路径(WildcardEntry)
- 2762.6 类路径解析(Classpath)
- 2772.7 加载类测试验证
- 278四、解析字节码文件
- 2793. 解析版本号信息
- 2804. 解析全部内容对照
- 281五、总结
- 282第 3 节:JVM 内存模型
- 第 3 节:JVM 内存模型
- 最近看到一篇文章,30 岁有多难。文中的一些主人公好像在学业、工作、生活、
- 爱情等方面都过的都不如意。要不是错过这,要不是走错那。总结来看,就像是
- 但其实每个人可能都遇到过生活中最难的时候,或早或晚。就像我刚毕业不久时
- 一连串遇到;冬天里丢过第一部手机、修一个进了水的电脑、租的房子第一次被骗,一
- 连串下来头一次要赶在工资没发的时候,选择少吃早饭还是午饭,看看能扛过去
- 哈哈哈哈哈,现在想想还挺有意思的,不过这些乱遭的事很多是自己的意识和能
- 人那,想开车就要考驾照,想走远就要有能力。多提升认知,多拓宽眼界!生活
- 一、面试题
- 面试官:啊!?啊,那我问你,JDK 1.8 与 JDK 1.7 在运行时数据区的设计上,
- 二、 JDK1.6、JDK1.7、JDK1.8 内存模型演变
- 283三、内存模型各区域介绍
- 2842. Java虚拟机栈
- 接下来,如图 25-2 是这段代码的在虚拟机中的执行过程,左侧是它的程序计数
- 2. Java 虚拟机栈
- 这是一个关于斐波那契数列(Fibonacci sequence)求值的例子,我们通过斐波那
- 斐波那契数列(Fibonacci sequence),又称黄金分割数列、因数学家列昂纳
- 多·斐波那契(Leonardoda Fibonacci)以兔子繁殖为例子而引入,故又称为“兔
- 子数列”,指的是这样一个数列:1、1、2、3、5、8、13、21、34、……在数学
- 上,斐波纳契数列以如下被以递推的方法定义:F(1)=1,F(2)=1, F(n)=F(n-
- 1)+F(n-2)(n>=3,n∈N*)在现代物理、准晶体结构、化学等领域,斐波纳契数
- 列都有直接的应用,为此,美国数学会从 1963 年起出版了以《斐波纳契数列季
- 2853. 本地方法栈
- 2865. 常量池
- 升级 JDK 1.8 后,元空间配置参数,-XX:MetaspaceSize=512M
- XX:MaxMetaspaceSize=1024M。教你个小技巧通过 jps、jinfo查看元空间,
- 其他:关于 JDK1.8 元空间的介绍: Move part of the contents of the
- permanent generation in Hotspot to the Java heap and the remainder to
- native memory. http://openjdk.java.net/jeps/122
- 5. 常量池
- 四、手撸虚拟机(内存模型)
- 其实以上的内容,已经完整的介绍了 JVM 虚拟机的内存模型,也就是运行时数据
- 所以,这里我给大家用 Java 代码写一段关于数据槽、栈帧、局部变量、虚拟机
- 1. 工程结构
- 2872. 重点代码
- 288五、jconsole监测元空间溢出
- 2892. 调整元空间大小
- 2904.2 测试结果
- 2914.3 监控截图
- 292第 4 节:JVM 故障处理工具
- 293二、基础故障处理工具
- 2941.2 jps -l,输出当前运行类全称
- 2951.4 jps -v,输出虚拟机进程启动时JVM参数[-Xms24m -Xmx256m]
- 2962. jcmd 虚拟机诊断命令
- 2972.1 jcmd pid VM.flags,查看JVM启动参数
- 2982.5 jcmd pid Thread.print,查看线程堆栈信息
- 2992.7 jcmd pid GC.heap_dump 路径,导出heap dump文件
- 3003. jinfo Java配置信息工具
- 3. jinfo Java 配置信息工具
- 在上面讲到 jps -v 指令时,可以看到它把虚拟机启动时显式的参数列表都打印
- 出来了,但如果想更加清晰的看具体的一个参数或者想知道未被显式指定的参数
- 命令格式
- 使用方式
- 4. jstat 收集虚拟机运行数据
- jstat(JVM Statistics Monitoring Tool),用于监视虚拟机各种运行状态信
- 息。它可以查看本地或者远程虚拟机进程中,类加载、内存、垃圾收集、即时编
- 命令格式
- [protocol:][//]lvmid[@hostname[:port]/servername]
- gc 收集情况,每次查询 5次。jstat -gc 111552 1000 5
- 选项列表
- 3014.01 jstat -class,类加载统计
- 3024.04 jstat -gccapacity,堆内存统计
- 3034.06 jstat -gcnew,新生代垃圾回收统计
- 3044.08 jstat -gcoldcapacity,老年代内存统计
- 3054.11 jstat -printcompilation,JVM编译方法统计
- 3065.1 jmap,打印共享对象映射
- 3075.3 jmap -clstats,打印加载类
- 3085.4 jmap -dump,堆转储文件
- 3097. jstack Java堆栈跟踪工具
- 310三、可视化故障处理工具
- 3112. VisualVM,多合故障处理工具
- 312四、总结
- 313第 5 节:GC 垃圾回收
- 第 5 节:GC 垃圾回收
- 在这趟车上有人下、有人上,外在别人给你点评的标签、留下的烙印,都只是这
- 可能某个年龄段的你还看不懂,但如果某天你不那么忙了,要思考思考自己的路、
- 自己的脚步。看看这些是不是你想要的,如果都是你想要的,为什么你看起来不
- 一、面试题
- 面试官:是不是没有实践?只是看了就觉得会了,收藏了就表示懂了?哪哪都不
- 面试官:也没有太好的办法,学习本身就是一件枯燥的事情。减少碎片化的时间
- 浪费,多用在系统化的学习上会更好一些。哪怕你写写博客记录下,验证下也是
- 二、动手验证垃圾回收
- 没有看到实际的例子,往往就很难让理科生接受这类知识。我自己也一样,最好
- 是让我看得见。代码是对数学逻辑的具体实现,没有实现过程只看答案是没有意
- 测试代码
- 314三、JVM 垃圾回收知识框架
- 3151. 判断对象已死
- 原图下载链接:http://book.bugstack.cn/#s/6jJp2icA
- 1. 判断对象已死
- 1.1 引用计数器
- 从实现来看,引用计数器法(Reference Counting)虽然占用了一些额外的内存
- 也有一些比较出名的引用案例,比如:微软 COM(Component Object Model)技
- 但是,在主流的 Java 虚拟机中并没有选用引用技术算法来管理内存,主要是因
- 为这个简单的计数方式在处理一些相互依赖、循环引用等就会非常复杂。可能会
- 存在不再使用但又不能回收的内存,造成内存泄漏
- 1.2 可达性分析法
- Java、C#等主流语言的内存管理子系统,都是通过可达性分析(Reachability
- 它的算法思路是通过定义一系列称为 GC Roots 根对象作为起始节点集,从这
- 些节点出发,穷举该集合引用到的全部对象填充到该集合中(live set)。这个
- 3162. 垃圾回收算法
- 3172.2 标记-复制算法(mark-copy)
- 3183. 垃圾回收器
- 3193.2 老年代
- 320结尾