CMS
CMS
基于标记-清除运作过程的四个步骤
初始标记 STW 标记 GCRoots 能直接关联到的对象并发标记从GC Roots的直接关联对象开始遍历整个对象图
重新标记修正并发标记期间因为用户程序继续运行而导致标记产生变动的那一部分对象的标记记录停顿时间比并发标记短,比初始标记长
并发清除开启用户线程,同时 GC 线程开始对未标记的区域做清扫长
CMS 缺点
CMS对处理器非常敏感,处理核数量越少,对用户线程影响越大 CMS无法处理浮动垃圾,CMS和用户线程并发运行期间预留的内存不够新对象分配,导致并发失败
STW 使用 Serial Old 回收它使用的回收算法 "标记-清除" 算法会产生大量空间碎片产生
浮动垃圾是怎么样产生
CMS 的并发标记和并发清理阶段,用户线程是还在继续运行的,程序在运行自然就还会伴随有新的垃圾对象不断产生,但这一部分垃圾对象是出现在标记过程结束以后,只能下次垃圾回收处理
G1
G1 是 JDK9 后服务端模式下默认的垃圾收集器,主要针对配备多颗处理器及大容量内存的机器,它是一款能够建立起 "停顿时间模型" 的收集器 —— 当我们指定在一个长度为M毫秒的时间片段的时候,这个
垃圾收集器消耗在垃圾收集上的时间大概率不会超过 M 毫秒
怎样建立起可靠的停顿预测模型
Region 和回收集
G1仍是遵循分代收集理论,但不再坚持固定大小以及固定数量的分代区域划分,而是把堆划分为多个大小相等的区域(Region)每个 1~32M (总是2的幂次方),每一个Region都可以根据需要,
扮演不同的角色,收集器能够对扮演不同角色的 Region 采用不同的策略去处理,以达到更好的效果
每次回收不针对所有Region,将回收 Region 价值排序,根据停顿的期望值,选择Region加入回收集
四种不同Region标签
Eden、Survivor、Old、 Humongous;H区可以认为是Old区中一种特列专门用来存储大数据的当 0.5 Region <= 当对象大小 <= 1 Region 时候将数据存储到 H区;当对象大小 > 1 Region 存储
到连续的H区
毫秒的时间片段内,消耗在垃圾收集上的时间不得超过N毫秒
- 并行与并发:能充分利用多CPU、多核环境下的硬件优势;可以并行来缩短 "Stop The World" 停
顿时间,也可以并发让垃圾收集与用户程序同时进行
- 分代收集:分代概念在G1中依然得以保留,但G1不再坚持固定大小以及固定数量的分代区域划
分,改用角色不同的大小相等的Region来管理,对不同的Region采用不同的策略以达到更好的效果
Region 里面存在的跨 Region 引用对象如何解决
每个Region都有一个记忆集的实现 ——双向卡表
卡表记录了其他Region中的对象引用本Region中对象的关系,(谁引用了我的对象),它还记录了我指向谁,双向卡表结构实现比CMS实现复杂,且每个Region都有一份占用更多内存,CMS只有一份
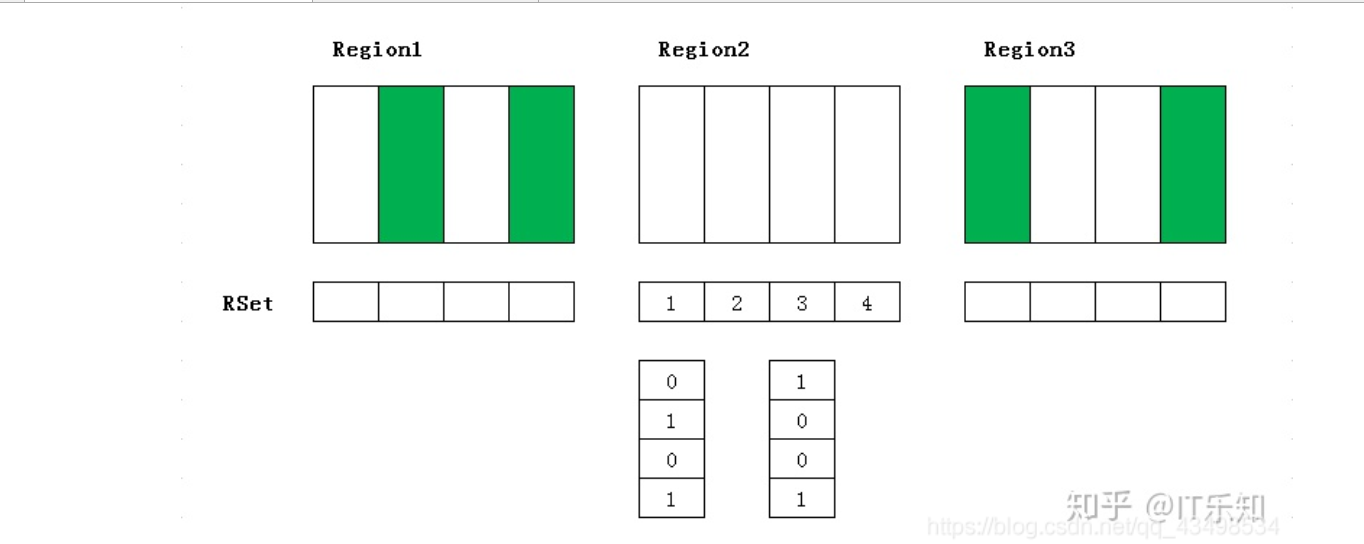
Hashtable <key,int[]> key 是我指向谁 key = Region 1 —— Region 2 指向 Region 1;int[] 中元素为1,代表 Region 1中的第 2块与第 4 块区域存在对 Region 1 的引用
在并发标记阶段如何保证收集线程与用户线程互不干扰地运行
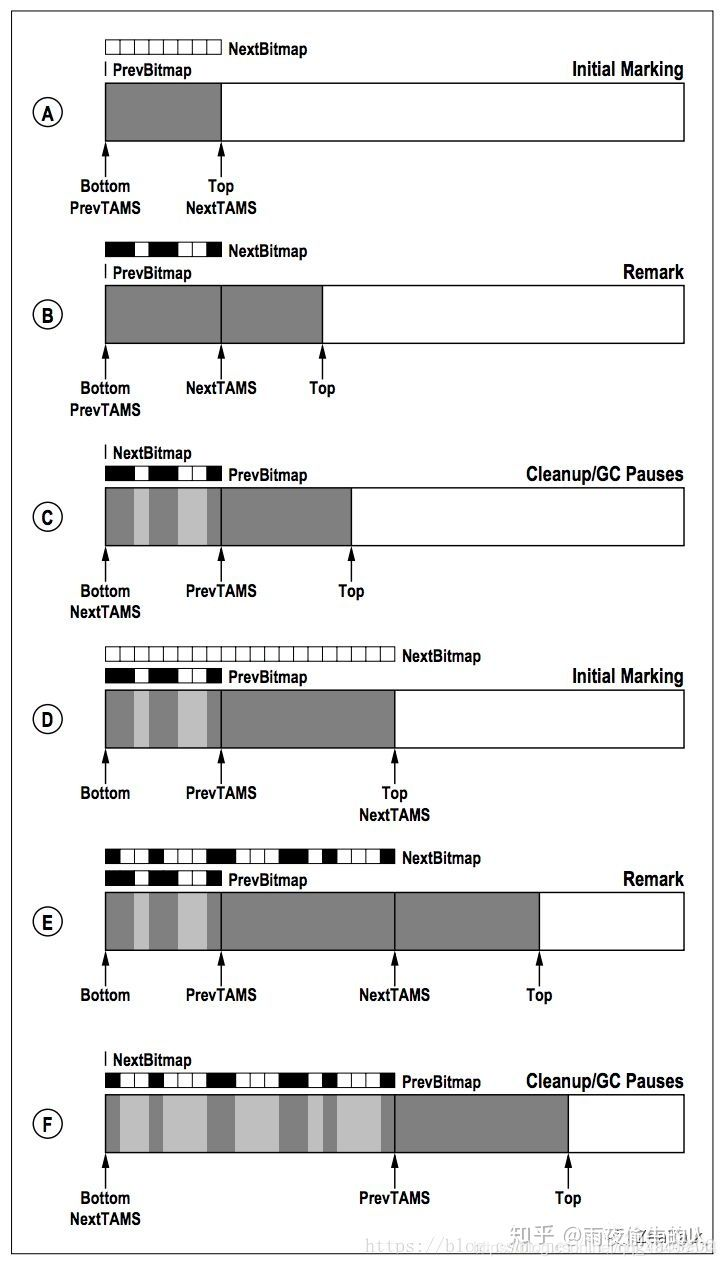
并发标记阶段,为了分配对象和垃圾回收并发执行,每个 Region 设计了两个TAMS 的指针 —— PrevTAMS、NextTAMS,在NextTAMS指针之后给新对象分配内存
G1 会把存活对象的标记存放在哪 SATB 具体是什么呢
G1 是借助 bitmap 来存放对象存活标记,每一个 bit 表示每个 Region 中的某个对象起始地址,如果 bit 标记为 1,则表示该对象存活
SATB
初始标记开始时,G1 收集器打了一个快照,形成一个所谓的对象图,这个对象图记录在 next marking bitmap 之中
并发标记阶段会在这个 bitmap 中记录对象存活标记最终标记阶段,完成对快照对象图所有标记
NextTAMS 指针之后的内容,在这一次的 GC 周期内并不关注