调度算法
针对上面的五种调度原则,总结成如下:
CPU 利用率:调度程序应确保 CPU 是始终匆忙的状态,这可提高 CPU 的利用率;
系统吞吐量:吞吐量表示的是单位时间内 CPU 完成进程的数量,长作业的进程会占用较长的 CPU 资源,因此会降低吞吐量,相反,短作业的进程会提升系统吞吐量;
周转时间:周转时间是进程运行和阻塞时间总和,一个进程的周转时间越小越好;
等待时间:这个等待时间不是阻塞状态的时间,而是进程处于就绪队列的时间,等待的时间越长,用户越不满意;
响应时间:用户提交请求到系统第一次产生响应所花费的时间,在交互式系统中,响应时间是衡量调度算法好坏的主要标准。
说白了,这么多调度原则,目的就是要使得进程要「快」。
调度算法
不同的调度算法适用的场景也是不同的。
接下来,说说在单核 CPU 系统中常见的调度算法。
01 先来先服务调度算法
最简单的一个调度算法,就是非抢占式的先来先服务(First Come First Seved, FCFS)算法了。
顾名思义,先来后到,每次从就绪队列选择最先进入队列的进程,然后一直运行,直到进程退出或被阻塞,才会继续从队列中选择第一个进程接着运行。
这似乎很公平,但是当一个长作业先运行了,那么后面的短作业等待的时间就会很长,不利于短作业。
FCFS 对长作业有利,适用于 CPU 繁忙型作业的系统,而不适用于 I/O 繁忙型作业的系统。
02 最短作业优先调度算法
最短作业优先(Shortest Job First, SJF)调度算法同样也是顾名思义,它会优先选择运行时间最短的进程来运行,这有助于提高系统的吞吐量。
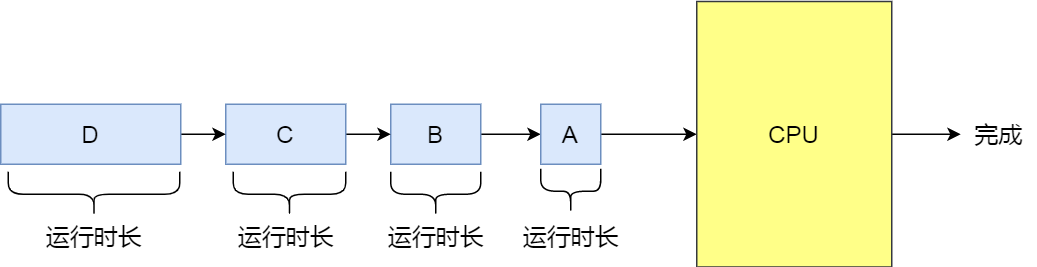
这显然对长作业不利,很容易造成一种极端现象。
比如,一个长作业在就绪队列等待运行,而这个就绪队列有非常多的短作业,那么就会使得长作业不断的往后推,周转时间变长,致使长作业长期不会被运行。
03 高响应比优先调度算法
前面的「先来先服务调度算法」和「最短作业优先调度算法」都没有很好的权衡短作业和长作业。
那么,高响应比优先(Highest Response Ratio Next, HRRN)调度算法主要是权衡了短作业和长作业。
从上面的公式,可以发现:
如果两个进程的「等待时间」相同时,「要求的服务时间」越短,「响应比」就越高,这样短作业的进程容易被选中运行;
如果两个进程「要求的服务时间」相同时,「等待时间」越长,「响应比」就越高,这就兼顾到了长作业进程,因为进程的响应比可以随时间等待的增加而提高,当其等待时间足够长时,其响应比便可
以升到很高,从而获得运行的机会;
04 时间片轮转调度算法
最古老、最简单、最公平且使用最广的算法就是时间片轮转(Round Robin, RR)调度算法。
每个进程被分配一个时间段,称为时间片(Quantum),即允许该进程在该时间段中运行。
另外,时间片的长度就是一个很关键的点:
如果时间片设得太短会导致过多的进程上下文切换,降低了 CPU 效率;
如果设得太长又可能引起对短作业进程的响应时间变长。将
一般来说,时间片设为 20ms~50ms 通常是一个比较合理的折中值。
05 最高优先级调度算法
前面的「时间片轮转算法」做了个假设,即让所有的进程同等重要,也不偏袒谁,大家的运行时间都一样。
但是,对于多用户计算机系统就有不同的看法了,它们希望调度是有优先级的,即希望调度程序能从就绪队列中选择最高优先级的进程进行运行,这称为最高优先级(Highest Priority First,HPF)调度算法。
进程的优先级可以分为,静态优先级和动态优先级:
静态优先级:创建进程时候,就已经确定了优先级了,然后整个运行时间优先级都不会变化;
动态优先级:根据进程的动态变化调整优先级,比如如果进程运行时间增加,则降低其优先级,如果进程等待时间(就绪队列的等待时间)增加,则升高其优先级,也就是随着时间的推移增加等待进程
的优先级。
该算法也有两种处理优先级高的方法,非抢占式和抢占式:
非抢占式:当就绪队列中出现优先级高的进程,运行完当前进程,再选择优先级高的进程。
抢占式:当就绪队列中出现优先级高的进程,当前进程挂起,调度优先级高的进程运行。
但是依然有缺点,可能会导致低优先级的进程永远不会运行。
06 多级反馈队列调度算法
多级反馈队列(Multilevel Feedback Queue)调度算法是「时间片轮转算法」和「最高优先级算法」的综合和发展。
顾名思义:
先级高的队列;
来看看,它是如何工作的:
设置了多个队列,赋予每个队列不同的优先级,每个队列优先级从高到低,同时优先级越高时间片越短;
新的进程会被放入到第一级队列的末尾,按先来先服务的原则排队等待被调度,如果在第一级队列规定的时间片没运行完成,则将其转入到第二级队列的末尾,以此类推,直至完成;
当较高优先级的队列为空,才调度较低优先级的队列中的进程运行。如果进程运行时,有新进程进入较高优先级的队列,则停止当前运行的进程并将其移入到原队列末尾,接着让较高优先级的进程运
行;
可以发现,对于短作业可能可以在第一级队列很快被处理完。对于长作业,如果在第一级队列处理不完,可以移入下次队列等待被执行,虽然等待的时间变长了,但是运行时间也变更长了,所以该算法很好的兼
顾了长短作业,同时有较好的响应时间。
办理业务的客户相当于进程,银行窗口工作人员相当于 CPU。
现在,假设这个银行只有一个窗口(单核 CPU),那么工作人员一次只能处理一个业务。
那么最简单的处理方式,就是先来的先处理,后面来的就乖乖排队,这就是先来先服务(FCFS)调度算法。但是万一先来的这位老哥是来贷款的,这一谈就好几个小时,一直占用着窗口,这样后面的人只能干
等,或许后面的人只是想简单的取个钱,几分钟就能搞定,却因为前面老哥办长业务而要等几个小时,你说气不气人?
有客户抱怨了,那我们就要改进,我们干脆优先给那些几分钟就能搞定的人办理业务,这就是短作业优先(SJF)调度算法。听起来不错,但是依然还是有个极端情况,万一办理短业务的人非常的多,这会导致
长业务的人一直得不到服务,万一这个长业务是个大客户,那不就捡了芝麻丢了⻄瓜
那就公平起见,现在窗口工作人员规定,每个人我只处理 10 分钟。如果 10 分钟之内处理完,就马上换下一个人。如果没处理完,依然换下一个人,但是客户自己得记住办理到哪个步骤了。这个也就是时间片轮
转(RR)调度算法。但是如果时间片设置过短,那么就会造成大量的上下文切换,增大了系统开销。如果时间片过长,相当于退化成 FCFS 算法了。
既然公平也可能存在问题,那银行就对客户分等级,分为普通客户、VIP 客户、SVIP 客户。只要高优先级的客户一来,就第一时间处理这个客户,这就是最高优先级(HPF)调度算法。但依然也会有极端的问
题,万一当天来的全是高级客户,那普通客户不是没有被服务的机会,不把普通客户当人是吗?那我们把优先级改成动态的,如果客户办理业务时间增加,则降低其优先级,如果客户等待时间增加,则升高其优
先级。
那有没有兼顾到公平和效率的方式呢?这里介绍一种算法,考虑的还算充分的,多级反馈队列(MFQ)调度算法,它是时间片轮转算法和优先级算法的综合和发展。它的工作方式:
银行设置了多个排队(就绪)队列,每个队列都有不同的优先级,各个队列优先级从高到低,同时每个队列执行时间片的长度也不同,优先级越高的时间片越短。
新客户(进程)来了,先进入第一级队列的末尾,按先来先服务原则排队等待被叫号(运行)。如果时间片用完客户的业务还没办理完成,则让客户进入到下一级队列的末尾,以此类推,直至客户业务
办理完成。
当第一级队列没人排队时,就会叫号二级队列的客户。如果客户办理业务过程中,有新的客户加入到较高优先级的队列,那么此时办理中的客户需要停止办理,回到原队列的末尾等待再次叫号,因为要
把窗口让给刚进入较高优先级队列的客户。
可以发现,对于要办理短业务的客户来说,可以很快的轮到并解决。对于要办理长业务的客户,一下子解决不了,就可以放到下一个队列,虽然等待的时间稍微变长了,但是轮到自己的办理时间也变长了,也可
全站分卷索引 · 208 卷
- 1勘误事宜
- 2图灵机的工作方式
- 3冯诺依曼模型
- 4内存
- 5总线
- 6程序执行的基本过程
- 7a = 1 + 2 执行具体过程
- 8指令
- 9指令的类型
- 10指令的执行速度
- 11总结
- 12关注作者
- 13存储器的层次结构
- 14寄存器
- 15L1 高速缓存
- 16L2 高速缓存
- 17存储器的层次关系
- 18存储器之间的实际价格和性能差距
- 19总结
- 20关注作者
- 21CPU Cache 有多快?
- 22CPU Cache 的数据结构和读取过程是什么样的?
- 23如何写出让 CPU 跑得更快的代码?
- 24如何提升指令缓存的命中率?
- 25如果提升多核 CPU 的缓存命中率?
- 26总结
- 271.4 CPU 缓存一致性
- 28CPU Cache 的数据写入
- 29写直达
- 30写回
- 31缓存一致性问题
- 32总线嗅探
- 33总结
- 34关注作者
- 351.5 CPU 是如何执行任务的?
- 36CPU 如何读写数据的?
- 37分析伪共享的问题
- 38避免伪共享的方法
- 39CPU 如何选择线程的?
- 40调度类
- 41CPU 运行队列
- 42调整优先级
- 43总结
- 441.6 软中断
- 45中断是什么?
- 46系统里有哪些软中断?
- 47如何定位软中断 CPU 使用率过高的问题?
- 48总结
- 49关注作者
- 501.7 为什么 0.1 + 0.2 不等于 0.3 ?
- 51十进制小数与二进制的转换
- 52计算机是怎么存小数的?
- 530.1 + 0.2 == 0.3 ?
- 54总结
- 55二、操作系统结构
- 56Linux 的设计
- 57SMP
- 58Monolithic Kernel
- 59Windows 设计
- 60总结
- 61关注作者
- 62虚拟内存
- 63内存分段
- 64内存分页
- 65多级页表
- 66TLB
- 67段页式内存管理
- 68Linux 内存管理
- 69总总结结
- 70四、进程与线程
- 71进程
- 72进程的状态
- 73进程的控制结构
- 74进程的控制
- 75进程的上下文切换
- 76线程
- 77什么是线程?
- 78线程与进程的比较
- 79线程的实现
- 80调度
- 81调度原则
- 82调度算法
- 83关注作者
- 84管道
- 85消息队列
- 86信号量
- 87信号
- 88Socket
- 89总结
- 90关注作者
- 914.3 多线程同步
- 92竞争与协作
- 93互斥的概念
- 94同步的概念
- 95互斥与同步的实现和使用
- 96锁
- 97信号量
- 98生产者-消费者问题
- 99经典同步问题
- 100哲学家就餐问题
- 101读者-写者问题
- 102关注作者
- 1034.4 死锁
- 104持有并等待条件
- 105环路等待条件
- 106利用工具排查死锁问题
- 107避免死锁问题的发生
- 108总结
- 1094.5 悲观锁与乐观锁
- 110互斥锁与自旋锁:谁更轻松自如?
- 111读写锁:读和写还有优先级区分?
- 112乐观锁与悲观锁:做事的心态有何不同?
- 113总结
- 114五、调度算法
- 115进程调度算法
- 116先来先服务调度算法
- 117最短作业优先调度算法
- 118时间片轮转调度算法
- 119最高优先级调度算法
- 120内存页面置换算法
- 121最佳页面置换算法
- 122最近最久未使用的置换算法
- 123时钟页面置换算法
- 124最不常用算法
- 125先来先服务
- 126扫描算法
- 127循环扫描算法
- 128LOOK 与 C-LOOK算法
- 129关注作者
- 130六、 文件系统
- 131文件系统的基本组成
- 132虚拟文件系统
- 133文件的使用
- 134文件的存储
- 135非连续空间存放方式
- 136Unix 文件的实现方式
- 137空闲空间管理
- 138空闲链表法
- 139位图法
- 140目录的存储
- 141软链接和硬链接
- 142文件 I/O
- 143直接与非直接 I/O
- 144关注作者
- 1457.1 键盘敲入A 字母时,操作系统期间发生了什么?
- 146I/O 控制方式
- 147设备驱动程序
- 148通用块层
- 149存储系统 I/O 软件分层
- 150键盘敲入字母时,期间发生了什么?
- 151关注作者
- 152Linux 网络协议栈
- 153Linux 接收网络包的流程
- 154Linux 发送网络包的流程
- 1558.2 零拷贝
- 156为什么要有 DMA 技术?
- 157传统的文件传输有多糟糕?
- 158如何优化文件传输的性能?
- 159如何实现零拷贝?
- 160sendfile
- 161使用零拷贝技术的项目
- 162PageCache 有什么作用?
- 163大文件传输用什么方式实现?
- 164总结
- 1658.3 I/O 多路复用:select/poll/epoll
- 166最基本的 Socket 模型
- 167如何服务更多的用户?
- 168多进程模型
- 169多线程模型
- 170I/O 多路复用
- 171select/poll
- 172epoll
- 173总结
- 174关注作者
- 175演进
- 176Reactor
- 177单 Reactor 多线程 / 多进程
- 178多 Reactor 多进程 / 线程
- 179Proactor
- 180总结
- 181关注作者
- 182九、Linux 命令
- 183性能指标有哪些?
- 184网络配置如何看?
- 185socket 信息如何查看?
- 186网络吞吐率和 PPS 如何查看?
- 187连通性和延时如何查看?
- 188关注作者
- 189别急着开始
- 190慎用 cat
- 191PV 分析
- 192UV 分析
- 193UV 分组
- 194终端分析
- 195分析 TOP3 的请求
- 196关注作者
- 197十、学习心得
- 19810.1 计算机网络怎么学?
- 199入门系列
- 200深入学习系列
- 201实战系列
- 202最后
- 20310.2 操作系统怎么学?
- 204入门系列
- 205深入学习系列
- 206最后
- 207十一、画图经验
- 208赞赏支持