1.3、查询调优
(3)写入过程中:采取 bulk 批量写入;
(4)写入后恢复副本数和刷新间隔;
(5)尽量使用自动生成的 id。
1.3、查询调优
(1)禁用 wildcard;
(2)禁用批量 terms(成百上千的场景);
(3)充分利用倒排索引机制,能 keyword 类型尽量 keyword;
(4)数据量大时候,可以先基于时间敲定索引再检索;
(5)设置合理的路由机制。
1.4、其他调优
部署调优,业务调优等。
上面的提及一部分,面试者就基本对你之前的实践或者运维经验有所评估了。
2、elasticsearch 的倒排索引是什么
面试官:想了解你对基础概念的认知。
解答:通俗解释一下就可以。
传统的我们的检索是通过文章,逐个遍历找到对应关键词的位置。
而倒排索引,是通过分词策略,形成了词和文章的映射关系表,这种词典+映射表即为倒排索引。有了倒排索引,就能实现 o(1)时间复杂度的效率检索文章了,极大的提高了检索效率。
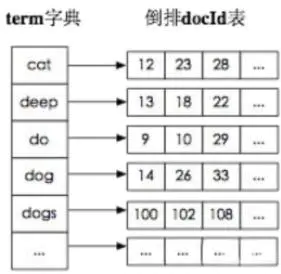
学术的解答方式:
倒排索引,相反于一篇文章包含了哪些词,它从词出发,记载了这个词在哪些文档中出现过,由两部分