2、详细描述一下 Elasticsearch 搜索的过程。
2、详细描述一下 Elasticsearch 搜索的过程。
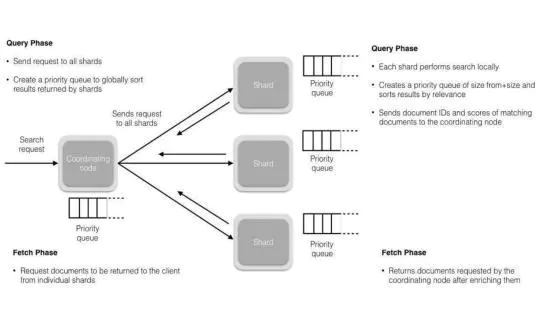
(2)在初始查询阶段时,查询会广播到索引中每一个分片拷贝(主分片或者副本分片)。每个分片在本地执行搜索并构建一个匹配文档的大小为 from + size 的优先队列。
PS:在搜索的时候是会查询 Filesystem Cache 的,但是有部分数据还在 MemoryBuffer,所以搜索是近实时的。
(3)每个分片返回各自优先队列中所有文档的 ID 和排序值给协调节点,它合并这些值到自己的优先队列中来产生一个全局排序后的结果列表。
(4)接下来就是取回阶段,协调节点辨别出哪些文档需要被取回并向相关的分片提交多个 GET 请求。
每个分片加载并丰富文档,如果有需要的话,接着返回文档给协调节点。一旦所有的文档都被取回了,协调节点返回结果给客户端。
(5)补充:Query Then Fetch 的搜索类型在文档相关性打分的时候参考的是本分片的数据,这样在文档数量较少的时候可能不够准确,DFS Query Then Fetch 增加了一个预查询的处理,询问 Term 和
Document frequency,这个评分更准确,但是性能会变差。*
3、在 Elasticsearch 中,是怎么根据一个词找到对应的倒排索引
的?
(1)Lucene的索引过程,就是按照全文检索的基本过程,将倒排表写成此文件格式的过程。
(2)Lucene的搜索过程,就是按照此文件格式将索引进去的信息读出来,然后计算每篇文档打分 (score)的过程。
4、Elasticsearch 在部署时,对 Linux 的设置有哪些优化方法?
(1)64 GB 内存的机器是非常理想的,但是 32 GB 和 16 GB 机器也是很常见的。少于 8 GB 会适得其反。
(2)如果你要在更快的 CPUs 和更多的核心之间选择,选择更多的核心更好。多个内核提供的额外并发远胜过稍微快一点点的时钟频率。