侵入式和非侵入式的区别
nil
interface常见问题:
接口就是一种约定
接口分为侵入式和非侵入式,类必须明确表示自己实现了某个接口
侵入式和非侵入式的区别
1、侵入式:
你的代码里已经嵌入了别的代码,这些代码可能是你引入过的框架,也可能是你通过接口继承得来的,比如:java 中的继承,必须显示的表明我要继承那个接口,这样你就可以拥有侵入代码的一些功能。所以我们就称这段代码是
侵入式代码。
优点:
通过侵入代码与你的代码结合可以更好的利用侵入代码提供给的功能。
缺点:
框架外代码就不能使用了,不利于代码复用。依赖太多重构代码太痛苦了。
2、非侵入式(没有依赖,自主研发):
正好与侵入式相反,你的代码没有引入别的包或框架,完完全全是自主开发。比如go中的接口,不需要显示的继承接口,只需要实现接口的所有方法就叫实现了该接口,即便该接口删掉了,也不会影响我,所有go语言的接口数非
侵入式接口;再如Python所崇尚的鸭子类型。
优点:
代码可复用,方便移植。非侵入式也体现了代码的设计原则:高内聚,低耦合
缺点:
无法复用框架提供的代码和功能
简述GMP模型和它的优点
GMP模型中:
G表示goroutine
M表示Thread
P表示Processor:Processor包含了运行goroutine所需要的资源,如果线程想要运行goroutine则必须要先获取processor,P中还包含了可运行的G队列,其中线程是执行goroutine的实体,processor的功能是把
goroutine调度到工作线程上去执行
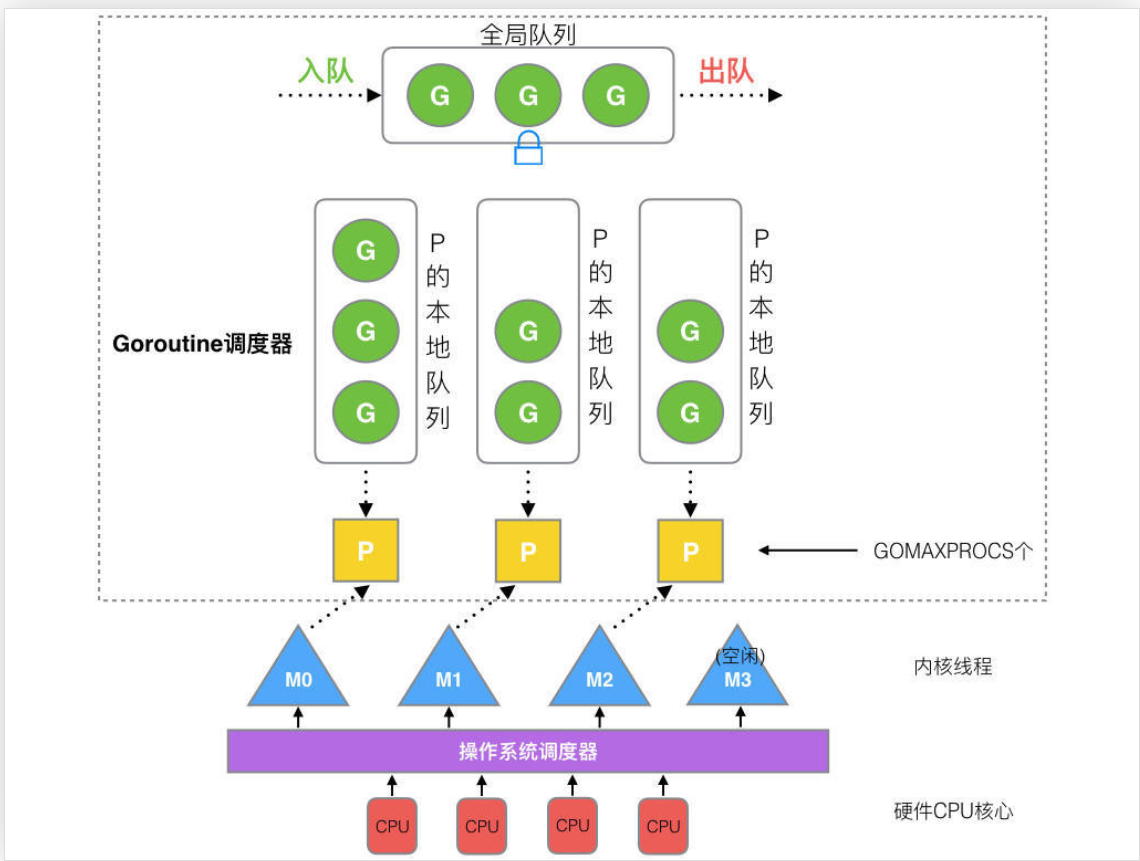
GMP模型中有如下几种结构:
全局队列:存放等待运行的G P的本地队列:每个P所拥有的队列,也是存放等待运行的G,有最大个数的限制,新创建一个G优先加入到P
的本地队列中,如果本地队列已满就放入全局队列中顺便将本地队列中一半的P放到全局队列 P:所有的P都在程序启动时即创建,并保存在一个数组中,最多有GOMAXPROCS个
M:线程想要运行G就得获取P,优先从P的本地队列中获取,如果P的本地队列为空,就会尝试从全局队列中拿一批G放入本地队列,或者从其他的P中偷一半放到自己P的本地队列中
GMP模型的优点
复用线程:避免频繁的创建销毁线程
work stealing策略:当本线程绑定的P本地队列中无可运行的G时,会尝试从其他P那里偷G来运行,而不是销毁本线程
hand off机制:当本线程因为执行某个G发生系统调用而阻塞时,会将绑定的P释放,将P转移给其他空闲的M去执行
多核并行:GOMAXPROCS设置P的数量,因此最多可有这么多个线程分布在多个cpu上同时执行
抢占:在其他协程中要等待一个协程主动让出cpu才会让下一个协程执行,而go中一个goroutine最多占用 cpu10ms,防止其他goroutine被饿死
全局队列:当work stealing策略失效时,会从全局队列中获取G来执行
全站分卷索引 · 29 卷
- 1代码随想录知识星球精华(最强八股文)第五版(Go篇))
- 2Go string 和 []byte 的区别
- 3数组和切片的区别
- 4扩容前后的Slice是一样的吗
- 5Go语言map是有序的还是无序的, 为什么
- 6go里面的map是并发安全的吗?如何并发安全
- 7Go 的错误处理和 Java 的异常处理对比
- 8介绍一下panic和recover
- 9什么是defer?有什么作用
- 10Go并发
- 11进程、线程的区别
- 12什么是go runtine
- 13Go语言中的Channel是什么, 有哪些用途,如何处理阻塞
- 14什么是互斥锁(mutex)?在什么情况下会用到它们?
- 15Mutex有几种模式
- 16goroutine什么情况会发生内存泄漏?如何避免。
- 17Go语言中GC的流程是什么
- 18Go 中的内存逃逸现象是什么?
- 19CAP 理论,为什么不能同时满足
- 20说一下 Gin 的路由怎么实现的
- 21简述slice的底层原理,和数组的区别是什么
- 22defer底层原理
- 23侵入式和非侵入式的区别
- 24goroutine与线程的区别
- 25goroutine在什么情况下会被挂起呢?
- 26GC(垃圾回收)原理 1.5版本
- 27简述Go的垃圾回收机制
- 28协程优势及其通信方式
- 29Go的内存对齐