长轮询
而消费者各种各样,身为 Broker 不应该有依赖于消费者的倾向,我已经为你保存好消息了,你要就来拿好了。
虽说一般而言 Broker 不会成为瓶颈,因为消费端有业务消耗比较慢,但是 Broker 毕竟是一个中心点,能轻量就尽量轻量。
那么竟然 RocketMQ 和 Kafka 都选择了拉模式,它们就不怕拉模式的缺点么?怕,所以它们操作了一波,减轻了拉模式的缺点。
长轮询
RocketMQ 和 Kafka 都是利用“长轮询”来实现拉模式,我们就来看看它们是如何操作的。
为了简单化,下面我把消息不满足本次拉取的条数啊、总大小啊等等都统一描述成还没有消息,反正都是不满足条件。
RocketMQ 中的长轮询
RocketMQ 中的 PushConsumer 其实是披着拉模式的方法,只是看起来像推模式而已。
因为 RocketMQ 在被背后偷偷的帮我们去 Broker 请求数据了。
后台会有个 RebalanceService 线程,这个线程会根据 topic 的队列数量和当前消费组的消费者个数做负载均衡,每个队列产生的 pullRequest 放入阻塞队列 pullRequestQueue 中。然后又有个
PullMessageService 线程不断的从阻塞队列 pullRequestQueue 中获取 pullRequest,然后通过网络请求 broker,这样实现的准实时拉取消息。
这一部分代码我不截了,就是这么个事儿,稍后会用图来展示。
然后 Broker 的 PullMessageProcessor 里面的 processRequest 方法是用来处理拉消息请求的,有消息就直接返回,如果没有消息怎么办呢?我们来看一下代码。
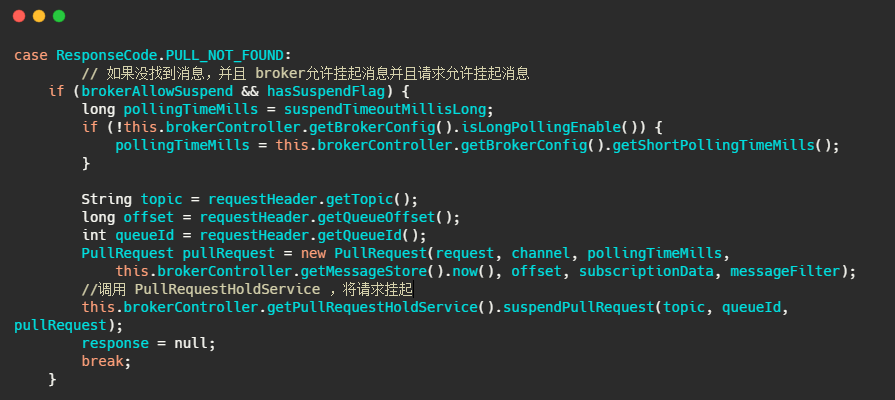
我们再来看下 suspendPullRequest 方法做了什么。
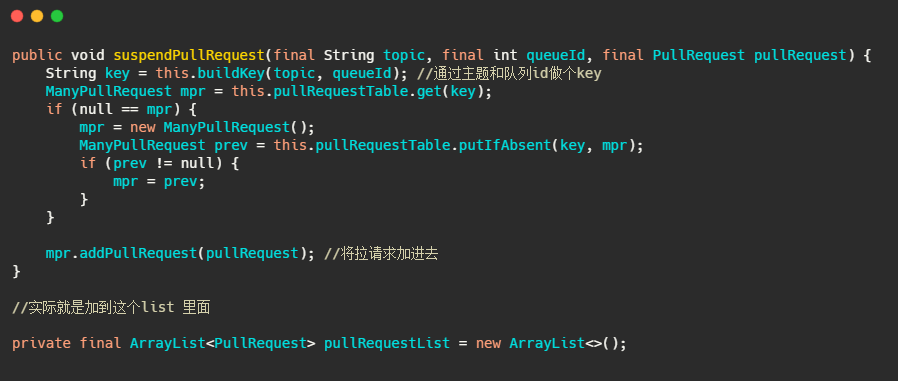
而 PullRequestHoldService 这个线程会每 5 秒从 pullRequestTable 取PullRequest请求,然后看看待拉取消息请求的偏移量是否小于当前消费队列最大偏移量,如果条件成立则说明有新消息了,则会调用
notifyMessageArriving,最终调用 PullMessageProcessor 的 executeRequestWhenWakeup() 方法重新尝试处理这个消息的请求,也就是再来一次,整个长轮询的时间默认 30 秒。
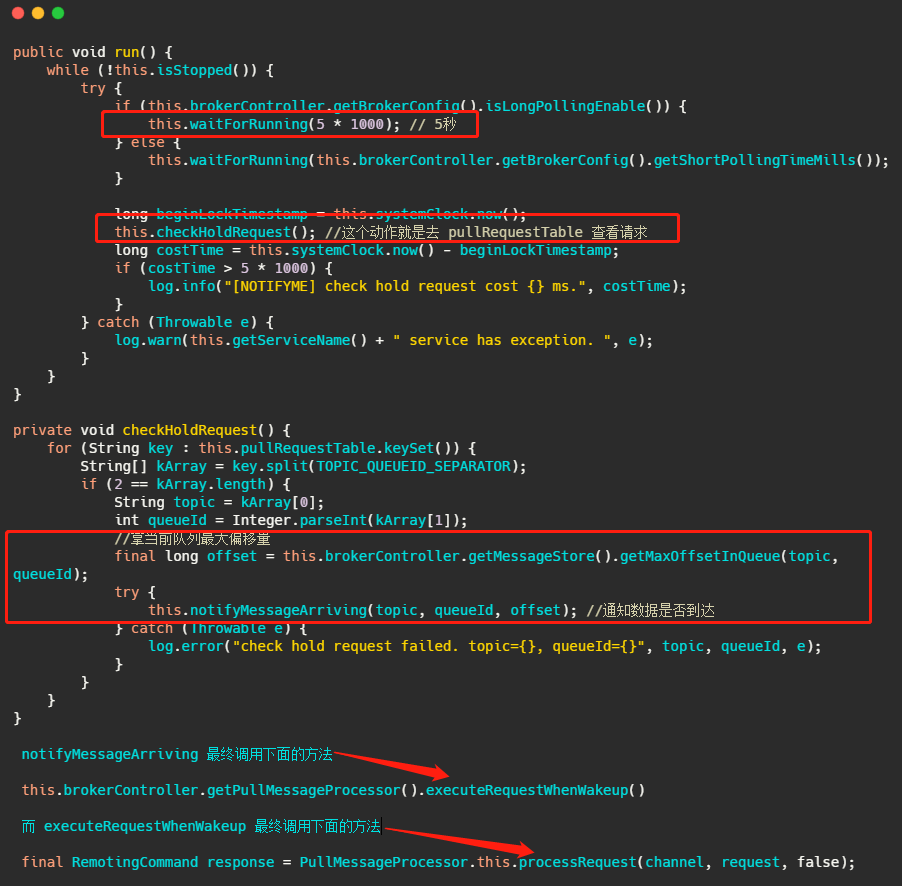
简单的说就是 5 秒会检查一次消息时候到了,如果到了则调用 processRequest 再处理一次。这好像不太实时啊? 5秒?
全站分卷索引 · 73 卷
- 1什么是消息队列
- 2服务解耦
- 3注意
- 4小结一下
- 5如何保证消息不丢失
- 6存储消息
- 7如果处理重复消息
- 8如何保证消息的有序性
- 9最后
- 10正确的回答姿势
- 11小结一下面试技巧
- 12面试官想问的是什么
- 13消息队列设计成推消息还是拉消息?RocketMQ和Kafka是怎么做的?
- 14拉模式
- 15长轮询
- 16Kafka 中的长轮询
- 17小结一下
- 18消息队列之事务消息?RocketMQ和Kafka是怎么做的?
- 19分布式事务
- 20RocketMQ 事务消息
- 21RocketMQ 事务消息源码分析
- 22Kafka 事务消息
- 23最后
- 24那 qmq 怎么做的呢?
- 25再来看 RocketMQ 和 QMQ
- 26最后
- 27Kafka 系列
- 28entrySize
- 29从Kafka的索引冷热分区到MySQL InnoDB的缓冲池管理
- 30Kafka日志段如何读写解析?
- 31以下为日志的定义
- 32日志段的读取
- 33情景剧
- 34简单说下ZooKeeper
- 35Controller 底层事件模型
- 36LeaderAndIsrRequest
- 37Controller选举流程源码分析
- 38ControllerEventManager:事件处理器
- 39KafkaController#process
- 40ControllerContext:元数据
- 41最后
- 42Reactor模式
- 43Kafka Broker 网络通信模型
- 44源码级别剖析网络通信模型
- 45请求处理优先级
- 46Kafka为什么要抛弃Zookeeper?
- 47那为什么要抛弃 ZooKeeper
- 48所以没了 Zookeeper 之后的 Kafka 的怎样的?
- 49最后
- 50RocketMQ 整体架构设计
- 51NameServer
- 52Producer 发消息流程
- 53自动创建主题的弊端
- 54Broker 的存储
- 55消息刷盘机制
- 56文件预分配和文件预热
- 57Consumer
- 58一些注意点
- 59Linux内核参数
- 60Kafka和RocketMQ底层存储揭秘,为什么能这么快?
- 61sendfile-零拷贝
- 62RocketMQ 和 Kafka 的应用
- 63文件预分配
- 64RocketMQ 小结
- 65RocketMQ & Kafka 对比
- 66番外篇:定时任务的终极实现--时间轮,在Netty和Kafka中如何应用的?为什么不用Timer、延时线程池?
- 67小结一下
- 68小结一下
- 69小结一下
- 70Netty中的时间轮
- 71小结一下
- 72小结一下
- 73总结