Kafka 系列
Kafka 系列
Kafka的索引设计有什么亮点?
其实这篇文章只是从Kafka索引入手,来讲述算法在工程上基于场景的灵活运用。单单是因为看源码的时候有感而写之。
索引的重要性
索引对于我们来说并不陌生,每一本书籍的目录就是索引在现实生活中的应用。通过寥寥几页纸就得以让我等快速查找需要的内容。冗余了几页纸,缩短了查阅的时间。空间和时间上的互换,包含着宇宙的
哲学。
工程领域上数据库的索引更是不可或缺,没有索引很难想象如此庞大的数据该如何检索。
明确了索引的重要性,咱再来看看索引在Kafka里是如何实现的。
索引在Kafka中的实践
首先Kafka的索引是稀疏索引,这样可以避免索引文件占用过多的内存,从而可以在内存中保存更多的索引。对应的就是Broker 端参数log.index.interval.bytes 值,默认4KB,即4KB的消息建一条索
引。
Kafka中有三大类索引:位移索引、时间戳索引和已中止事务索引。分别对应了.index、.timeindex、.txnindex文件。
与之相关的源码如下:
1、AbstractIndex.scala:抽象类,封装了所有索引的公共操作
2、OffsetIndex.scala:位移索引,保存了位移值和对应磁盘物理位置的关系
3、TimeIndex.scala:时间戳索引,保存了时间戳和对应位移值的关系
4、TransactionIndex.scala:事务索引,启用Kafka事务之后才会出现这个索引(本文暂不涉及事务相关内容)
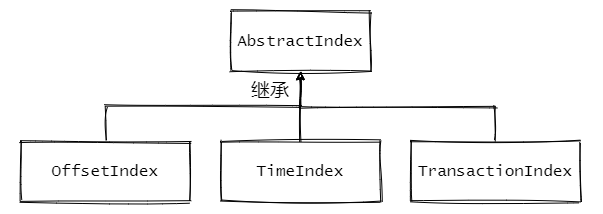
先来看看AbstractIndex的定义
全站分卷索引 · 73 卷
- 1什么是消息队列
- 2服务解耦
- 3注意
- 4小结一下
- 5如何保证消息不丢失
- 6存储消息
- 7如果处理重复消息
- 8如何保证消息的有序性
- 9最后
- 10正确的回答姿势
- 11小结一下面试技巧
- 12面试官想问的是什么
- 13消息队列设计成推消息还是拉消息?RocketMQ和Kafka是怎么做的?
- 14拉模式
- 15长轮询
- 16Kafka 中的长轮询
- 17小结一下
- 18消息队列之事务消息?RocketMQ和Kafka是怎么做的?
- 19分布式事务
- 20RocketMQ 事务消息
- 21RocketMQ 事务消息源码分析
- 22Kafka 事务消息
- 23最后
- 24那 qmq 怎么做的呢?
- 25再来看 RocketMQ 和 QMQ
- 26最后
- 27Kafka 系列
- 28entrySize
- 29从Kafka的索引冷热分区到MySQL InnoDB的缓冲池管理
- 30Kafka日志段如何读写解析?
- 31以下为日志的定义
- 32日志段的读取
- 33情景剧
- 34简单说下ZooKeeper
- 35Controller 底层事件模型
- 36LeaderAndIsrRequest
- 37Controller选举流程源码分析
- 38ControllerEventManager:事件处理器
- 39KafkaController#process
- 40ControllerContext:元数据
- 41最后
- 42Reactor模式
- 43Kafka Broker 网络通信模型
- 44源码级别剖析网络通信模型
- 45请求处理优先级
- 46Kafka为什么要抛弃Zookeeper?
- 47那为什么要抛弃 ZooKeeper
- 48所以没了 Zookeeper 之后的 Kafka 的怎样的?
- 49最后
- 50RocketMQ 整体架构设计
- 51NameServer
- 52Producer 发消息流程
- 53自动创建主题的弊端
- 54Broker 的存储
- 55消息刷盘机制
- 56文件预分配和文件预热
- 57Consumer
- 58一些注意点
- 59Linux内核参数
- 60Kafka和RocketMQ底层存储揭秘,为什么能这么快?
- 61sendfile-零拷贝
- 62RocketMQ 和 Kafka 的应用
- 63文件预分配
- 64RocketMQ 小结
- 65RocketMQ & Kafka 对比
- 66番外篇:定时任务的终极实现--时间轮,在Netty和Kafka中如何应用的?为什么不用Timer、延时线程池?
- 67小结一下
- 68小结一下
- 69小结一下
- 70Netty中的时间轮
- 71小结一下
- 72小结一下
- 73总结