entrySize
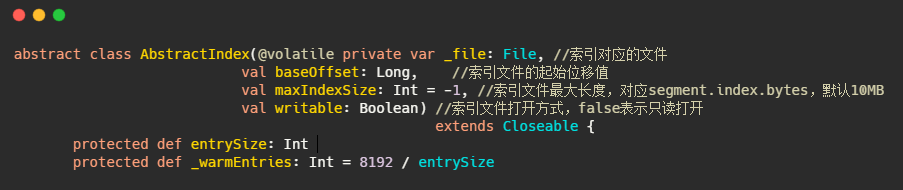
AbstractIndex的定义在代码里已经注释了,成员变量里面还有个entrySize。这个变量其实是每个索引项的大小,每个索引项的大小是固定的。
entrySize
在OffsetIndex中是override def entrySize = 8,8个字节。
在TimeIndex中是override def entrySize = 12,12个字节。
为何是8 和12?
在OffsetIndex中,每个索引项存储了位移值和对应的磁盘物理位置,因此4+4=8,但是不对啊,磁盘物理位置是整型没问题,但是AbstractIndex的定义baseOffset来看,位移值是长整型,不是因为8个
字节么?
因此存储的位移值实际上是相对位移值,即真实位移值-baseOffset的值。
相对位移用整型存储够么?够,因为一个日志段文件大小的参数log.segment.bytes是整型,因此同一个日志段对应的index文件上的位移值-baseOffset的值的差值肯定在整型的范围内。
为什么要这么麻烦,还要存个差值?
1、为了节省空间,一个索引项节省了4字节,想想那些日消息处理数万亿的公司。
2、因为内存资源是很宝贵的,索引项越短,内存中能存储的索引项就越多,索引项多了直接命中的概率就高了。这其实和MySQL InnoDB 为何建议主键不宜过长一样。每个辅助索引都会存储主键的值,主
键越长,每条索引项占用的内存就越大,缓存页一次从磁盘获取的索引数就越少,一次查询需要访问磁盘次数就可能变多。而磁盘访问我们都知道,很慢。
互相转化的源码如下,就这么个简单的操作:
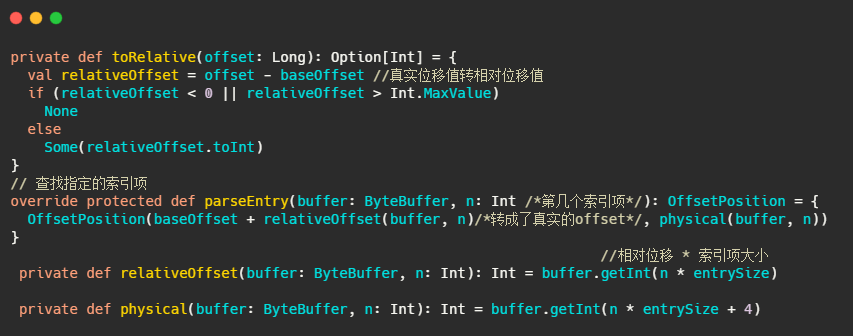
上述解释了位移值是4字节,因此TimeIndex中时间戳8个字节 + 位移值4字节 = 12字节。
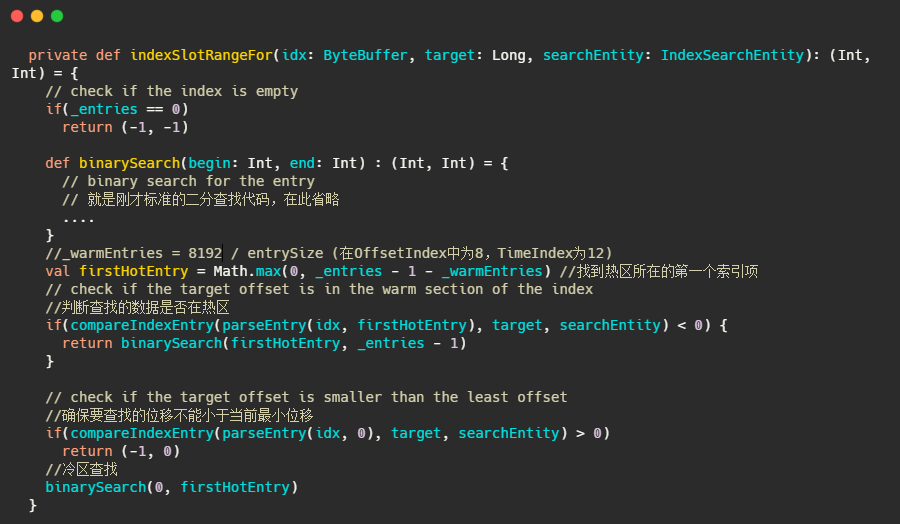
_warmEntries
这个是干什么用的?
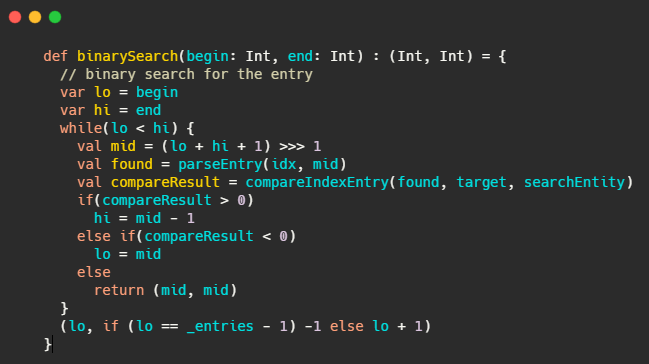
这和_warmEntries有什么关系?首先想想二分有什么问题?
就Kafka而言,索引是在文件末尾追加的写入的,并且一般写入的数据立马就会被读取。所以数据的热点集中在尾部。并且操作系统基本上都是用页为单位缓存和管理内存的,内存又是有限的,因此会通过
类LRU机制淘汰内存。
看起来LRU非常适合Kafka的场景,但是使用标准的二分查找会有缺页中断的情况,毕竟二分是跳着访问的。
这里要说一下kafka的注释写的是真的清晰,咱们来看看注释怎么说的
when looking up index, the standard binary search algorithm is not cache friendly, and can cause unnecessary
page faults (the thread is blocked to wait for reading some index entries from hard disk, as those entries are not
cached in the page cache)
翻译下:当我们查找索引的时候,标准的二分查找对缓存不友好,可能会造成不必要的缺页中断(线程被阻塞等待从磁盘加载没有被缓存到page cache 的数据)
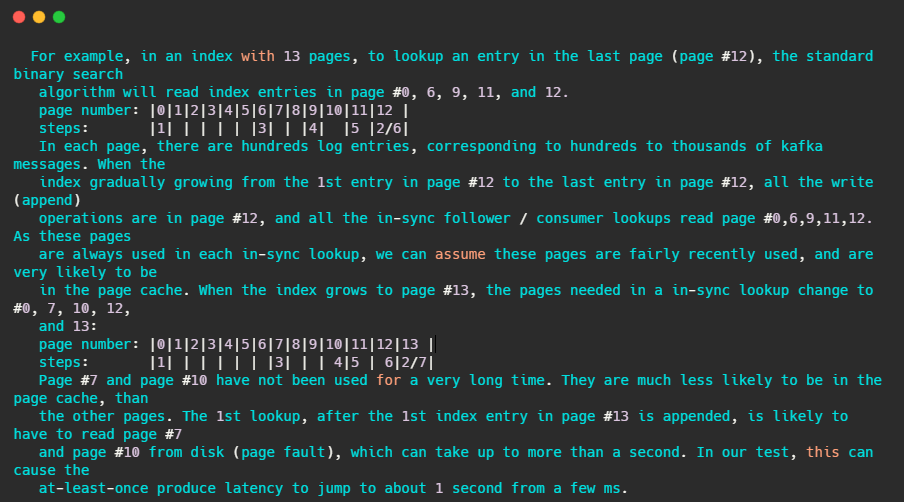
简单的来讲,假设某索引占page cache 13页,此时数据已经写到了12页。按照kafka访问的特性,此时访问的数据都在第12页,因此二分查找的特性,此时缓存页的访问顺序依次是0,6,9,11,12。因为
频繁被访问,所以这几页一定存在page cache中。
当第12页不断被填充,满了之后会申请新页第13页保存索引项,而按照二分查找的特性,此时缓存页的访问顺序依次是:0,7,10,12。这7和10很久没被访问到了,很可能已经不再缓存中了,然后需要从
磁盘上读取数据。注释说:在他们的测试中,这会导致至少会产生从几毫秒跳到1秒的延迟。
基于以上问题,Kafka使用了改进版的二分查找,改的不是二分查找的内部,而且把所有索引项分为热区和冷区
这个改进可以让查询热数据部分时,遍历的Page永远是固定的,这样能避免缺页中断。
看到这里其实我想到了一致性hash,一致性hash相对于普通的hash不就是在node新增的时候缓存的访问固定,或者只需要迁移少部分数据。
好了,让我们先看看源码是如何做的
全站分卷索引 · 73 卷
- 1什么是消息队列
- 2服务解耦
- 3注意
- 4小结一下
- 5如何保证消息不丢失
- 6存储消息
- 7如果处理重复消息
- 8如何保证消息的有序性
- 9最后
- 10正确的回答姿势
- 11小结一下面试技巧
- 12面试官想问的是什么
- 13消息队列设计成推消息还是拉消息?RocketMQ和Kafka是怎么做的?
- 14拉模式
- 15长轮询
- 16Kafka 中的长轮询
- 17小结一下
- 18消息队列之事务消息?RocketMQ和Kafka是怎么做的?
- 19分布式事务
- 20RocketMQ 事务消息
- 21RocketMQ 事务消息源码分析
- 22Kafka 事务消息
- 23最后
- 24那 qmq 怎么做的呢?
- 25再来看 RocketMQ 和 QMQ
- 26最后
- 27Kafka 系列
- 28entrySize
- 29从Kafka的索引冷热分区到MySQL InnoDB的缓冲池管理
- 30Kafka日志段如何读写解析?
- 31以下为日志的定义
- 32日志段的读取
- 33情景剧
- 34简单说下ZooKeeper
- 35Controller 底层事件模型
- 36LeaderAndIsrRequest
- 37Controller选举流程源码分析
- 38ControllerEventManager:事件处理器
- 39KafkaController#process
- 40ControllerContext:元数据
- 41最后
- 42Reactor模式
- 43Kafka Broker 网络通信模型
- 44源码级别剖析网络通信模型
- 45请求处理优先级
- 46Kafka为什么要抛弃Zookeeper?
- 47那为什么要抛弃 ZooKeeper
- 48所以没了 Zookeeper 之后的 Kafka 的怎样的?
- 49最后
- 50RocketMQ 整体架构设计
- 51NameServer
- 52Producer 发消息流程
- 53自动创建主题的弊端
- 54Broker 的存储
- 55消息刷盘机制
- 56文件预分配和文件预热
- 57Consumer
- 58一些注意点
- 59Linux内核参数
- 60Kafka和RocketMQ底层存储揭秘,为什么能这么快?
- 61sendfile-零拷贝
- 62RocketMQ 和 Kafka 的应用
- 63文件预分配
- 64RocketMQ 小结
- 65RocketMQ & Kafka 对比
- 66番外篇:定时任务的终极实现--时间轮,在Netty和Kafka中如何应用的?为什么不用Timer、延时线程池?
- 67小结一下
- 68小结一下
- 69小结一下
- 70Netty中的时间轮
- 71小结一下
- 72小结一下
- 73总结