再来看 RocketMQ 和 QMQ
orderDao.insert(order);
//封装插入消息、发送消息、删除消息的逻辑 producer.sendMessage(buildMessage(order));
}
如果消息发送失败,也就是比如 mq 集群挂了,并不会影响事务的执行,业务的执行和事务消息的插入都已经成功了,那此时待消息已经安安静静的在消息库里等着,后台能会有一个补偿任务,会将这些消
息捞出来重新发送,直到发送成功。
想必,现在你应该对 qmq 的事务消息流程应该很清晰了,它的顺序就属于先写数据库,再发mq,即使 mq 集群挂了,也不会影响事务的进行,不会导致应用无法正常执行了。
这里可能有人会问,那如果 mysql 挂了呢?
我只能说数据库都挂了,那就都没了,别想啥别的了。
再来看 RocketMQ 和 QMQ
至此,想必你已经清楚 RocketMQ 和 QMQ 事务消息的区别,我们再来盘下 QMQ 事务消息更优的原因。
RocketMQ 只支持单事务消息,也就是无法在一个事务内发送多种事务消息。
而 QMQ 可以在一次事务中发多个消息,来看下伪代码:
@Transactional // 在一个事务中 public void yes(){
Order order = buildOrder();
orderDao.insert(order);
producer.sendMessage(buildMessageA(order));
producer.sendMessage(buildMessageB(order));
producer.sendMessage(buildMessageC(order));
}
这样的实现就比 RocketMQ 灵活多了。
然后 RocketMQ 事务消息的实现还需要提供一个反查机制,因为RocketMQ 事务消息的提交是 oneway 的发送方式,有可能 Broker 没有接收到事务提交的消息,所以 Broker 会定时去生产者那边查看事务是
否已经执行完成,因此生产者需要保存本地事务执行结果,简单的就是用一个 map 保存,让 Broker 可以通过消息的事务 id 查找到事务执行的结果。
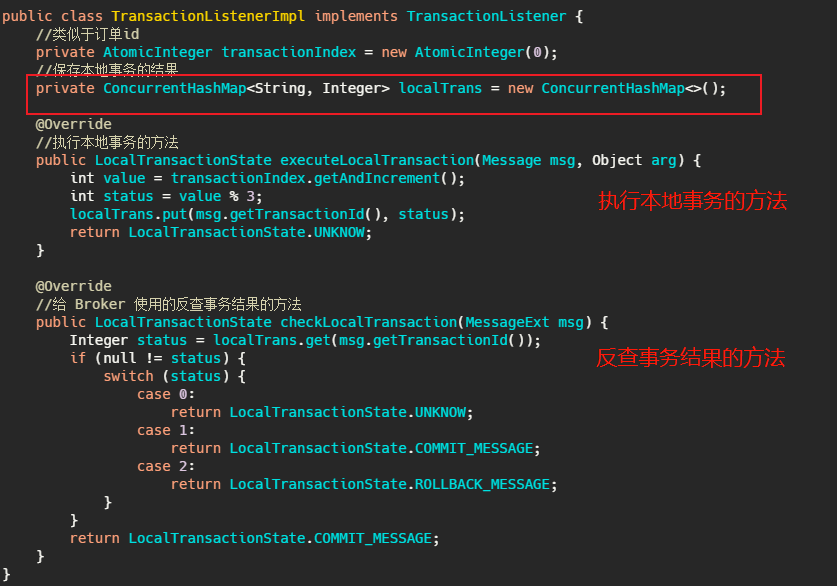
如果还要考虑发送事务消息的生产者挂了,那么 Broker 会找同个生产组的其他生产者来查询事务结果,所以这个存储还得提出来放到第三方,而不是本地内存保存。
因此,RocketMQ 得多维护一个本地事务执行结果,是稍微有点麻烦的。
当然,QMQ 还得建表呢,不过按照 QMQ 说的:如果公司方便的话,可以直接合并进DBA的初始化数据库的自动化流程中,这样就透明了。
还有一点 RocketMQ 的 api 不太友好,改造有点大,之后的迁移不太方便。
全站分卷索引 · 73 卷
- 1什么是消息队列
- 2服务解耦
- 3注意
- 4小结一下
- 5如何保证消息不丢失
- 6存储消息
- 7如果处理重复消息
- 8如何保证消息的有序性
- 9最后
- 10正确的回答姿势
- 11小结一下面试技巧
- 12面试官想问的是什么
- 13消息队列设计成推消息还是拉消息?RocketMQ和Kafka是怎么做的?
- 14拉模式
- 15长轮询
- 16Kafka 中的长轮询
- 17小结一下
- 18消息队列之事务消息?RocketMQ和Kafka是怎么做的?
- 19分布式事务
- 20RocketMQ 事务消息
- 21RocketMQ 事务消息源码分析
- 22Kafka 事务消息
- 23最后
- 24那 qmq 怎么做的呢?
- 25再来看 RocketMQ 和 QMQ
- 26最后
- 27Kafka 系列
- 28entrySize
- 29从Kafka的索引冷热分区到MySQL InnoDB的缓冲池管理
- 30Kafka日志段如何读写解析?
- 31以下为日志的定义
- 32日志段的读取
- 33情景剧
- 34简单说下ZooKeeper
- 35Controller 底层事件模型
- 36LeaderAndIsrRequest
- 37Controller选举流程源码分析
- 38ControllerEventManager:事件处理器
- 39KafkaController#process
- 40ControllerContext:元数据
- 41最后
- 42Reactor模式
- 43Kafka Broker 网络通信模型
- 44源码级别剖析网络通信模型
- 45请求处理优先级
- 46Kafka为什么要抛弃Zookeeper?
- 47那为什么要抛弃 ZooKeeper
- 48所以没了 Zookeeper 之后的 Kafka 的怎样的?
- 49最后
- 50RocketMQ 整体架构设计
- 51NameServer
- 52Producer 发消息流程
- 53自动创建主题的弊端
- 54Broker 的存储
- 55消息刷盘机制
- 56文件预分配和文件预热
- 57Consumer
- 58一些注意点
- 59Linux内核参数
- 60Kafka和RocketMQ底层存储揭秘,为什么能这么快?
- 61sendfile-零拷贝
- 62RocketMQ 和 Kafka 的应用
- 63文件预分配
- 64RocketMQ 小结
- 65RocketMQ & Kafka 对比
- 66番外篇:定时任务的终极实现--时间轮,在Netty和Kafka中如何应用的?为什么不用Timer、延时线程池?
- 67小结一下
- 68小结一下
- 69小结一下
- 70Netty中的时间轮
- 71小结一下
- 72小结一下
- 73总结