第4章 用Claude和通义等分析Excel数据
第4章
用Claude和通义等分析Excel数据
许多人在工作中都难以从大型Excel数据表中提炼关键数据。举个例子,当领导要求你从一个包含40多个部门互相有应收款项和应付款项记录的Excel表中,列出应
收款项最大的3个部门时,你可能会感到为难,因为找公司IT部门帮忙需要漫长等待。但现在有了氛围编程,解决这个问题就很轻松。通过本章的学习,你将学会如
何仅使用中文对话让通义生成一段Python代码,在半小时内完成这项任务。
4.1 需求分析
这个找出应收款项最大的3个部门的例子来自我的亲身经历。为了便于编入书中,我对需求进行了简化和脱敏处理,但依然保留了真实场景的核心特点。
假设你在未来交通设计院工作。一天,领导交给你一项任务:汇总该院41个部门之间的应收应付款项。这些款项源于部门间的人员借调(例如,当部门1借调部门2的
设计师来完成项目时,这位设计师在借调期间的工时费就成为部门2应收部门1的款项,同时也是部门1应付部门2的款项),你需要从中找出应收款项排名前三的部
门。
这个看似简单的需求实际上涉及大量数据处理。将所有信息整理成Excel表(参见本书配套代码中的ch04-tongyi/未来交通设计院部门对账表.xlsx文件,这个文件
中的所有内容都是我让大模型虚构的)后,会形成一个41列(对应各部门)、82行(对应每个部门的应收和应付款)的表格,总计3000多个数据点。即使只关注应收
款项,也需要从约1500个数据中筛选出前三名,如图4-1所示。
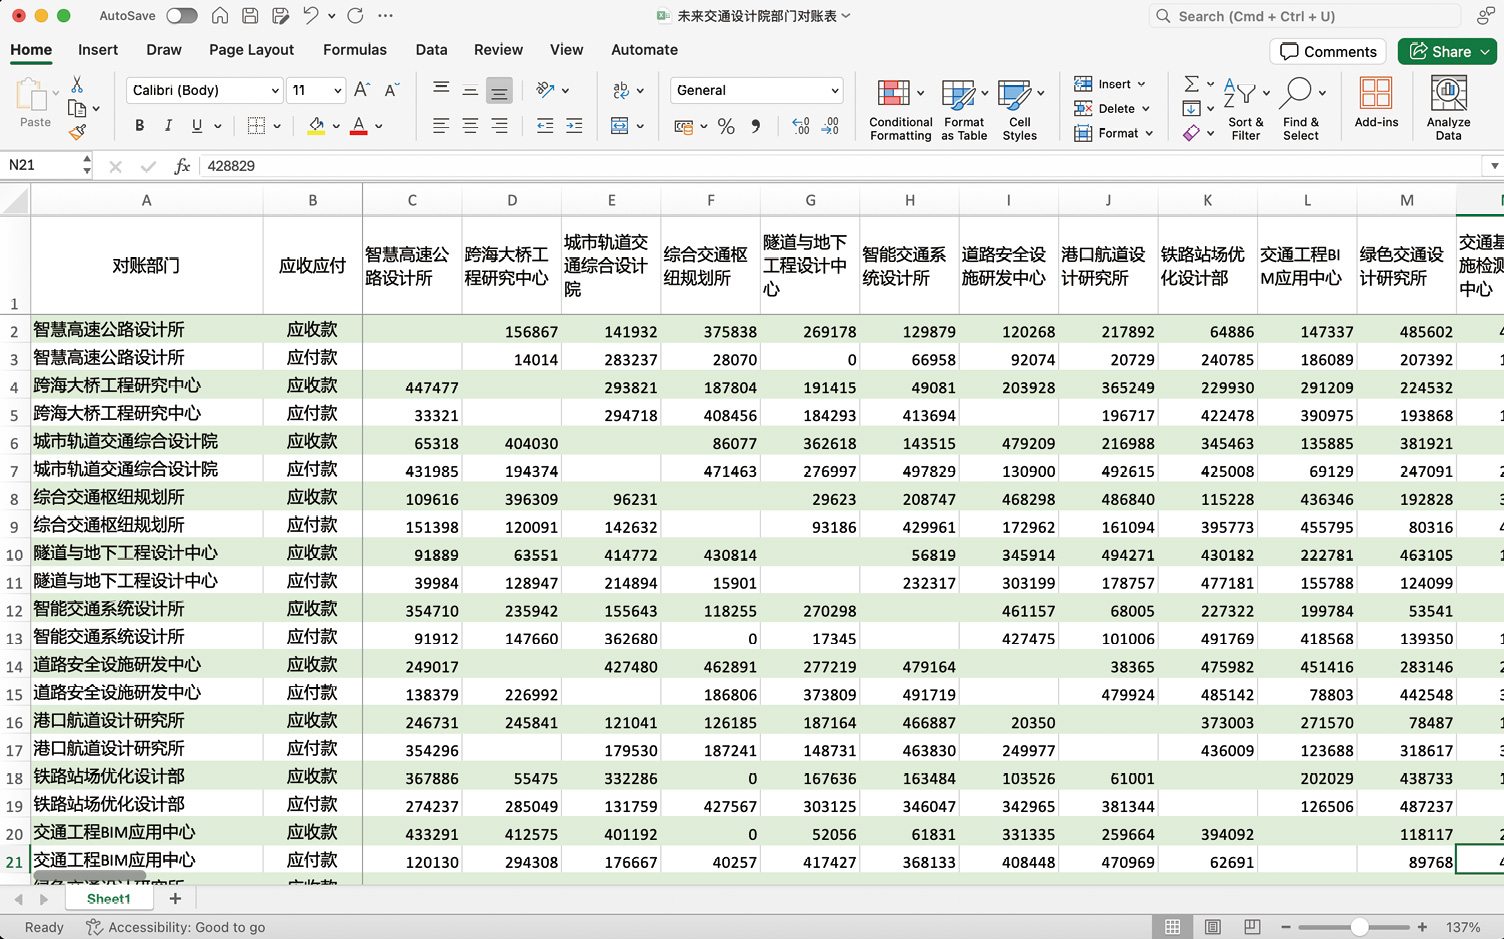
图4-1 未来交通设计院41个部门的对账表
由于公司的敏感信息不能外泄,如果要使用DeepSeek智能聊天应用等外网AI应用,需要先对数据进行脱敏处理。
回顾本节描述的需求,这个数据分析实战项目恰好适合使用Python来解决。下一步就是选择合适的氛围编程工具并搭配合理的大模型。根据1.7节中的氛围编程大模
型升级指导原则,作为一名Python新手,我需要选择能力与口碑更强的氛围编程工具与大模型组合,因此我选择了Claude。
4.2 用Claude分析Excel数据
确定使用Claude后,我需要解决数据脱敏的问题。我仿照图4-1,用手工方式制作了一个数据表,表内的所有数据(包括部门名称)都是脱敏后的假数据。这样做有
两个好处:既可以安心地将脱敏数据上传给大模型来生成Python代码,同时生成的代码也能在本地计算机上处理真实数据,避免了敏感信息通过外网泄露的风险。脱
敏后的数据(参见本书配套代码中的ch04-tongyi/部门对账表-脱敏-样例.xlsx文件)如图4-2所示。
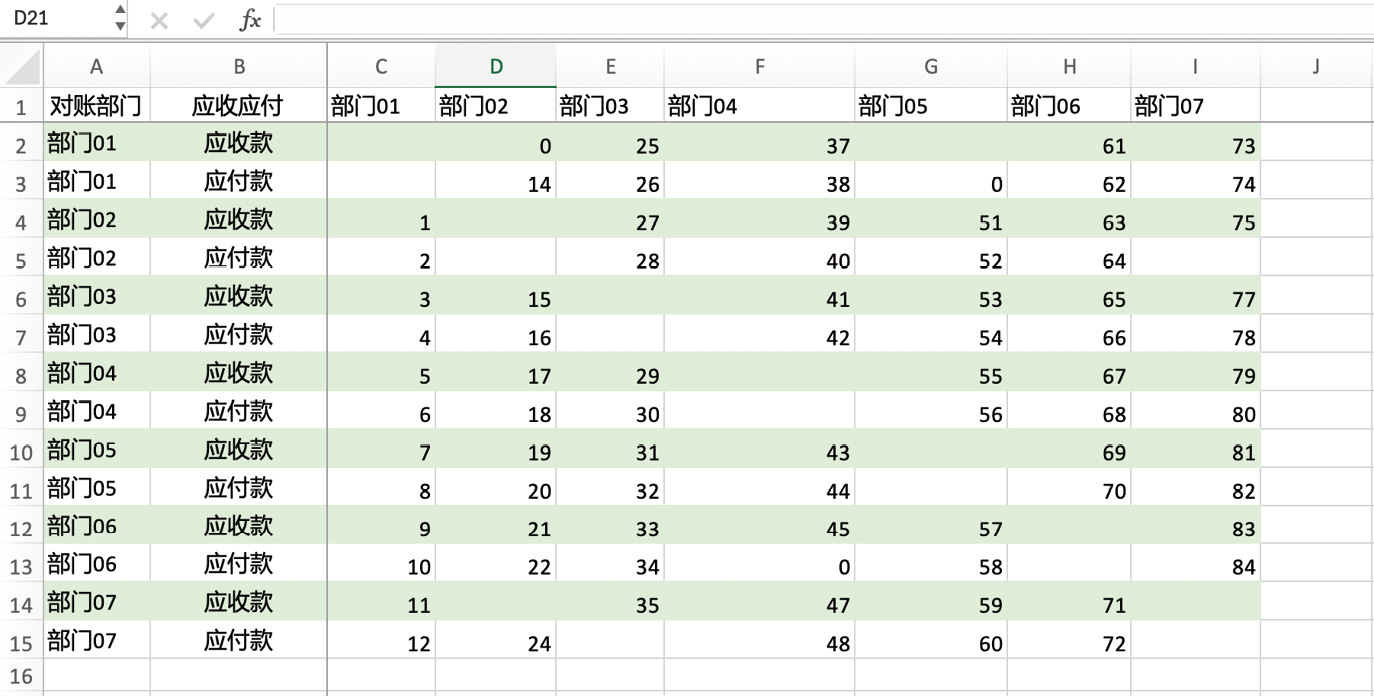
图4-2 脱敏后的数据
准备好脱敏数据后,我打开Claude桌面应用,搭配Claude Sonnet 4大模型,可以不用开启“Extended thinking”模式,上传“部门对账表-脱敏-样例.xlsx”文
件,并提交了代码清单4-1所示的提示词。
代码清单4-1 listings/L4-1.md
请编写Python代码分析我上传的Excel表中的数据。这张表是某企业各部门申报的应收和应付其他部门款项的对账表。示例:部门01申报应收部门02为0元,应付部门02为14元。我需要你只关注“应收款”,按
金额从大到小排序,列出排名前三的相关部门和应收款项。输出格式如下:
- 部门06应收部门07.83元
- 部门05应收部门07.81元
- 部门04应收部门07.79元
说明:请忽略表中的空白单元格,这些要么是相同部门交叉的无效数据,要么是尚未申报的数据。
另外,请提供在macOS系统上的运行指南README,并说明创建和使用Python虚拟环境的具体命令。
Claude迅速生成了Python代码和README文档。我首先在“部门对账表-脱敏-样例.xlsx”文件所在目录下创建了子目录“claude-with-sonnet-4”,然后将
的说明,在macOS系统上执行以下命令:
# 在当前目录下创建本项目的Python虚拟环境,
# 以便与个人计算机的操作系统下的Python环境隔离
python3 -m venv receivable_env
# 激活虚拟环境
source receivable_env/bin/activate
# 在虚拟环境中安装本项目代码运行时需要的依赖包
pip install pandas openpyxl
# 运行本项目代码
python3 analyze_receivables.py ../部门对账表-脱敏-样例.xlsx
可以按键盘上的窗口键(一般在键帽上印有微软的品牌标识图标),然后在弹出的输入框中输入“cmd”,即打开Windows的命令提示符终端。

如果在Windows命令提示符(CMD)终端中运行,则使用以下命令:
# 在当前目录下创建本项目的Python虚拟环境,
# 以便与个人计算机的操作系统下的Python环境隔离
python -m venv receivable_env
# 激活虚拟环境
receivable_env\Scripts\activate
# 在虚拟环境中安装本项目代码运行时需要的依赖包
pip install pandas openpyxl
# 运行本项目代码
应收款项排名前三的部门。接下来,我对真实数据表运行命令:
python3 analyze_receivables.py ../未来交通设计院部门对账表.xlsx 出乎意料,程序运行时出现了错误:
正在分析文件: ../未来交通设计院部门对账表.xlsx 识别到的部门: []
没有找到有效的应收款数据
于是,我用以下提示词让Claude修复这个问题:
程序存在局限性。当我把部门名称的格式从“部门0x”改为其他格式(如“智慧高速公路设计所”)时,运行Python代码会显示:“识别到的部门: []
没有找到有效的应收款数据”。请修复这个问题。
Claude回复指出代码中存在“部门”前缀被硬编码的问题,并迅速提供了修复方案。我用修复后的代码(参见本书配套代码中的ch04-tongyi/claude-with-
sonnet-4/analyzie_ receivables.py文件)重新分析真实数据表,成功显示出应收款项最大的3个部门。
分析完成后,我使用以下命令退出Python虚拟环境:
deactivate 完成了Claude上的实战项目后,可以根据1.7节中的氛围编程大模型降级指导原则在免费的通义上复现这个项目。这会使目前无法使用Claude的读者也能通
过氛围编程完成类似的任务。
4.3 用通义分析Excel数据
“通义”是阿里目前的AI聊天应用的名字。之前的名字是“通义千问”。
“通义千问”是阿里在2023年9月首次发布的大语言模型和配套AI聊天应用的品牌名。2024年5月,阿里将“通义千问”应用(即本书中提到的通义聊天应
用)更名为“通义”,而“通义千问大模型”则简称为“Qwen”(千问)。
通义是阿里巴巴集团旗下阿里云开发的AI聊天应用,具备人机交互、问答和协作创作等功能,其搭配的大模型(名为Tongyi Qianwen,简称Qwen)于2023年4月
开始面向企业用户进行定向测试,并于同年9月13日正式向公众开放。2025年4月29 日,阿里自研的大模型Qwen3(千问3)宣布开源,推出了8款不同规模的大模型版
本。截至本书撰写时,阿里已开源超过200个大模型,全球下载量突破3亿次。

词输入框左上角开启“深度思考”,通过左下角的上传按钮()导入“部门对账表-脱敏-样例.xlsx”文件。完成这些准备工作后,在提示词输入框中输入代码
清单4-2所示的内容。
代码清单4-2 listings/L4-2.md
请编写Python代码分析上传的Excel表中的数据。该表是企业内部各部门申报的应收应付对账表。例如:
部门01申报应收部门02为0元,应付部门02为14元。我需要分析“应收款”数据,按金额降序排列,输出排名前三的相关部门和应收款项。输出格式如下:
- 部门06应收部门07.83元
- 部门05应收部门07.81元
- 部门04应收部门07.79元
说明:表中的空白单元格(包括相同部门交叉处的无效数据和未申报数据)将被忽略。
另外,请提供macOS系统的运行指南README,包含Python虚拟环境的创建和使用命令。代码应具有部门名称识别的灵活性,使其在部门名称格式改变时(如从“部门0x”变为“智慧高速公路设计所”)仍能正常
工作。
吸取了之前使用Claude时的经验教训,我特意在提示词中加入了“具有部门名称识别的灵活性”的要求,如图4-3所示。
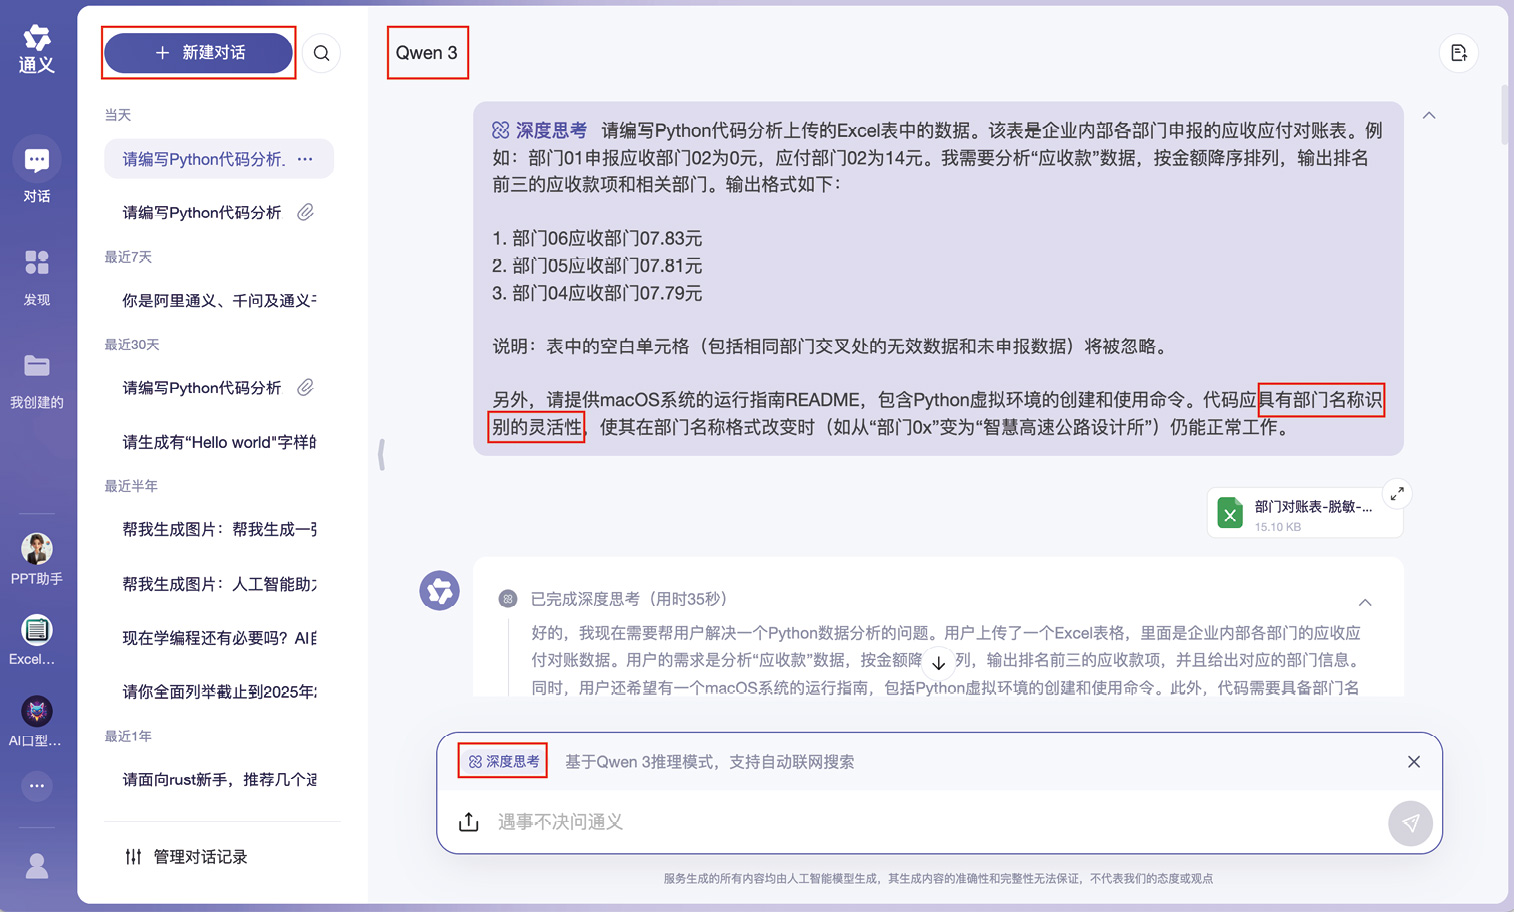
图4-3 用通义生成分析Excel数据的Python代码
通义迅速生成了Python代码和运行指南,但当我按照指南操作时却遇到了错误:
FileNotFoundError: [Errno 2] No such file or directory: '对账表.xlsx'
查看代码后发现,通义生成的程序将数据文件名硬编码为“对账表.xlsx”,而没有使用命令行中提供的参数。因此,我用以下提示词追问:
请修改代码,让它能从命令行参数获取要处理的文件名。例如,运行“python3 analyze_ receivables.py ../部门对账表-脱敏-样例.xlsx”时,程序应处理“../部门对账表-脱敏-样例.xlsx”
文件。
通义生成的修改版代码运行良好。无论处理脱敏数据表还是实际数据表,程序都能准确输出排名结果。
为了帮助习惯使用其他氛围编程工具的读者完成本章的实战项目,我还使用多种不同的氛围编程工具进行了Excel数据分析。
4.4 用其他氛围编程工具分析Excel数据效果对比
DeepSeek-R1大模型(开启深度思考)并上传脱敏数据表后,提交代码清单4-2所示的提示词,首次对话就能获得可靠的Python代码,成功列出脱敏和真实数据表中排
名前三的部门。
Cursor(搭配Claude Sonnet 4大模型)表现良好。虽然首次对话生成的Python代码出现了将应付款误认作应收款的逻辑错误,但经过一次修复对话后立即得到了正
确结果。
Lingma IDE(搭配Qwen3大模型,开启Agent模式)表现欠佳。在提示词输入框中,无论使用“#”还是点击“+”按钮,都无法找到中文文件名“部门对账表-脱敏-样
例.xlsx”,导致无法将文件导入上下文。
腾讯元宝网页端(搭配混元T1-DeepThink大模型)表现不尽如人意。提交代码清单 4-2的提示词后,系统在生成Python代码时就自动中断。重试后虽然完整生成了代
码,但在生成README运行指南时又出现中断。
Trae国内版(搭配Doubao Seed 1.6大模型)首次生成的Python代码存在逻辑错误,无法正确计算排名前三的部门的应收款项。
这个错误是因为AI生成的Python代码试图将包含多个True/False值的pandas (一款Python代码库)Series(一维数据结构)直接用作if条件判断,但
Python不知道该如何将多个布尔值转换为单一的True或False。正确的解决方法是使用.any()(任意一个为真)或.all()(全部为真)来明确指定判断逻
辑。
Trae国内版(搭配DeepSeek-R1大模型)首次生成的代码运行时报错:
“ValueError: The truth value of a Series is ambiguous”(值错误:Series
的真值有二义性)。
Trae国际版(搭配Claude Sonnet 4大模型)首次生成的代码同样运行失败,报错:“读取文件时出错:The truth value of a Series is ambiguous”。
本章和第3章展示了如何通过氛围编程工具生成单个源代码文件。那么,当遇到需要在一次对话中生成像微信小程序这样多达几十个代码源文件的场景时,由于难以
将全部文件一个个上传给AI聊天应用,该如何进行氛围编程呢?
全站分卷索引 · 24 卷
- 1内容提要
- 2对本书的赞誉
- 3氛围编程:打开一扇软件开发的新大门
- 4氛围编程:极大释放整个社会的创新能力
- 5当自然语言成为编程语言时,软件世界将如何进化
- 6氛围编程让编程不再高冷
- 7当我看到编程真的像聊天一样简单
- 8前言
- 9致谢
- 10第一部分 基础
- 11第1章 颠覆传统的氛围编程
- 12第二部分 入门
- 13第2章 用扣子实现“减少AI幻觉”智能体
- 14第3章 用Windsurf等5款工具可视化数据
- 15第4章 用Claude和通义等分析Excel数据
- 16第三部分 快速
- 17第5章 用Trae实现微信小程序
- 18第6章 用bolt和Trae等4款工具快速实现Web产品原型
- 19第四部分 进阶
- 20第7章 用GitHub Copilot实现前后端分离的Web应用
- 21第8章 用Cursor保护代码逻辑不被破坏
- 22第五部分 攻略
- 23第9章 氛围编程攻略与工具和大模型选择指南
- 24附录A 氛围编程中工具准备与常见操作