第8章 用Cursor保护代码逻辑不被破坏
第8章
用Cursor保护代码逻辑不被破坏
5.7节中提过,当你使用氛围编程方法开发应用并想要增添新功能或修复bug时,会遇到一个问题:大模型可能会遗忘之前代码实现时的需求分析和架构设计信息,从
而在代码变更时破坏原本正常运行的功能,出现“进一步,退两步”的困境。当时提出的解决方案是编写项目规则,并在与大模型对话时引用这些规则来约束它的行
为。然而,即使采取这种方式,大模型仍可能因1.2.9节所述原因出现幻觉。幸运的是,可以通过氛围编程编写端到端自动化测试来解决这个困境。
本章将教你如何使用自然语言指导Cursor,为第7章所创建的前后端分离的Web应用生成端到端自动化测试,从而在未来的氛围编程过程中保护已有的代码逻辑(这也
符合1.7节中的氛围编程“理测评解”跟进指导原则)。
8.1 需求分析与技术栈选型
编写自动化测试代码的目的是确保已通过测试的生产代码(无论是部署在企业IT部门生产环境中为用户提供服务的大型系统,还是氛围编程者希望在个人计算机上运
行的小型项目)在后续修改时不会破坏原有功能,无论是实现新需求还是修复 bug。这项实践不仅能有力保障软件系统的稳定运行,还能有效避免在氛围编程中
大模型出现“进一步,退两步”的问题,例如大模型在持续对话过程中,一边生成新功能代码,一边在已有生产代码中引入新bug。
自动化测试在持续使用氛围编程成功开发新功能或修复bug的过程中扮演着重要角色。那么,该选择哪种类型的自动化测试呢?这个选择很重要,因为不同类型的自
动化测试需要使用不同的技术栈。
自动化测试一般分为3类:端到端测试、API测试和单元测试。以图7-3展示的 Promptyoo-0前后端分离架构为例,这3类测试具有以下特点。
(1)端到端测试需要同时运行前端服务、后端服务和DeepSeek API。测试代码会模拟用户在前端的操作并发起提示词优化请求,然后验证从DeepSeek API通过后端
返回到前端的大模型回复是否正确。
(2)API测试专注于测试后端服务的API接口(注意,这不包括测试DeepSeek API,因为那是DeepSeek团队的职责)。测试时只需运行后端服务,然后编写测试
服务内部的函数。这类测试的特点是无须启动实际的服务,单元测试框架可以独立运行测试。
在氛围编程概念出现之前,自动化测试的最佳实践是“测试金字塔”,即同时编写和运行3类测试,但数量各有侧重:端到端测试少而精(像金字塔顶),API测试适
中(像金字塔中部),单元测试最多(像金字塔底部,数量多是因为单元测试无须启动服务,运行快速且覆盖精准)。那么,在氛围编程时代,这种测试策略是否仍
然适用?
基于我的实践经验,如果整个系统(包括前后端)都采用氛围编程生成,且需求规模较小(这是氛围编程的固有限制),那么仅需编写端到端测试即可。这一发现源
于我的亲身教训。
在本章最初编写时,我被单元测试的优点所吸引——无须启动服务、运行迅速。因此,在完成第7章中的第一轮迭代后,我让氛围编程工具分别为前后端生成了单元
测试。我本以为这些测试能为第二轮迭代提供安全保障,却不料带来了意想不到的困扰。每当大模型生成新功能代码并修复运行错误直至可用时,运行原有的单元测
试就会发现大量测试运行失败。这迫使我不得不反复让大模型修复测试代码,而且这种情况在每次开发新功能时都会发生。原因在于大模型在开发新功能时会破坏已
有代码的微观逻辑,而这些逻辑正是单元测试所保护的。相比之下,如果只使用端到端测试,这个问题就不会出现,因为端到端测试保护的是宏观的业务逻辑,不会
受到内部代码层面改动的影响。
明确了要编写的自动化测试类型后,接下来需要挑选合适的技术栈。作为Web应用端到端测试的新手,我该如何选择技术栈呢?有大模型在手,这不是问题。我使用
Cursor(搭配Claude Sonnet 4大模型,并开启Agent模式)打开了第7章中已生成并通过手工端到端测试的代码目录(包含frontend和backend子目录),然后提交
了以下提示词来咨询技术栈相关事宜:
请阅读 @/frontend 和 @/backend 代码,然后为我推荐3个端到端自动化测试方案(要求针对现有代码提供自动化测试技术栈及其版本),以便让测试代码能够从前端提交提示词优化请求,经后端处理并返回结
果。要求不使用mock。请分别解释每种方案的特点、优势、劣势和适用场景。
Cursor首先阅读了前端和后端代码,指出这是一个基于React + Express的提示词优化应用,前端使用RABPOC框架收集用户输入,后端调用DeepSeek API进行流式响
应。之后它推荐了3个端到端自动化测试方案,并分别介绍了每种方案的特点、优势、劣势和适用场景。
・方案一:Playwright + TypeScript。
・方案三:WebdriverIO + Jest。
最后,Cursor推荐方案一,理由如下。
・流式响应处理:Playwright在处理异步操作和网络请求方面表现更优。
・API测试能力:能直接测试/api/optimize端点的SSE(Server-Sent Events,一种允许服务器主动向客户端推送数据的Web标准)流。
・现代化:与现有技术栈(TypeScript、现代前端)更为匹配。
・稳定性:对于涉及API调用的测试,稳定性至关重要。
我打算选择方案一,但还是有些疑问,于是我继续追问:
如果选用方案一,那么自动化测试的代码是不是应该新建一个目录保存?
Cursor回应称这完全正确,并推荐了一个合适的目录结构。我接着提问:
请问如果采用方案一和你给的目录结构,那么运行测试时,前端和后端是用测试脚本分别启动吗?请解释具体的执行测试的步骤。
Cursor回复说确实需要真实的前端和后端服务运行,然后详细解释了执行测试的步骤和服务启动策略:
# 进入测试目录(e2e即end to end,即端到端)
cd e2e-tests
# 安装依赖
npm install
# 安装浏览器
npx playwright install
# Playwright会自动启动前端和后端服务,运行测试,然后关闭服务
Cursor还绘制了一幅序列图帮助我理解端到端测试的流程。按照箭头的方向(从上到下,从左到右)及箭头上的标注阅读,可以清晰理解整个测试流程,如图8-1所
示。
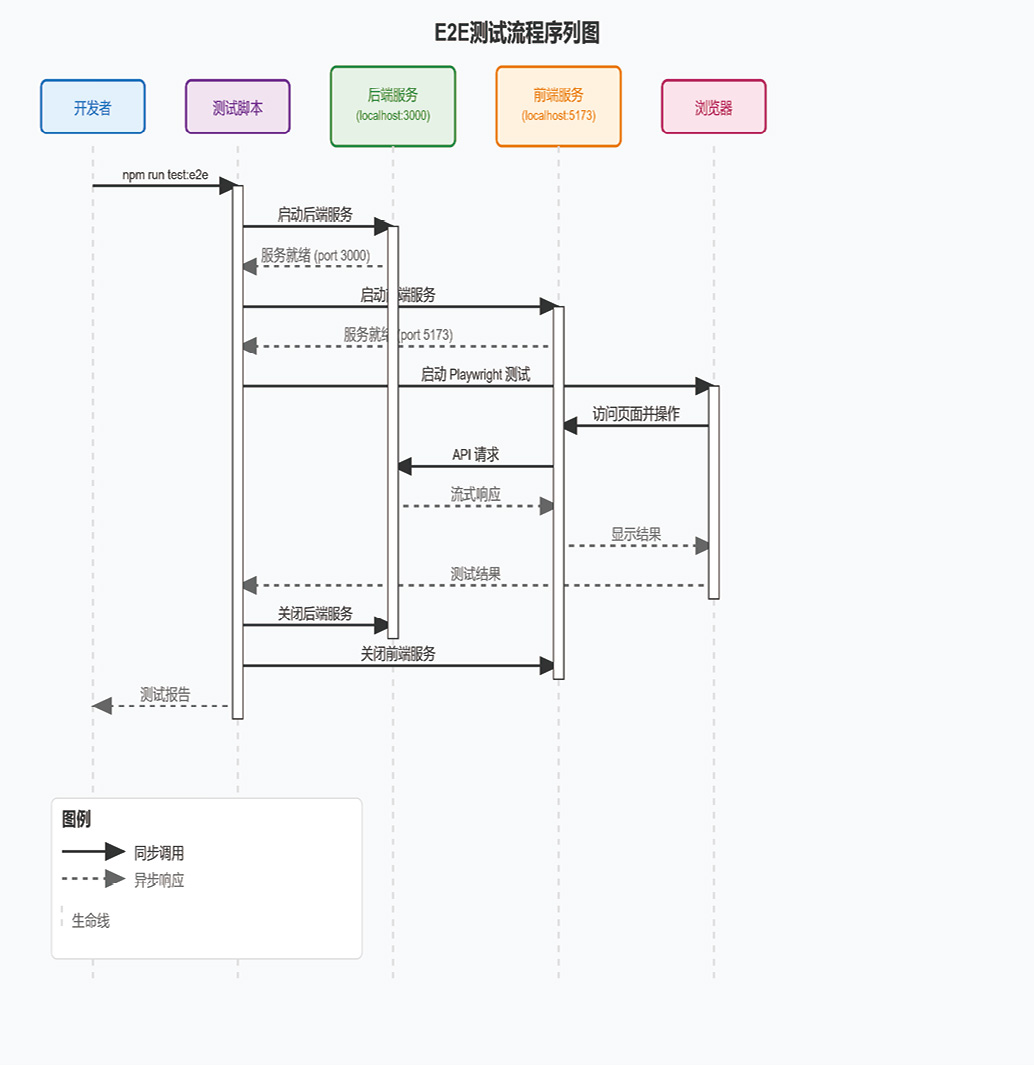
图8-1 端到端测试流程序列图
代码了。
8.2 生成端到端自动化测试代码
接下来我需要生成测试代码,于是在与Cursor的同一对话中继续询问:
请你按照你规划的方案一,在e2e-tests目录下,为我编写一个happy path和一个sad path两个end to end测试。并且告诉我该如何运行。
“happy path”和“sad path”是软件测试界中常用的两个术语,分别表示“正常场景”和“异常场景”。软件测试不仅需要验证系统在正常情况下能否正常运行,
还需要验证系统在异常情况下是否能优雅地处理异常。
Cursor很快给出了端到端测试代码,我点击“Accept all”按钮接受。但在Cursor 内置终端中运行npm test命令时,我发现错误。于是我选中内置终端中的完整错误
消息,并按快捷键(在macOS系统上用“Cmd+L”,在Windows/Ubuntu系统上用 “Ctrl+L”)将其插入右侧AI聊天区提示词输入框上方的上下文区域(插入后能看
到“Lines<行号范围>”),然后直接提交,让Cursor开始修复。
Cursor读取错误消息,发现问题并进行修复后,我再次运行npm test,却发现了新问题。我再次将错误消息插入上下文,继续让Cursor修复。经过4轮这样的对话,
所有24个测试终于全部通过。
仔细阅读并理解Cursor在短短一分钟内生成的24个端到端测试代码确实需要花费不少时间。为企业IT系统编写自动化测试时,这种仔细阅读和理解是必不可少的(这
也符合1.7节中的氛围编程“理测评解”跟进指导原则)。毕竟,如果不深入理解测试内容,怎能确信这些测试能真正保护生产代码的核心逻辑呢?
8.3 验证端到端测试的保护效果
要验证自动化测试是否真正保护了生产代码逻辑,除了仔细阅读和理解测试代码,还有一种有效方法:故意破坏生产代码逻辑,然后运行测试。如果测试失败,且失
败信息准确指出了被破坏的逻辑,就证明测试确实起到了保护作用。随后,将代码还原,再次运行测试应该会通过。
我特别关心DeepSeek API密钥错误的情况是否能被测试捕获。为此,我故意在.env 文件中设置了一个错误的密钥,然后运行测试,却发现所有测试仍然通过。这表明
Cursor生成的24个端到端测试并未覆盖这一场景(这启发我总结出1.7节的氛围编
词:
我故意把backend/.env文件中的DEEPSEEK_API_KEY改错,然后在e2e-tests目录下运行“npm test”,为何还是能24个测试都能通过?
Cursor分析了代码,然后给出了原因:后端有故障切换(fallback)机制。当API 密钥无效时,后端会捕获DeepSeek API的401错误,自动生成备用的故障切换模板
(fallback template)。这是当初设计的一个功能——如果DeepSeek API失效,系统会切换到由后端自行优化提示词的模式。当前端接收到备用模板后,会将其显
示给用户。现有的测试代码只检查是否有内容输出,而未验证该内容是否真正来自 DeepSeek API。
找到原因后,我决定让Cursor添加相关测试,于是继续追问:
请你增加一个能验证访问真实DeepSeek API的happy path测试,使得当我故意把API key改错后,这个测试不通过。
Cursor迅速补充了一个测试用例。当我再次运行全部测试时,这个新增的测试报错,明确指出因非法API密钥而失败。随后,我将API密钥恢复为正确值,再次运行
所有测试,这次测试全部通过。这证明了新增的测试确实能有效保护生产代码的核心逻辑。
通过仔细阅读并理解这些端到端测试代码,并利用上述故意修改生产代码的方法验证测试的有效性,再加上在提示词中让大模型遵循5.7节介绍的项目规则,你就能
更安心地进行氛围编程,有效规避“进一步,退两步”的困境。在后续为实战项目添加新功能或修复缺陷时,只需在提示词中要求Cursor在每次修改生产代码后自动
运行端到端测试,就能确保原有生产代码的逻辑不被破坏(这也符合1.7节中的氛围编程“理测评解”跟进指导原则)。
本书实战内容至此告一段落。对于本书服务的“非IT背景的人”、“有IT经验的人”和“IT新人”这3类读者在进行氛围编程时,还需要注意哪些要点呢?本书介
绍的各种氛围编程工具和大模型之间又有何横向对比?面对如此多的氛围编程工具与大模型组合,该如何高效地检验代码生成效果,从而挑选出最优组合?
全站分卷索引 · 24 卷
- 1内容提要
- 2对本书的赞誉
- 3氛围编程:打开一扇软件开发的新大门
- 4氛围编程:极大释放整个社会的创新能力
- 5当自然语言成为编程语言时,软件世界将如何进化
- 6氛围编程让编程不再高冷
- 7当我看到编程真的像聊天一样简单
- 8前言
- 9致谢
- 10第一部分 基础
- 11第1章 颠覆传统的氛围编程
- 12第二部分 入门
- 13第2章 用扣子实现“减少AI幻觉”智能体
- 14第3章 用Windsurf等5款工具可视化数据
- 15第4章 用Claude和通义等分析Excel数据
- 16第三部分 快速
- 17第5章 用Trae实现微信小程序
- 18第6章 用bolt和Trae等4款工具快速实现Web产品原型
- 19第四部分 进阶
- 20第7章 用GitHub Copilot实现前后端分离的Web应用
- 21第8章 用Cursor保护代码逻辑不被破坏
- 22第五部分 攻略
- 23第9章 氛围编程攻略与工具和大模型选择指南
- 24附录A 氛围编程中工具准备与常见操作