ES 在数十亿级别数量下如何提高查询效率?
| 6 | 加盟 | 2, 3, 5 |
|---|---|---|
| 7 | 创始人 | 3 |
| 8 | 拉斯 | 3, 5 |
| 9 | 离开 | 3 |
| 10 | 与 | 4 |
| .. | .. | .. |
另外,实用的倒排索引还可以记录更多的信息,比如文档频率信息,表示在文档集合中有多少个文档包含某个单词。
那么,有了倒排索引,搜索引擎可以很方便地响应用户的查询。比如用户输入查询 Facebook ,搜索系统查找倒排索引,从中读出包含这个单词的文档,这些文档就是提供给用户的搜索结
果。
要注意倒排索引的两个重要细节:
倒排索引中的所有词项对应一个或多个文档;
倒排索引中的词项根据字典顺序升序排列
上面只是一个简单的栗子,并没有严格按照字典顺序升序排列。
面试题
ES 在数据量很大的情况下(数十亿级别)如何提高查询效率啊?
面试官心理分析
这个问题是肯定要问的,说白了,就是看你有没有实际干过 es,因为啥?其实 es 性能并没有你想象中那么好的。很多时候数据量大了,特别是有几亿条数据的时候,可能你会懵逼的发
现,跑个搜索怎么一下 5~10s,坑爹了。第一次搜索的时候,是 5~10s,后面反而就快了,可能就几百毫秒。
面试题剖析
以搞定,但是绝对不是所有场景都可以这样。
性能优化的杀手锏——filesystem cache
你往 es 里写的数据,实际上都写到磁盘文件里去了,查询的时候,操作系统会将磁盘文件里的数据自动缓存到 filesystem cache 里面去。
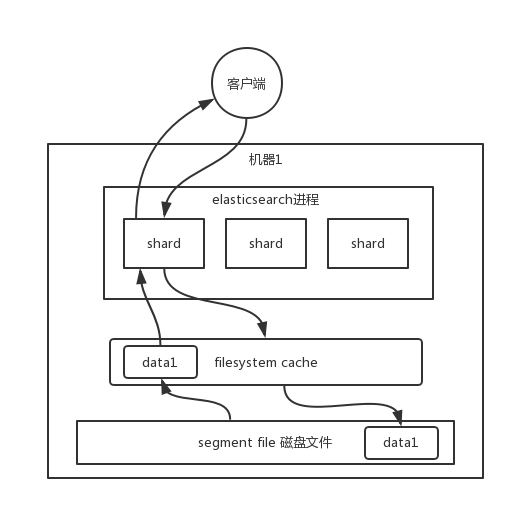
es 的搜索引擎严重依赖于底层的 filesystem cache,你如果给 filesystem cache 更多的内存,尽量让内存可以容纳所有的 idx segment file索引数据文件,那么你搜索的时候
就基本都是走内存的,性能会非常高。
性能差距究竟可以有多大?我们之前很多的测试和压测,如果走磁盘一般肯定上秒,搜索性能绝对是秒级别的,1秒、5秒、10秒。但如果是走 filesystem cache,是走纯内存的,那么
据量是 1T,那么每台机器的数据量是 300G。这样性能好吗? filesystem cache 的内存才 100G,十分之一的数据可以放内存,其他的都在磁盘,然后你执行搜索操作,大部分操作
都是走磁盘,性能肯定差。
归根结底,你要让 es 性能要好,最佳的情况下,就是你的机器的内存,至少可以容纳你的总数据量的一半。
根据我们自己的生产环境实践经验,最佳的情况下,是仅仅在 es 中就存少量的数据,就是你要用来搜索的那些索引,如果内存留给 filesystem cache 的是 100G,那么你就将索引数据
控制在 100G 以内,这样的话,你的数据几乎全部走内存来搜索,性能非常之高,一般可以在 1 秒以内。
比如说你现在有一行数据。 id,name,age .... 30 个字段。但是你现在搜索,只需要根据 id,name,age 三个字段来搜索。如果你傻乎乎往 es 里写入一行数据所有的字段,就会导致说
90% 的数据是不用来搜索的,结果硬是占据了 es 机器上的 filesystem cache 的空间,单条数据的数据量越大,就会导致 filesystem cahce 能缓存的数据就越少。其实,仅仅写入
es 中要用来检索的少数几个字段就可以了,比如说就写入 es id,name,age 三个字段,然后你可以把其他的字段数据存在 mysql/hbase 里,我们一般是建议用 es + hbase 这么一个架
构。
hbase 的特点是适用于海量数据的在线存储,就是对 hbase 可以写入海量数据,但是不要做复杂的搜索,做很简单的一些根据 id 或者范围进行查询的这么一个操作就可以了。从 es 中根
据 name 和 age 去搜索,拿到的结果可能就 20 个 doc id,然后根据 doc id 到 hbase 里去查询每个 doc id 对应的完整的数据,给查出来,再返回给前端。
写入 es 的数据最好小于等于,或者是略微大于 es 的 filesystem cache 的内存容量。然后你从 es 检索可能就花费 20ms,然后再根据 es 返回的 id 去 hbase 里查询,查 20 条数据,可能也就耗
费个 30ms,可能你原来那么玩儿,1T 数据都放 es,会每次查询都是 5~10s,现在可能性能就会很高,每次查询就是 50ms。
数据预热
假如说,哪怕是你就按照上述的方案去做了,es 集群中每个机器写入的数据量还是超过了 filesystem cache 一倍,比如说你写入一台机器 60G 数据,结果 filesystem cache 就
30G,还是有 30G 数据留在了磁盘上。
或者是电商,你可以将平时查看最多的一些商品,比如说 iphone 8,热数据提前后台搞个程序,每隔 1 分钟自己主动访问一次,刷到 filesystem cache 里去。
对于那些你觉得比较热的、经常会有人访问的数据,最好做一个专门的缓存预热子系统,就是对热数据每隔一段时间,就提前访问一下,让数据进入 filesystem cache 里面去。这样
下次别人访问的时候,性能一定会好很多。
冷热分离
es 可以做类似于 mysql 的水平拆分,就是说将大量的访问很少、频率很低的数据,单独写一个索引,然后将访问很频繁的热数据单独写一个索引。最好是将冷数据写入一个索引中,然后
热数据写入另外一个索引中,这样可以确保热数据在被预热之后,尽量都让他们留在 filesystem os cache 里,别让冷数据给冲刷掉。
你看,假设你有 6 台机器,2 个索引,一个放冷数据,一个放热数据,每个索引 3 个 shard。3 台机器放热数据 index,另外 3 台机器放冷数据 index。然后这样的话,你大量的时间是在访问
热数据 index,热数据可能就占总数据量的 10%,此时数据量很少,几乎全都保留在 filesystem cache 里面了,就可以确保热数据的访问性能是很高的。但是对于冷数据而言,
是在别的 index 里的,跟热数据 index 不在相同的机器上,大家互相之间都没什么联系了。如果有人访问冷数据,可能大量数据是在磁盘上的,此时性能差点,就 10% 的人去访问冷数据,
90% 的人在访问热数据,也无所谓了。
document模型设计
对于 MySQL,我们经常有一些复杂的关联查询。在 es 里该怎么玩儿,es 里面的复杂的关联查询尽量别用,一旦用了性能一般都不太好。
最好是先在 Java 系统里就完成关联,将关联好的数据直接写入 es 中。搜索的时候,就不需要利用 es 的搜索语法来完成 join 之类的关联搜索了。
document 模型设计是非常重要的,很多操作,不要在搜索的时候才想去执行各种复杂的乱七八糟的操作。es 能支持的操作就那么多,不要考虑用 es 做一些它不好操作的事情。如果真的
有那种操作,尽量在 document 模型设计的时候,写入的时候就完成。另外对于一些太复杂的操作,比如 join/nested/parent-child 搜索都要尽量避免,性能都很差的。
分页性能优化
分布式的,你要查第 100 页的 10 条数据,不可能说从 5 个 shard,每个 shard 就查 2 条数据,最后到协调节点合并成 10 条数据吧?你必须得从每个 shard 都查 1000 条数据过来,然后根据
你的需求进行排序、筛选等等操作,最后再次分页,拿到里面第 100 页的数据。你翻页的时候,翻的越深,每个 shard 返回的数据就越多,而且协调节点处理的时间越长,非常坑爹。所
以用 es 做分页的时候,你会发现越翻到后面,就越是慢。
我们之前也是遇到过这个问题,用 es 作分页,前几页就几十毫秒,翻到 10 页或者几十页的时候,基本上就要 5~10 秒才能查出来一页数据了。
有什么解决方案吗?
不允许深度分页(默认深度分页性能很差)
跟产品经理说,你系统不允许翻那么深的页,默认翻的越深,性能就越差。
类似于app里的推荐商品不断下拉出来一页一页的
类似于微博中,下拉刷微博,刷出来一页一页的,你可以用 scroll api,关于如何使用,自行上网搜索。
scroll 会一次性给你生成所有数据的一个快照,然后每次滑动向后翻页就是通过游标 scroll_id 移动,获取下一页下一页这样子,性能会比上面说的那种分页性能要高很多很
多,基本上都是毫秒级的。
但是,唯一的一点就是,这个适合于那种类似微博下拉翻页的,不能随意跳到任何一页的场景。也就是说,你不能先进入第 10 页,然后去第 120 页,然后又回到第 58 页,不能随意乱跳
页。所以现在很多产品,都是不允许你随意翻页的,app,也有一些网站,做的就是你只能往下拉,一页一页的翻。
初始化时必须指定 scroll 参数,告诉 es 要保存此次搜索的上下文多长时间。你需要确保用户不会持续不断翻页翻几个小时,否则可能因为超时而失败。
除了用 scroll api,你也可以用 search_after 来做, search_after 的思想是使用前一页的结果来帮助检索下一页的数据,显然,这种方式也不允许你随意翻页,你只能一页页往
后翻。初始化时,需要使用一个唯一值的字段作为 sort 字段。
面试题
全站分卷索引 · 72 卷
- 1互联网 Java 工程师进阶知识完全扫盲
- 2为什么使用消息队列?
- 3如何保证消息队列的高可用?
- 4如何保证消息不被重复消费?
- 5如何保证消息的可靠性传输?
- 6如何保证消息的顺序性?
- 7如何解决消息队列的延时以及过期失效问题?
- 8如何设计一个消息队列?
- 9搜索引擎
- 10ES 的分布式架构原理是什么?
- 11ES 写入数据的工作原理是什么?
- 12ES 在数十亿级别数量下如何提高查询效率?
- 13ES 生产集群的部署架构是什么?
- 14缓存
- 15Redis 和 Memcached 有什么区别?
- 16Redis 都有哪些数据类型以及适用场景?
- 17Redis 的过期策略都有哪些?
- 18如何保证 Redis 高并发、高可用?
- 19Redis 主从架构是怎样的?
- 20Redis 的持久化有哪几种方式?
- 21Redis 如何基于哨兵集群实现高可用?
- 22Redis 集群模式的工作原理能说一下么?
- 23Redis 的雪崩、穿透和击穿,如何应对?
- 24如何保证缓存与数据库双写一致性?
- 25如何解决 Redis 的并发竞争问题?
- 26生产环境中的 Redis 是怎么部署的?
- 27分库分表如何平滑过渡?
- 28设计一个动态扩容缩容的分库分表方案?
- 29分库分表之后,id 主键如何处理?
- 30读写分离
- 31高并发系统
- 32分布式系统
- 33系统拆分
- 34分布式服务框架
- 35Dubbo 支持哪些序列化协议?
- 36Dubbo 负载均衡策略和集群容错策略?
- 37Dubbo 的 SPI 思想是什么?
- 38如何基于 Dubbo 进行服务治理?
- 39分布式服务接口的幂等性如何设计?
- 40分布式服务接口请求的顺序性如何保证?
- 41如何自己设计一个类似 Dubbo 的 RPC 框架?
- 42CAP 定理的 P 是什么?
- 43分布式锁
- 44分布式锁如何设计?
- 45分布式事务
- 46分布式会话
- 47高可用架构
- 48电商网站详情页系统架构
- 49Hystrix 线程池技术实现资源隔离
- 50Hystrix 信号量机制实现资源隔离
- 51Hystrix 隔离策略细粒度控制
- 52深入 Hystrix 执行时内部原理
- 53基于 request cache 请求缓存技术优化批量商品数据查询接口
- 54基于本地缓存的 fallback 降级机制
- 55深入 Hystrix 断路器执行原理
- 56深入 Hystrix 线程池隔离与接口限流
- 57基于 timeout 机制为服务接口调用超时提供安全保护
- 58限流
- 59熔断
- 60微服务架构
- 61从单体式架构迁移到微服务架构
- 62微服务的事件驱动数据管理
- 63选择微服务部署策略
- 64Spring Cloud微服务架构
- 65你所知道的微服务技术栈都有哪些?
- 66谈谈服务发现组件 Eureka 的主要调用过程?
- 67海量数据处理
- 68如何找出某一天访问百度网站最多的 IP?
- 69如何在大量的数据中找出不重复的整数?
- 70如何在大量的数据中判断一个数是否存在?
- 71如何统计不同电话号码的个数?
- 72如何按照 query 的频度排序?