谈谈服务发现组件 Eureka 的主要调用过程?
进行定期的心跳检测,当发现服务状态异常时将其从注册中心剔除下线。服务 A 只要从注册中心中获取服务 B 的信息即可,即使当服务 B 的 IP 或者端口变更了,服务 A 也无需修改,从一
定程度上解耦了服务。服务发现目前业界有很多开源的实现,比如 apache 的 zookeeper、 Netflix 的 eureka、 hashicorp 的 consul、 CoreOS 的 etcd。
Eureka是什么
Eureka 在 GitHub 上对其的定义为
Eureka is a REST (Representational State Transfer) based service that is primarily used in the AWS cloud for locating services for the purpose of load balancing and failover of
middle-tier servers.
At Netflix, Eureka is used for the following purposes apart from playing a critical part in mid-tier load balancing.
Eureka 是由 Netflix 公司开源,采用的是 Client / Server 模式进行设计,基于 http 协议和使用 Restful Api 开发的服务注册与发现组件,提供了完整的服务注册和服务发现,可以和 Spring
Cloud 无缝集成。其中 Server 端扮演着服务注册中心的角色,主要是为 Client 端提供服务注册和发现等功能,维护着 Client 端的服务注册信息,同时定期心跳检测已注册的服务当不可用时
将服务剔除下线,Client 端可以通过 Server 端获取自身所依赖服务的注册信息,从而完成服务间的调用。遗憾的是从其官方的 github wiki 可以发现,2.0 版本已经不再开源。但是不影响我
们对其进行深入了解,毕竟服务注册、服务发现相对来说还是比较基础和通用的,其它开源实现框架的思想也是想通的。
服务注册中心(Eureka Server)
我们在项目中引入 Eureka Server 的相关依赖,然后在启动类加上注解 @EnableEurekaServer,就可以将其作为注册中心,启动服务后访问页面如下:
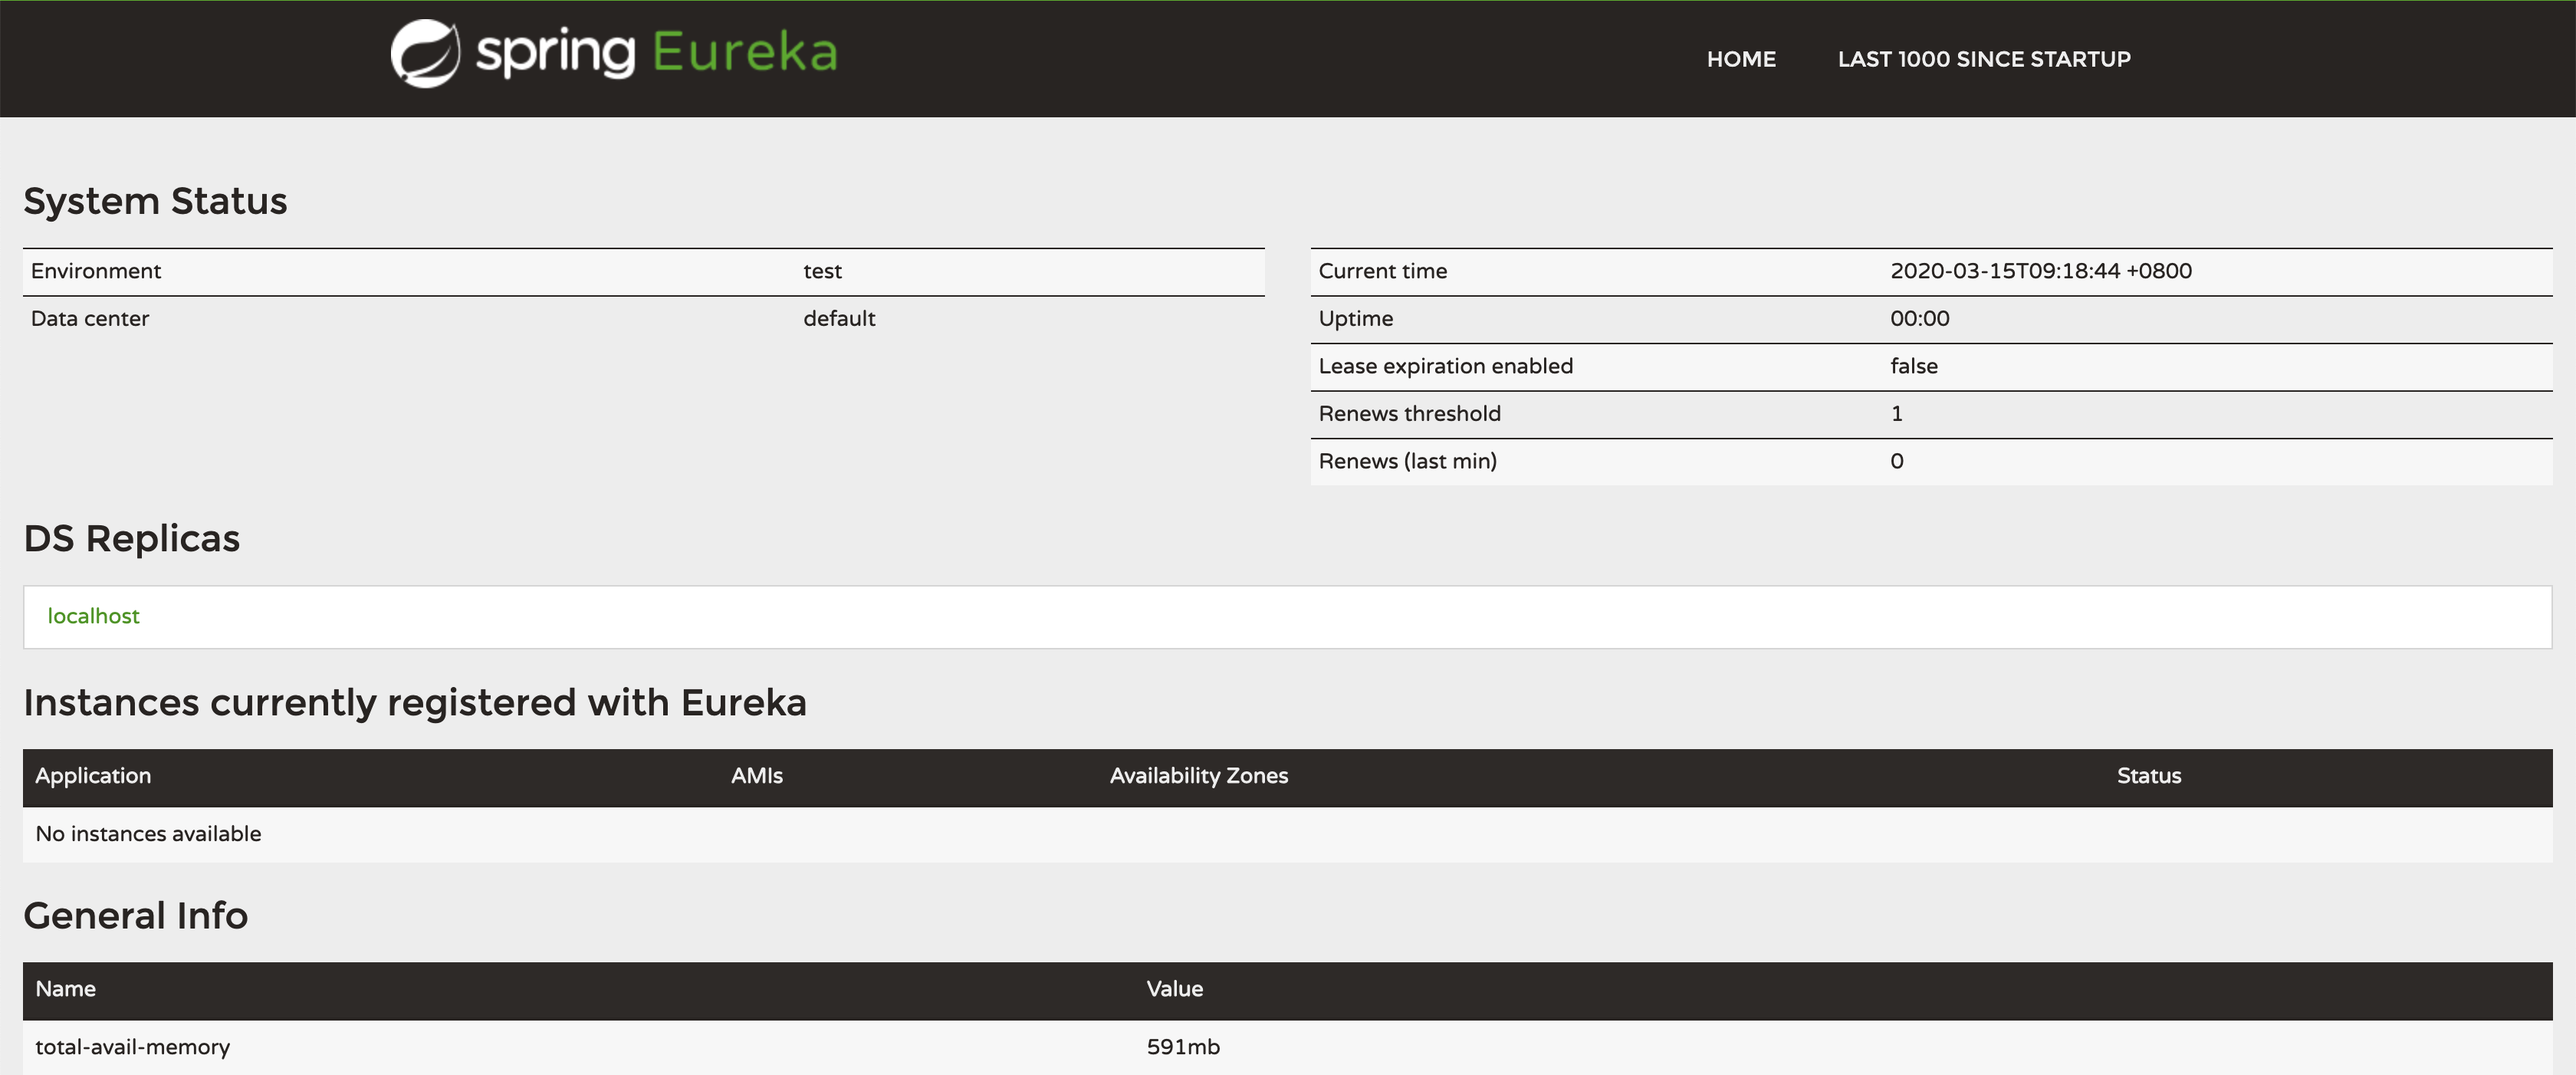
我们继续添加两个模块 service-provider, service-consumer,然后在启动类加上注解 @EnableEurekaClient 并指定注册中心地址为我们刚刚启动的 Eureka Server,再次访问
可以看到两个服务都已经注册进来了。
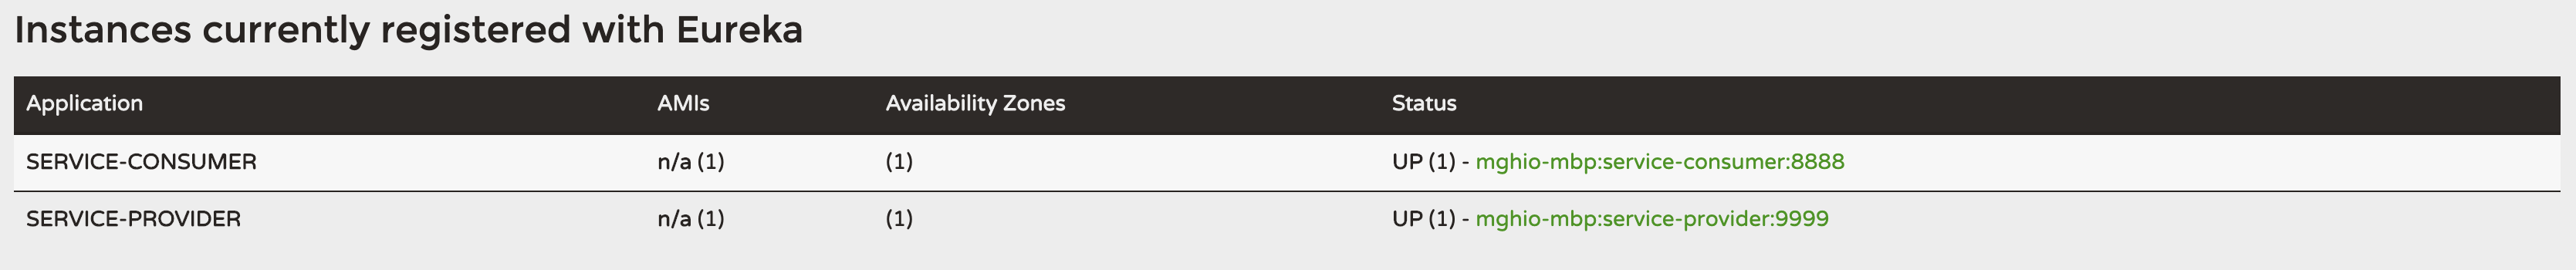
Demo 仓库地址:https://github.com/mghio/depth-in-springcloud
可以看到 Eureka 的使用非常简单,只需要添加几个注解和配置就实现了服务注册和服务发现,接下来我们看看它是如何实现这些功能的。
服务注册(Register)
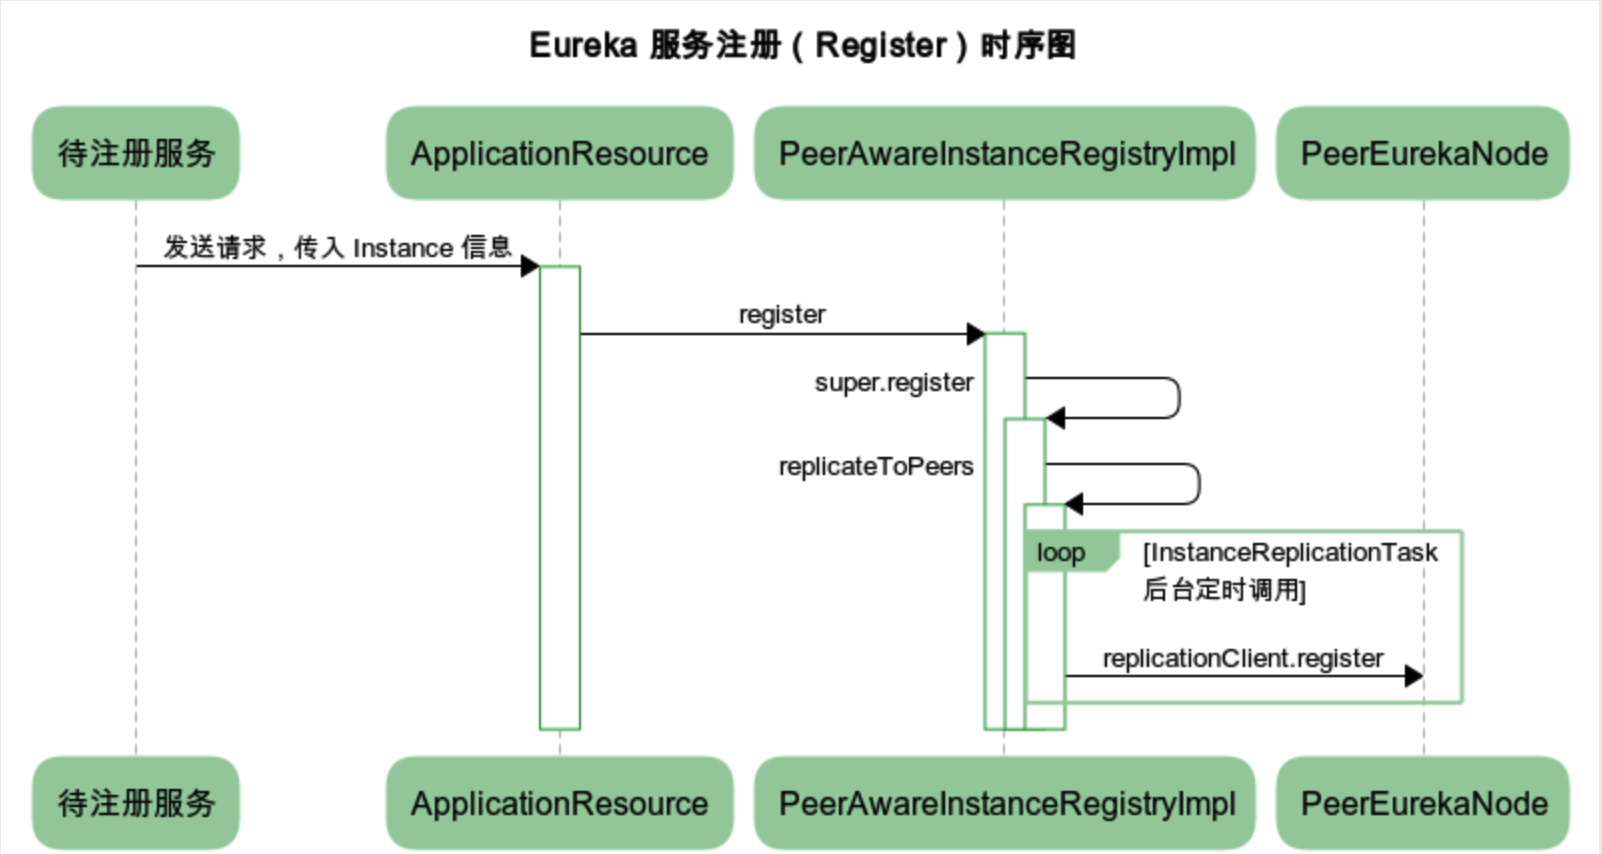
注册中心提供了服务注册接口,用于当有新的服务启动后进行调用来实现服务注册,或者心跳检测到服务状态异常时,变更对应服务的状态。服务注册就是发送一个 POST 请求带上当前实
例信息到类 ApplicationResource 的 addInstance 方法进行服务注册。
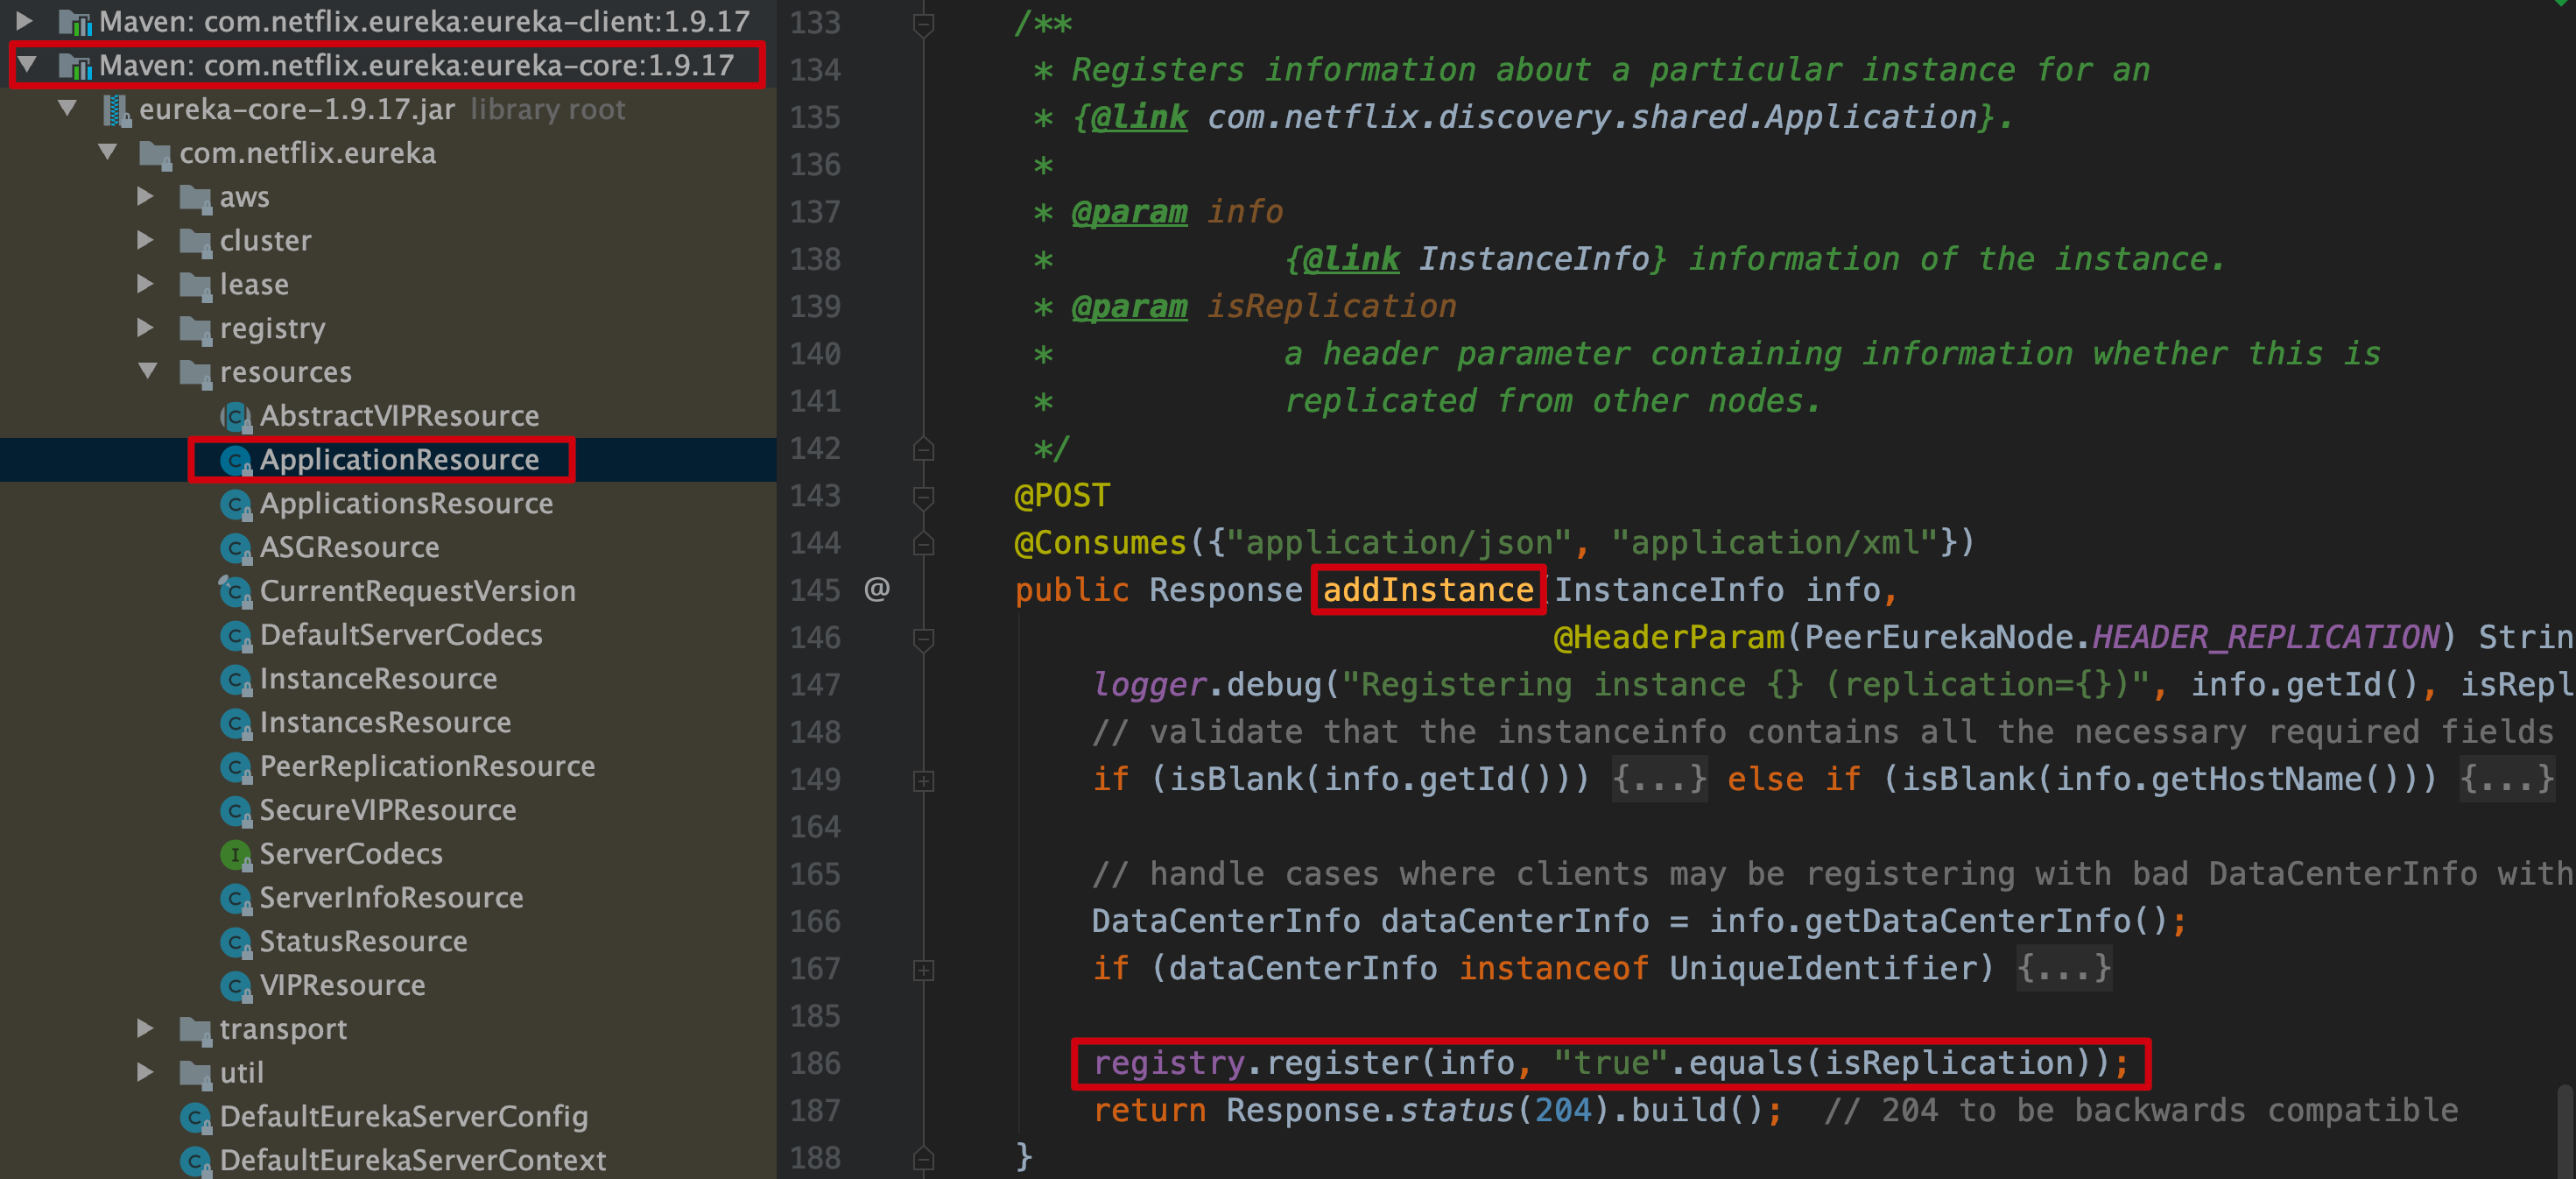
- 调用 replicateToPeers 方法使用异步的方式向其它的 Eureka Server 节点同步服务注
册信息
服务注册信息保存在一个嵌套的 map 中,它的结构如下:
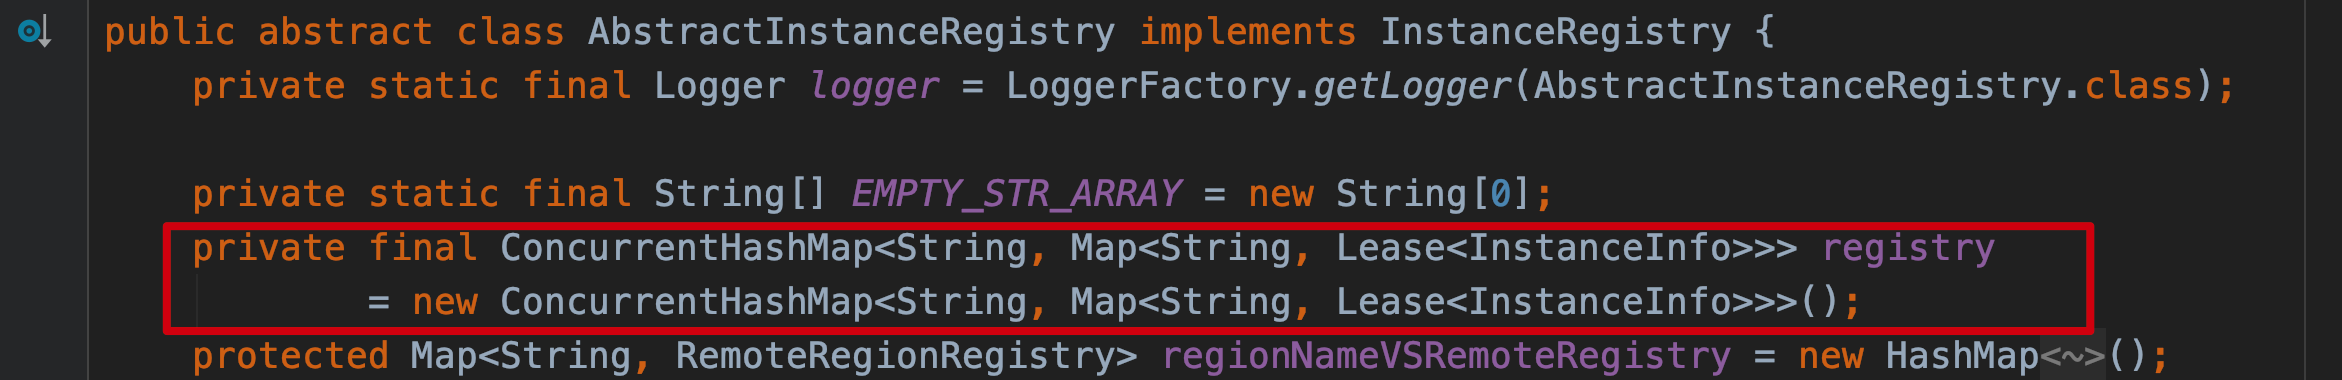
第一层 map 的 key 是应用名称(对应 Demo 里的 SERVICE-PROVIDER),第二层 map 的 key 是应用对应的实例名称(对应 Demo 里的 mghio-mbp:service-provider:9999
),一个应用可以有多个实例,主要调用流程如下图所示:
服务续约(Renew)
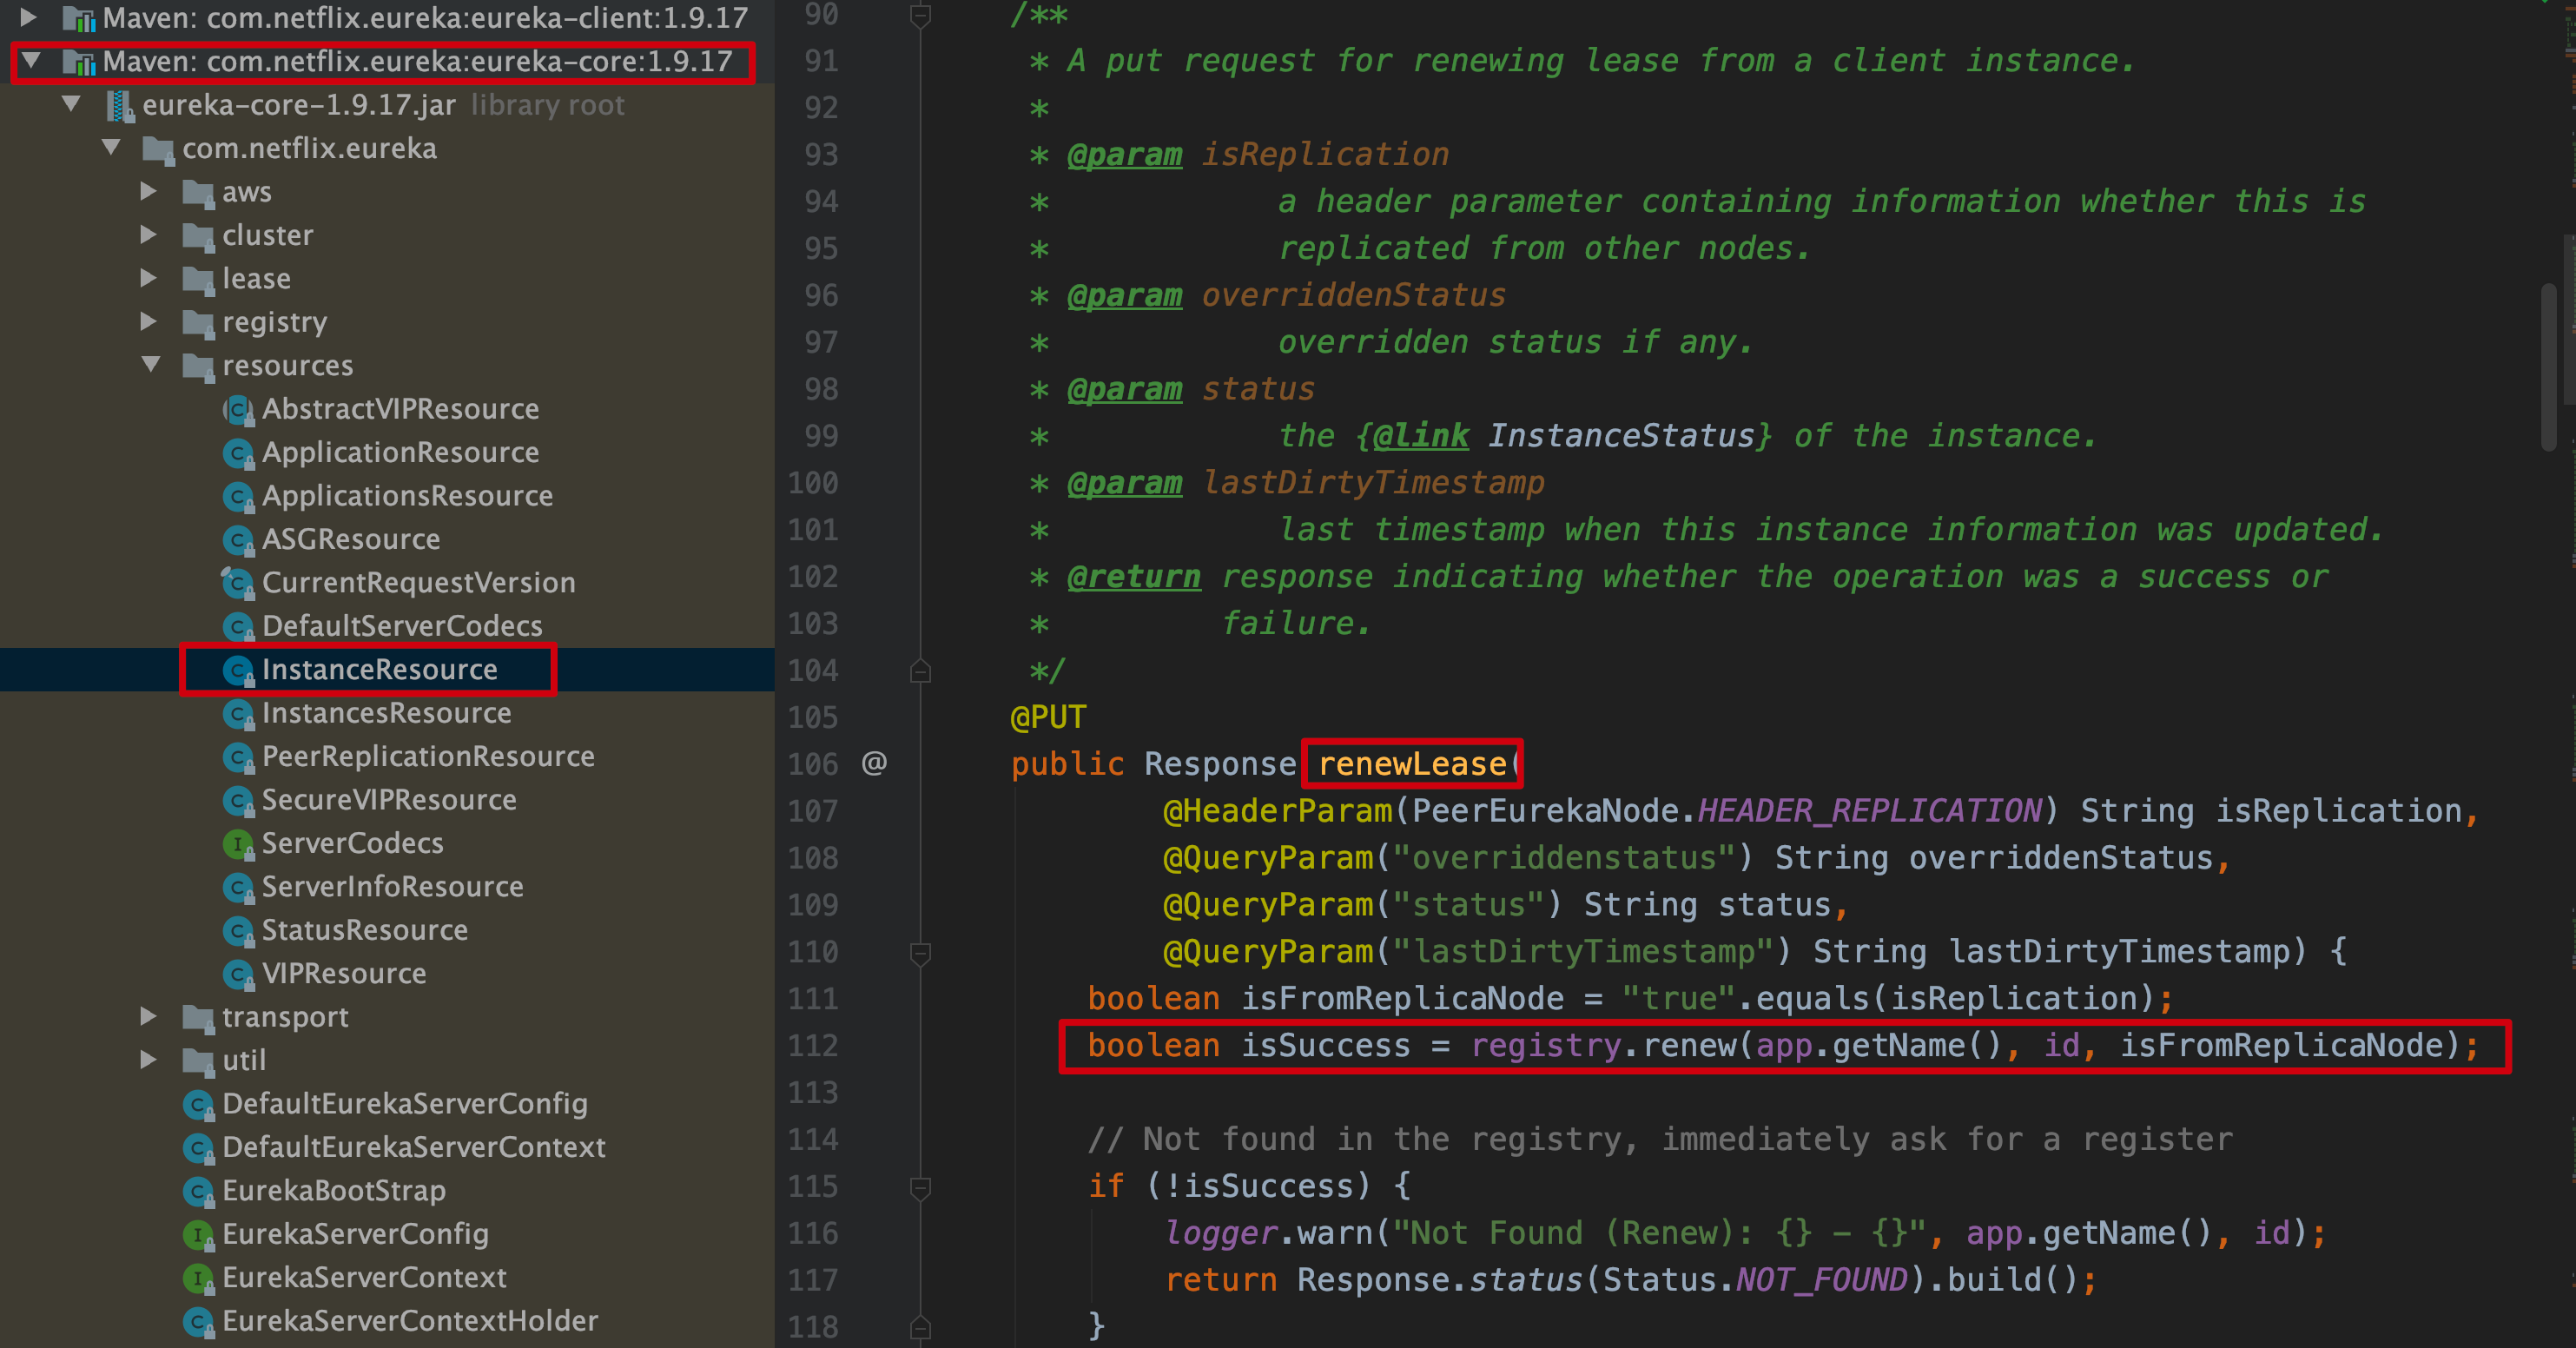
服务续约会由服务提供者(比如 Demo 中的 service-provider)定期调用,类似于心跳,用来告知注册中心 Eureka Server 自己的状态,避免被 Eureka Server 认为服务时效将其
剔除下线。服务续约就是发送一个 PUT 请求带上当前实例信息到类 InstanceResource 的 renewLease 方法进行服务续约操作。
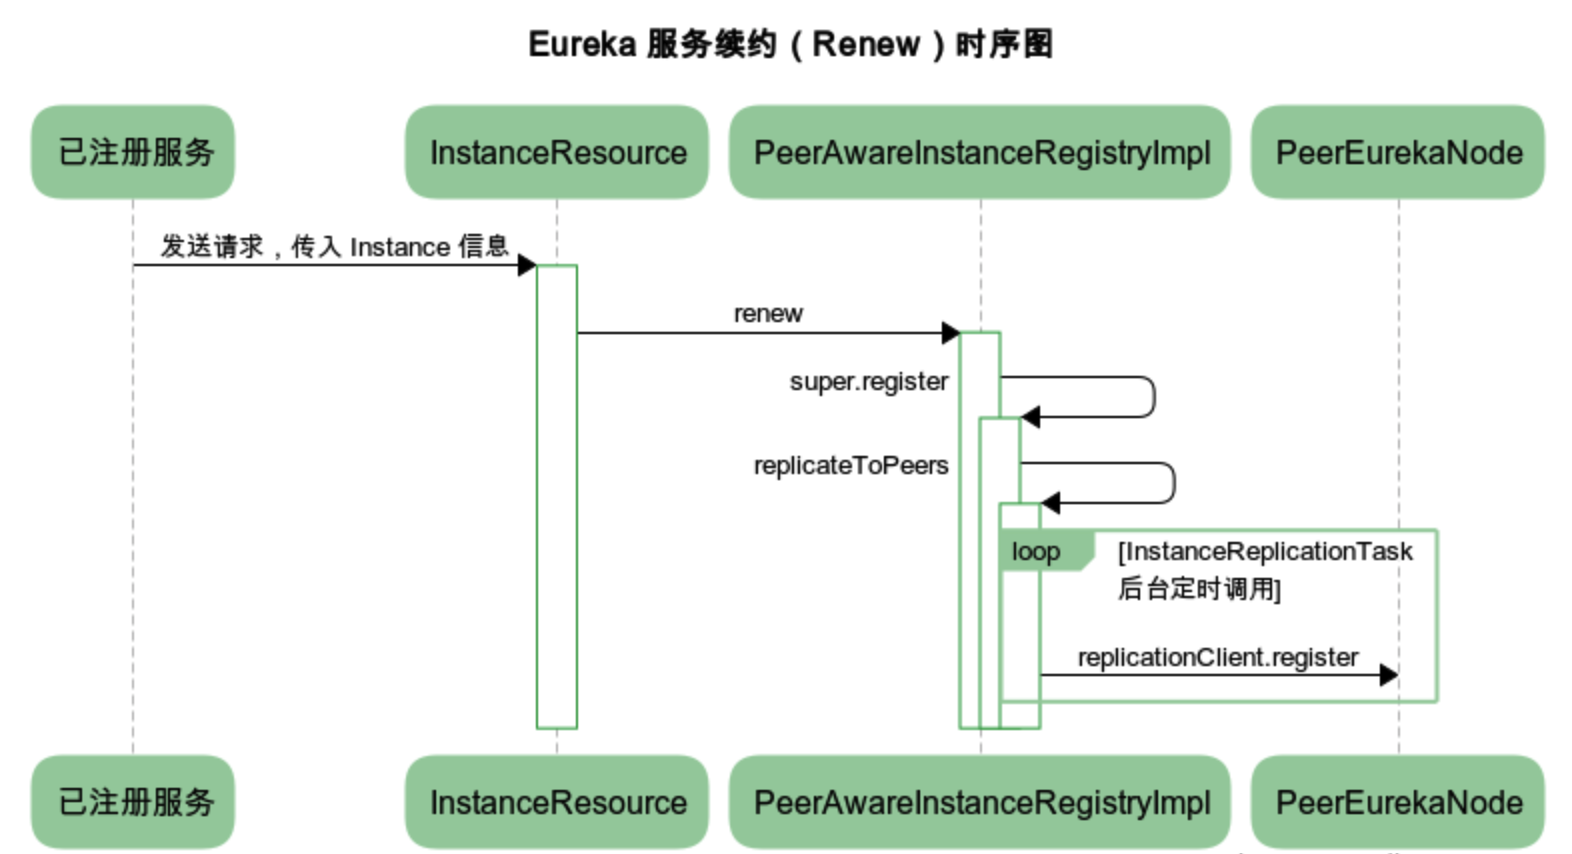
进入到 PeerAwareInstanceRegistryImpl 的 renew 方法可以看到,服务续约步骤大体上和服务注册一致,先更新当前 Eureka Server 节点的状态,服务续约成功后再用异步的方式同
步状态到其它 Eureka Server 节上,主要调用流程如下图所示:
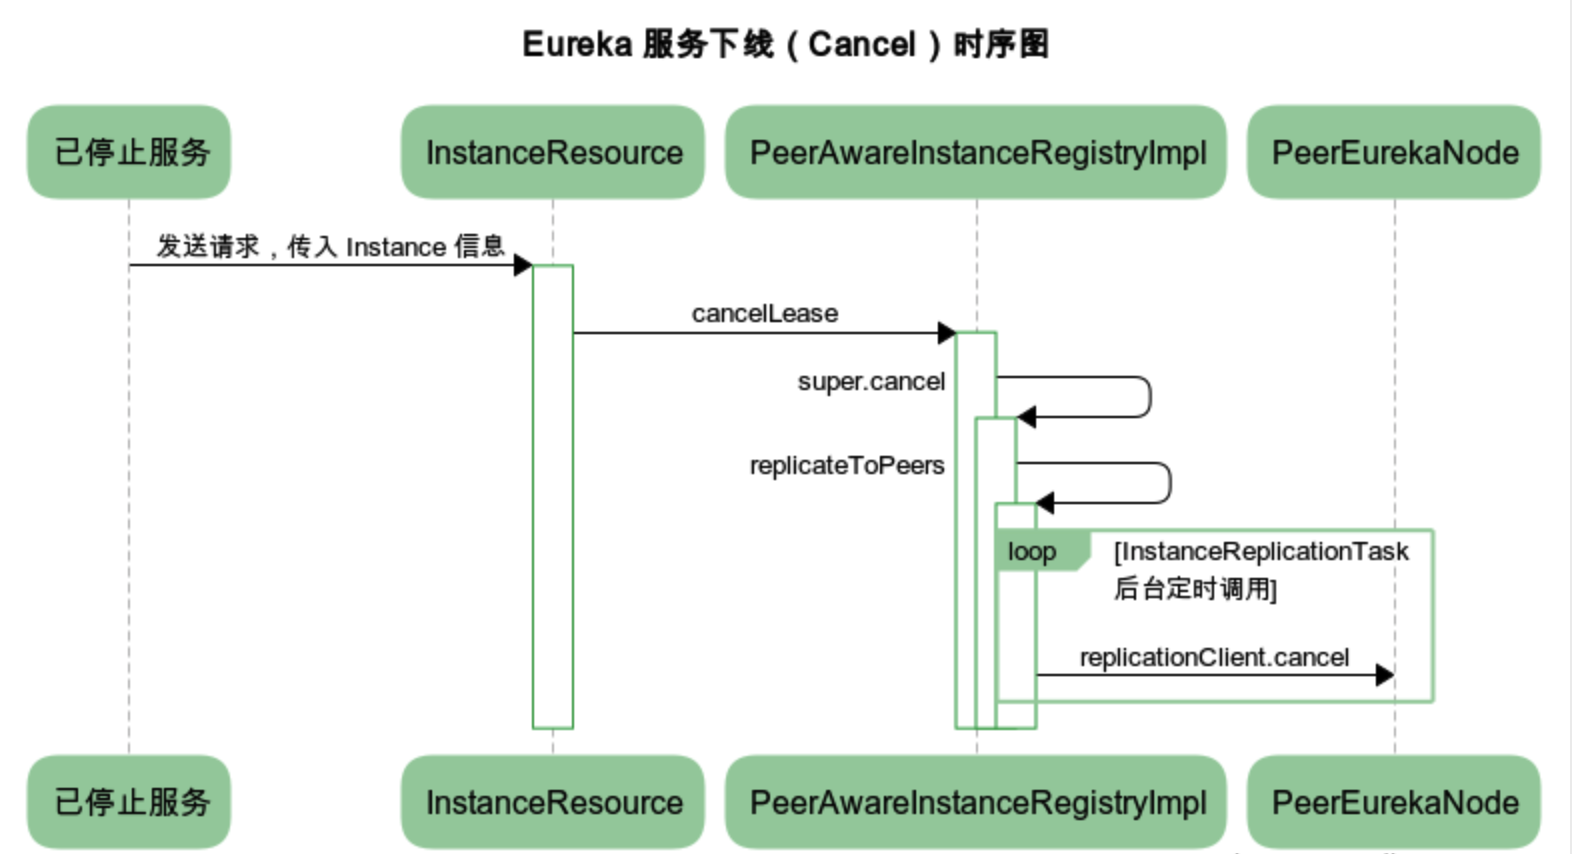
服务下线(Cancel)
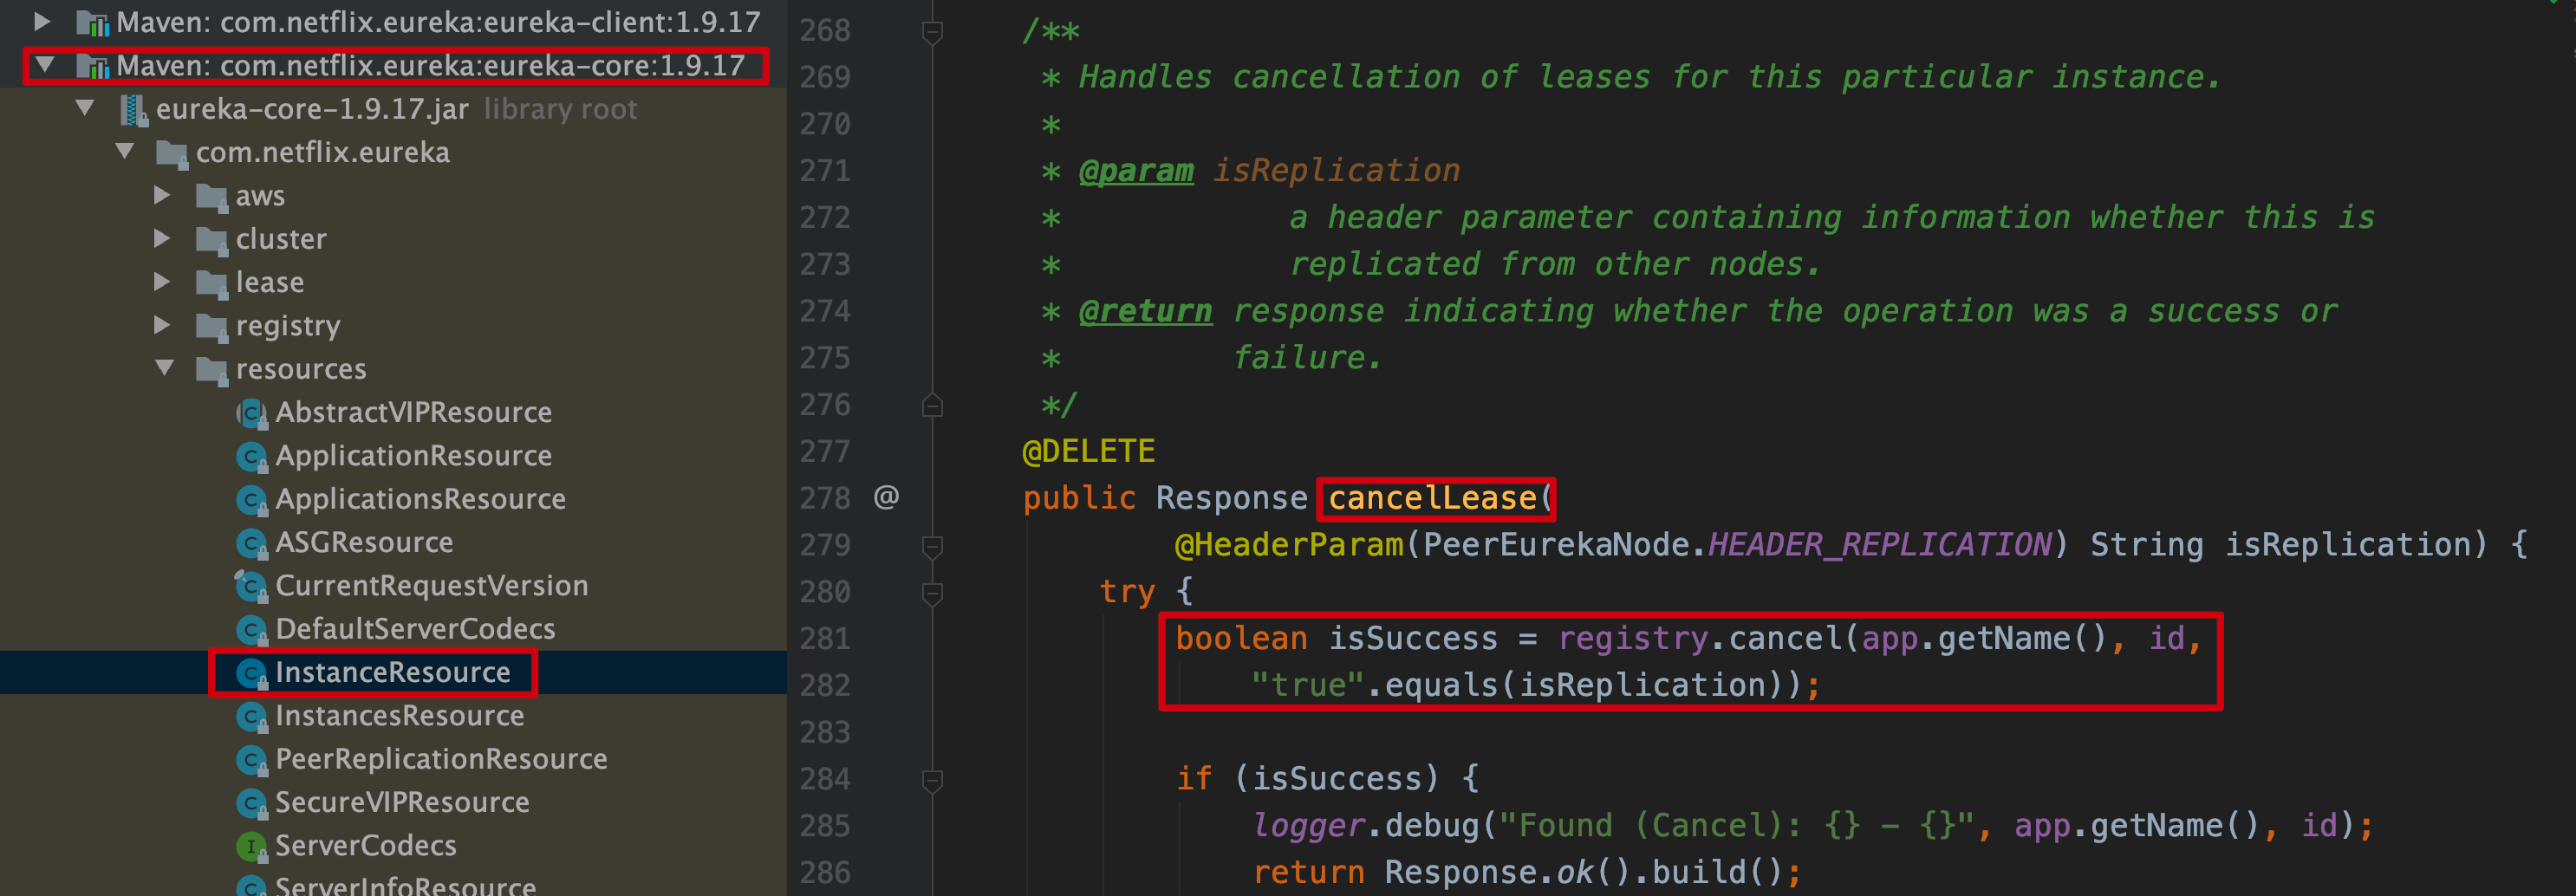
当服务提供者(比如 Demo 中的 service-provider)停止服务时,会发送请求告知注册中心 Eureka Server 进行服务剔除下线操作,防止服务消费者从注册中心调用到不存在的服
务。服务下线就是发送一个 DELETE 请求带上当前实例信息到类 InstanceResource 的
进入到 PeerAwareInstanceRegistryImpl 的 cancel 方法可以看到,服务续约步骤大体上和服务注册一致,先在当前 Eureka Server 节点剔除下线该服务,服务下线成功后再用异步
的方式同步状态到其它 Eureka Server 节上,主要调用流程如下图所示:
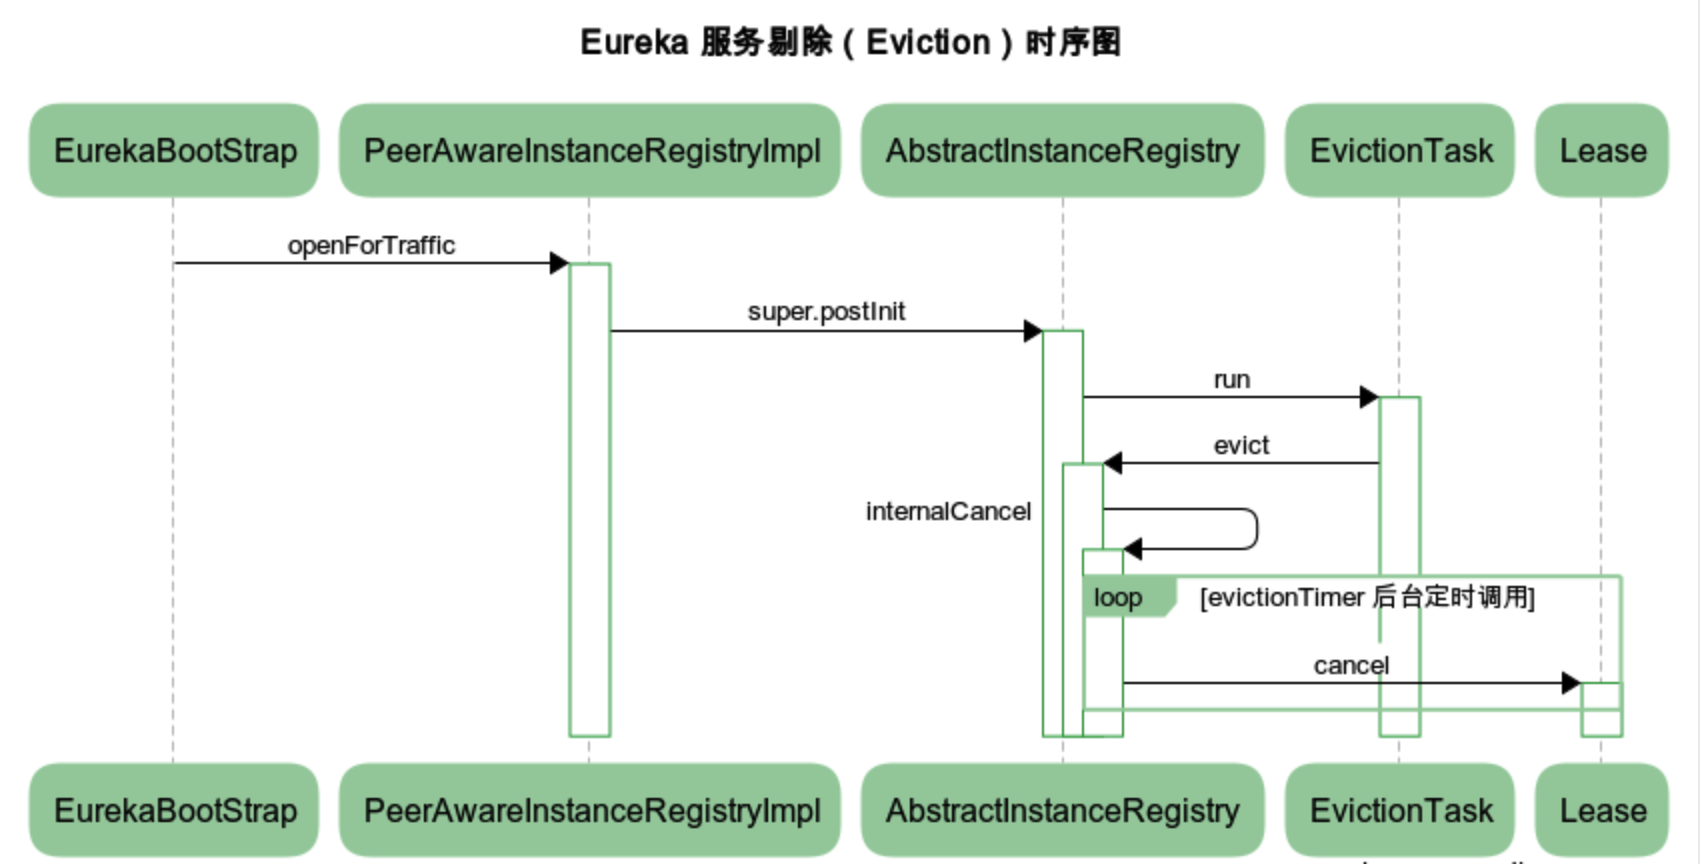
服务剔除(Eviction)
服务剔除是注册中心 Eureka Server 在启动时就启动一个守护线程 evictionTimer 来定期(默认为 60 秒)执行检测服务的,判断标准就是超过一定时间没有进行 Renew 的服务,默
认的失效时间是 90 秒,也就是说当一个已注册的服务在 90 秒内没有向注册中心 Eureka Server 进行服务续约(Renew),就会被从注册中心剔除下线。失效时间可以通过配置
eureka.instance.leaseExpirationDurationInSeconds 进行修改,定期执行检测服务可以通过配置 eureka.server.evictionIntervalTimerInMs 进行修改,主要调用流程如下图所
示:
服务提供者(Service Provider)
对于服务提供方(比如 Demo 中的 service-provider 服务)来说,主要有三大类操作,分别为服务注册(Register)、服务续约(Renew)、服务下线(Cancel),接下来看看这
三个操作是如何实现的。
服务注册(Register)
一个服务要对外提供服务,首先要在注册中心 Eureka Server 进行服务相关信息注册,能进行这一步的前提是你要配置 eureka.client.register-with-eureka=true,这个默认值为
true,注册中心不需要把自己注册到注册中心去,把这个配置设为 false,这个调用比较简单,主要调用流程如下图所示:
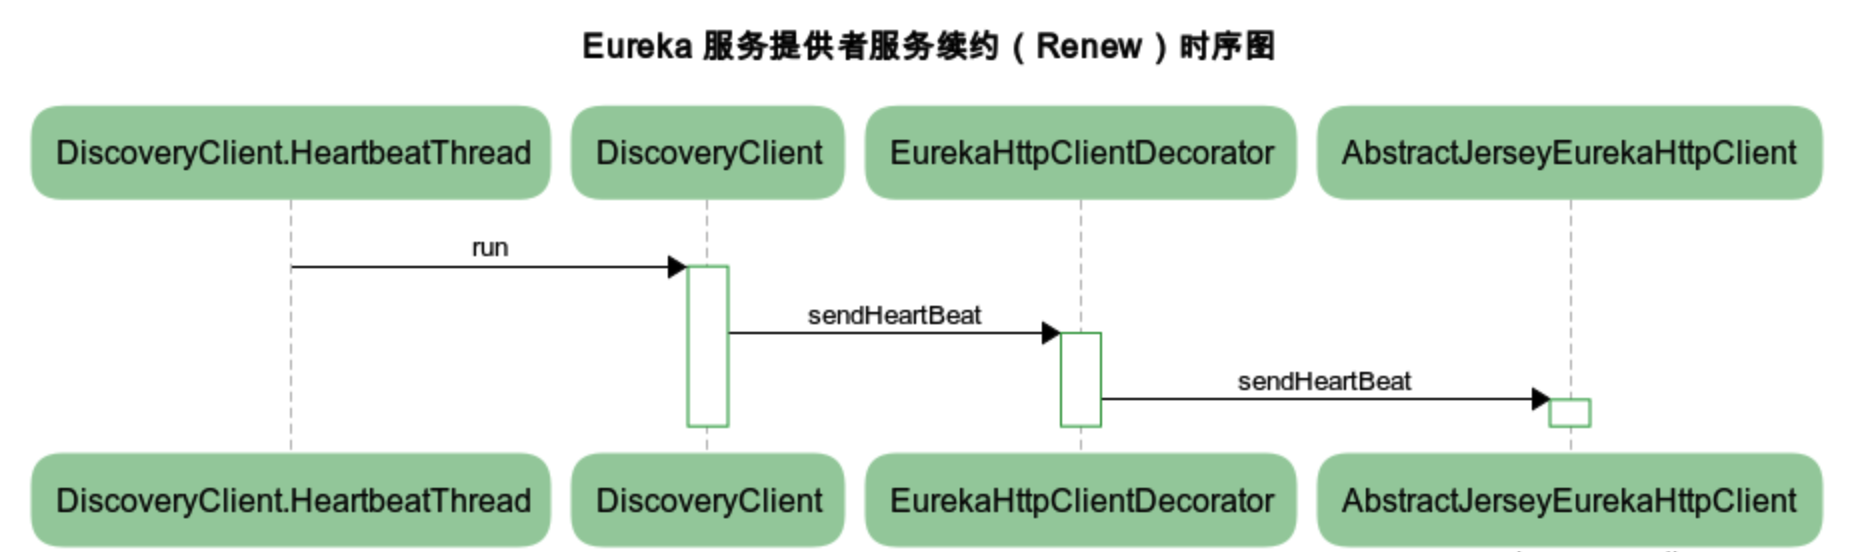
服务续约(Renew)
renewal-interval-in-seconds 来修改,当然服务续约的前提是要配置 eureka.client.register-with-eureka=true,将该服务注册到注册中心中去,主要调用流
程如下图所示:
服务下线(Cancel)
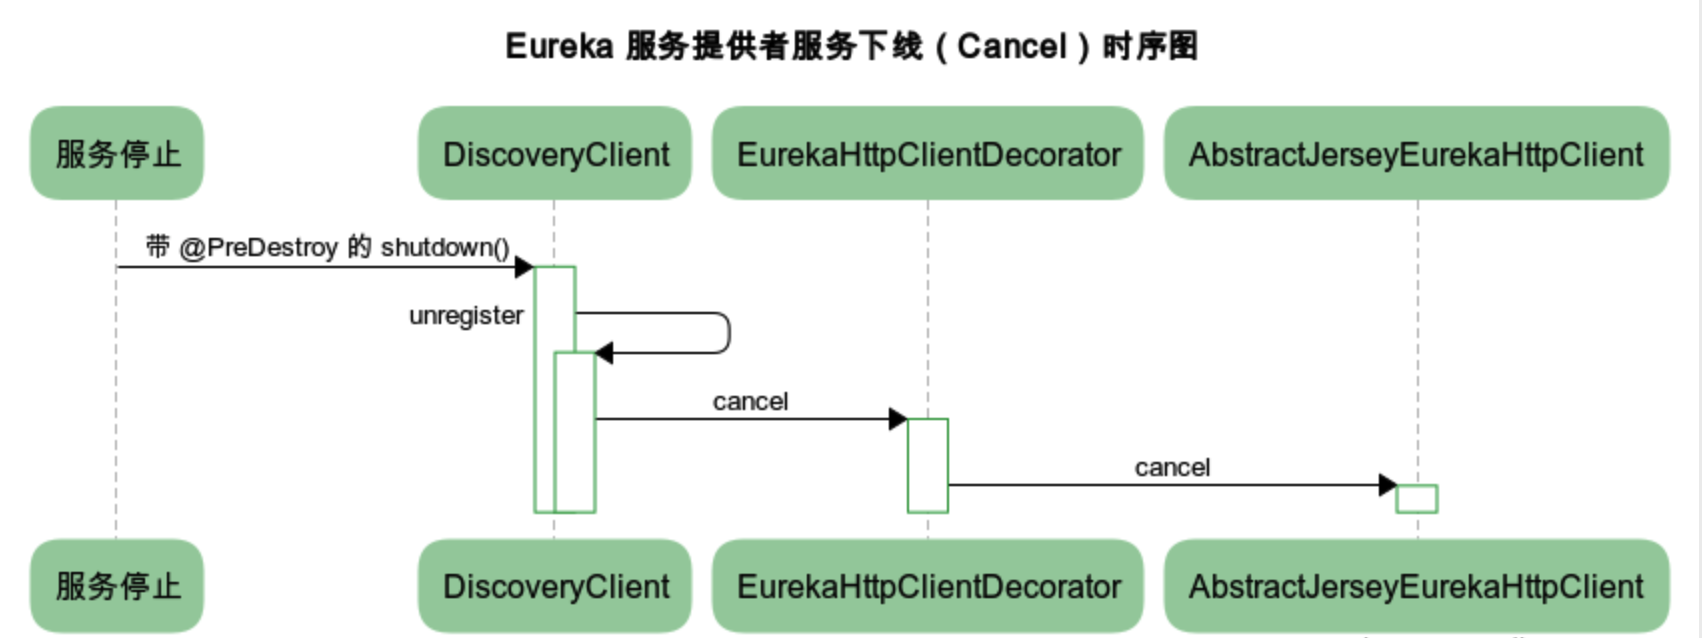
当服务提供者方服务停止时,要发送 DELETE 请求告知注册中心 Eureka Server 自己已经下线,好让注册中心将自己剔除下线,防止服务消费方从注册中心获取到不可用的服务。这个
过程实现比较简单,在类 DiscoveryClient 的 shutdown 方法加上注解 @PreDestroy,当服务停止时会自动触发服务剔除下线,执行服务下线逻辑,主要调用流程如下图所示:
服务消费者(Service Consumer)
这里的服务消费者如果不需要被其它服务调用的话,其实只会涉及到两个操作,分别是从注册
获取服务列表(Fetch)
的时候执行的。
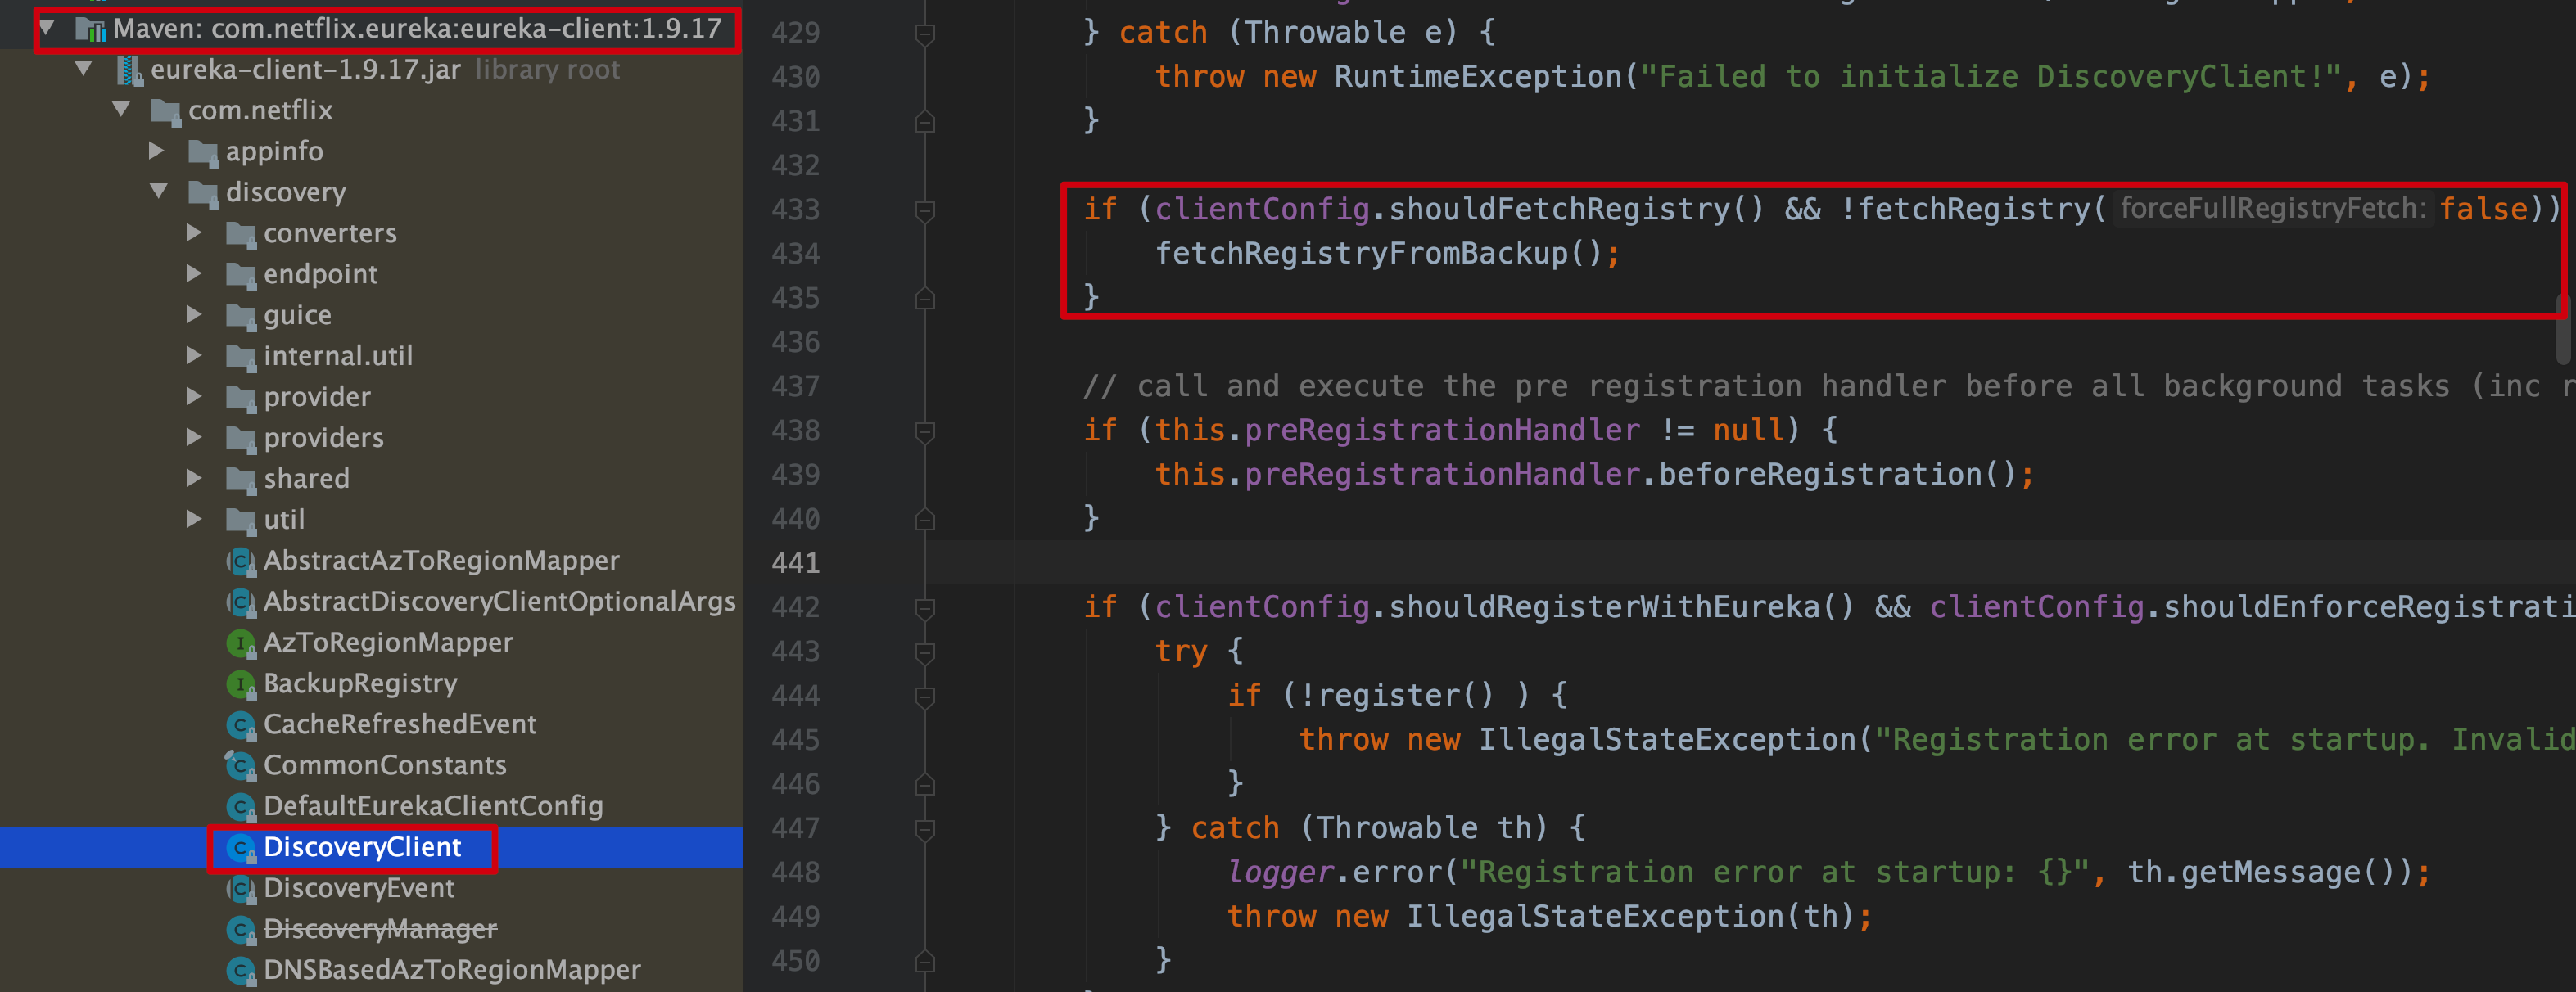
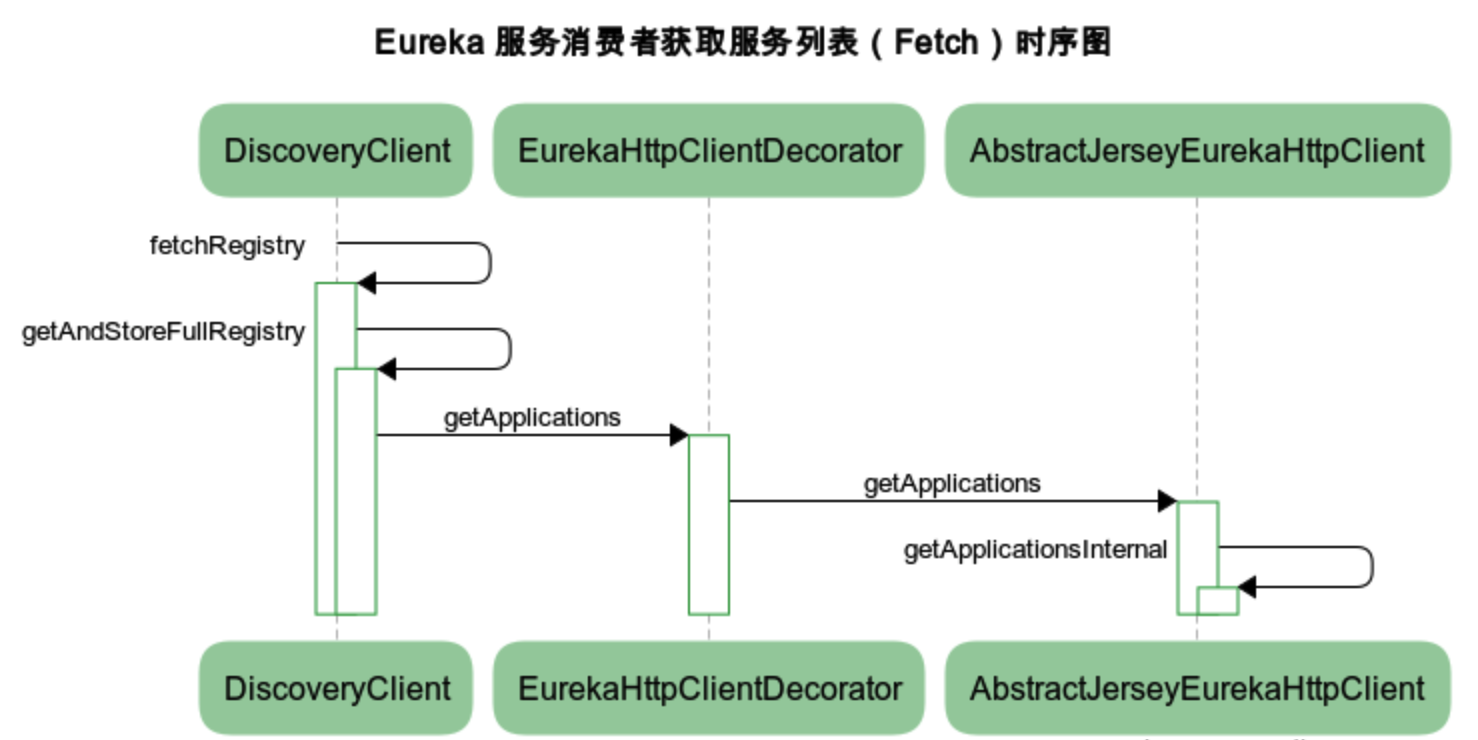
可以看出,能发生这个获取服务列表的操作前提是要保证配置了 eureka.client.fetchregistry=true,该配置的默认值为 true,主要调用流程如下图所示:
更新服务列表(Update)
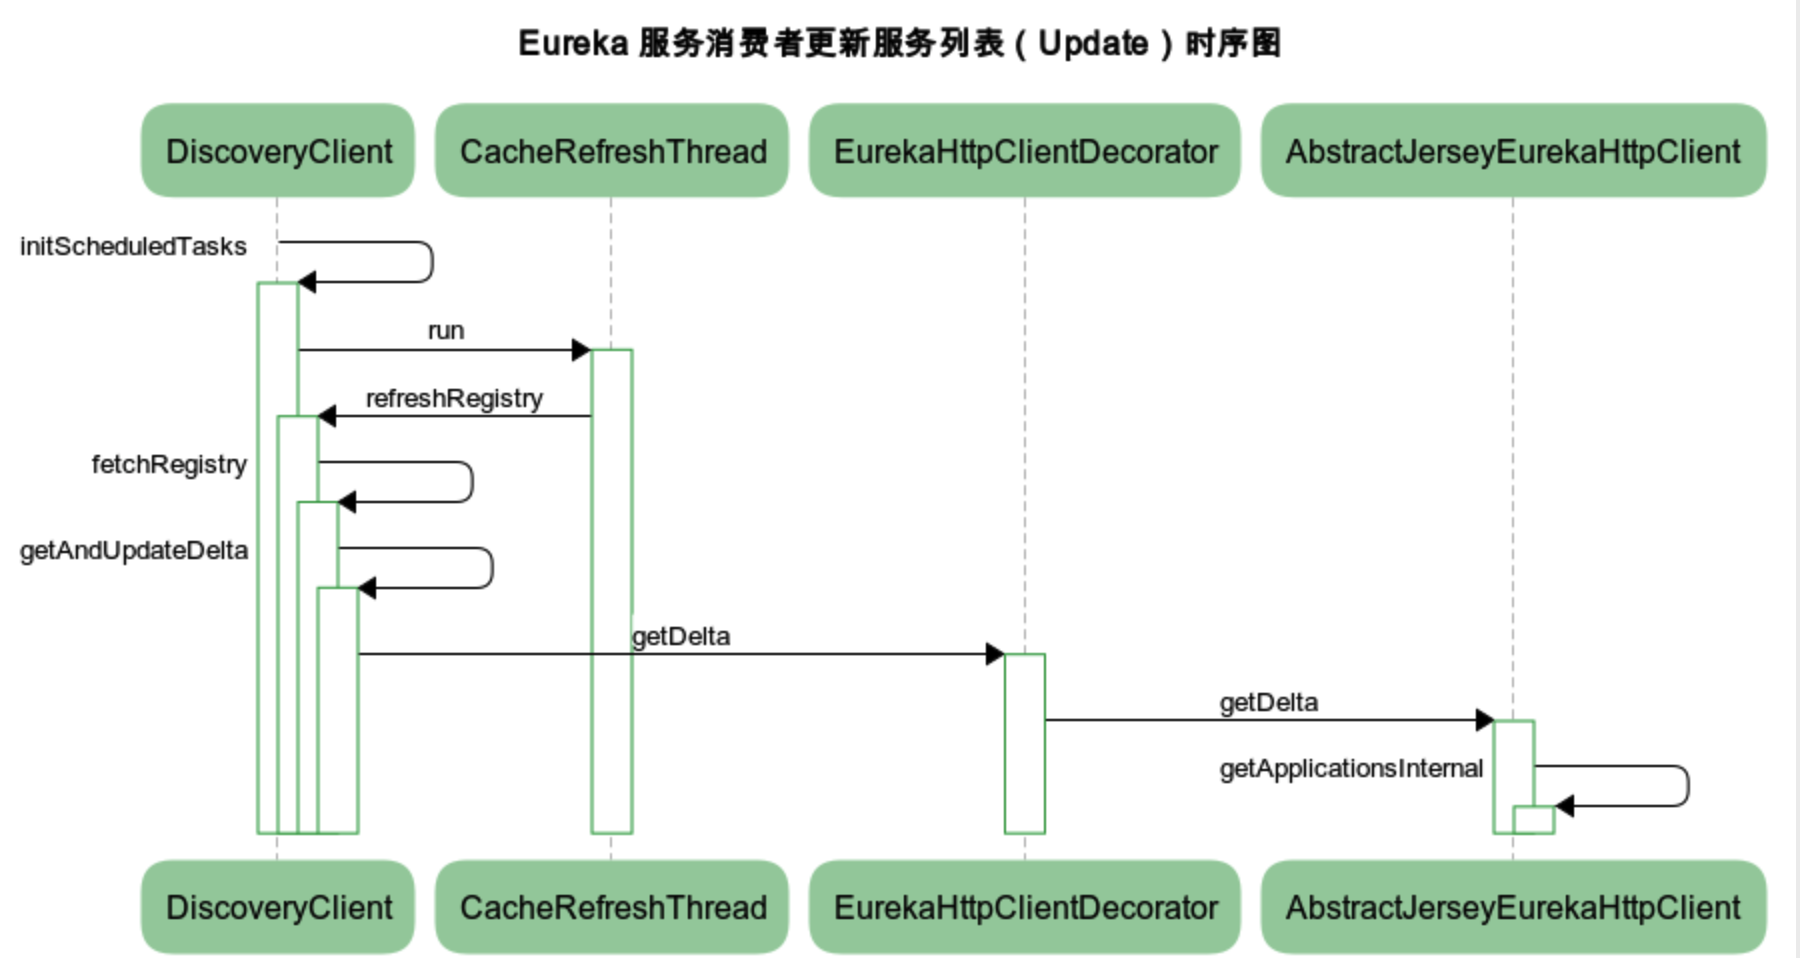
由上面的获取服务列表(Fetch)操作过程可知,本地也会缓存一份,所以这里需要定期的去到注册中心 Eureka Server 获取服务的最新配置,然后比较更新本地缓存,这个更新的间隔
时间可以通过配置 eureka.client.registry-fetch-interval-seconds 修改,默认为 30
总结
工作中项目使用的是 Spring Cloud 技术栈,它有一套非常完善的开源代码来整合 Eureka ,使用起来非常方便。之前都是直接加注解和修改几个配置属性一气呵成的,没有深入了解过
源码实现,本文主要是阐述了服务注册、服务发现等相关过程和实现方式,对 Eureka 服务发现组件有了更近一步的了解。
参考文章
Netflix Eureka
Service Discovery in a Microservices Architecture
如何从大量的URL中找出相同的URL?
题目描述
给定 a、b 两个文件,各存放 50 亿个 URL,每个 URL 各占 64B,内存限制是 4G。请找出 a、b 两个文件共同的 URL。
解答思路
全站分卷索引 · 72 卷
- 1互联网 Java 工程师进阶知识完全扫盲
- 2为什么使用消息队列?
- 3如何保证消息队列的高可用?
- 4如何保证消息不被重复消费?
- 5如何保证消息的可靠性传输?
- 6如何保证消息的顺序性?
- 7如何解决消息队列的延时以及过期失效问题?
- 8如何设计一个消息队列?
- 9搜索引擎
- 10ES 的分布式架构原理是什么?
- 11ES 写入数据的工作原理是什么?
- 12ES 在数十亿级别数量下如何提高查询效率?
- 13ES 生产集群的部署架构是什么?
- 14缓存
- 15Redis 和 Memcached 有什么区别?
- 16Redis 都有哪些数据类型以及适用场景?
- 17Redis 的过期策略都有哪些?
- 18如何保证 Redis 高并发、高可用?
- 19Redis 主从架构是怎样的?
- 20Redis 的持久化有哪几种方式?
- 21Redis 如何基于哨兵集群实现高可用?
- 22Redis 集群模式的工作原理能说一下么?
- 23Redis 的雪崩、穿透和击穿,如何应对?
- 24如何保证缓存与数据库双写一致性?
- 25如何解决 Redis 的并发竞争问题?
- 26生产环境中的 Redis 是怎么部署的?
- 27分库分表如何平滑过渡?
- 28设计一个动态扩容缩容的分库分表方案?
- 29分库分表之后,id 主键如何处理?
- 30读写分离
- 31高并发系统
- 32分布式系统
- 33系统拆分
- 34分布式服务框架
- 35Dubbo 支持哪些序列化协议?
- 36Dubbo 负载均衡策略和集群容错策略?
- 37Dubbo 的 SPI 思想是什么?
- 38如何基于 Dubbo 进行服务治理?
- 39分布式服务接口的幂等性如何设计?
- 40分布式服务接口请求的顺序性如何保证?
- 41如何自己设计一个类似 Dubbo 的 RPC 框架?
- 42CAP 定理的 P 是什么?
- 43分布式锁
- 44分布式锁如何设计?
- 45分布式事务
- 46分布式会话
- 47高可用架构
- 48电商网站详情页系统架构
- 49Hystrix 线程池技术实现资源隔离
- 50Hystrix 信号量机制实现资源隔离
- 51Hystrix 隔离策略细粒度控制
- 52深入 Hystrix 执行时内部原理
- 53基于 request cache 请求缓存技术优化批量商品数据查询接口
- 54基于本地缓存的 fallback 降级机制
- 55深入 Hystrix 断路器执行原理
- 56深入 Hystrix 线程池隔离与接口限流
- 57基于 timeout 机制为服务接口调用超时提供安全保护
- 58限流
- 59熔断
- 60微服务架构
- 61从单体式架构迁移到微服务架构
- 62微服务的事件驱动数据管理
- 63选择微服务部署策略
- 64Spring Cloud微服务架构
- 65你所知道的微服务技术栈都有哪些?
- 66谈谈服务发现组件 Eureka 的主要调用过程?
- 67海量数据处理
- 68如何找出某一天访问百度网站最多的 IP?
- 69如何在大量的数据中找出不重复的整数?
- 70如何在大量的数据中判断一个数是否存在?
- 71如何统计不同电话号码的个数?
- 72如何按照 query 的频度排序?