从单体式架构迁移到微服务架构
11: Adrian Cockcro specifically mentions "developer self-service" and "Developers run what they wrote"(sic) in this excellent presentation delivered at Flowcon in November, 2013.
12: We are being a little disengenuous here. Obviously deploying more services, in more complex topologies is more di icult than deploying a single monolith. Fortunately, patterns reduce this
complexity - investment in tooling is still a must though.
13: In fact, Dan North refers to this style as Replaceable Component Architecture rather than microservices. Since this seems to talk to a subset of the characteristics we prefer the latter.
14: Kent Beck highlights this as one his design principles in Implementation Patterns.
15: And SOA is hardly the root of this history. I remember people saying "we've been doing this for years" when the SOA term appeared at the beginning of the century. One argument was that this
style sees its roots as the way COBOL programs communicated via data files in the earliest days of enterprise computing. In another direction, one could argue that microservices are the same thing
as the Erlang programming model, but applied to an enterprise application context.
迁移到微服务综述
迁移单体式应用到微服务架构意味着一系列现代化过程,有点像这几代开发者一直在做的事情,实时上,当迁移时,我们可以重用一些想法。
一个策略是:不要大规模(big bang)重写代码(只有当你承担重建一套全新基于微服务的应用时候可以采用重写这种方法)。重写代码听起来很不错,但实际上充满了风险最终可能会失
败,就如 Martin Fowler 所说:
“the only thing a Big Bang rewrite guarantees is a Big Bang!”
相反,应该采取逐步迁移单体式应用的策略,通过逐步生成微服务新应用,与旧的单体式应用集成,随着时间推移,单体式应用在整个架构中比例逐渐下降直到消失或者成为微服务架构一
部分。这个策略有点像在高速路上限速到 70 迈对车做维护,尽管有挑战,但是比起重写的风险小很多。
Martin Fowler 将这种现代化策略成为绞杀(Strangler)应用,名字来源于雨林中的绞杀藤
策略1——停止挖掘
Law of Holes 是说当自己进洞就应该停止挖掘。对于单体式应用不可管理时这是最佳建议。换句话说,应该停止让单体式应用继续变大,也就是说当开发新功能时不应该为旧单体应用添加
新代码,最佳方法应该是将新功能开发成独立微服务。如下图所示:
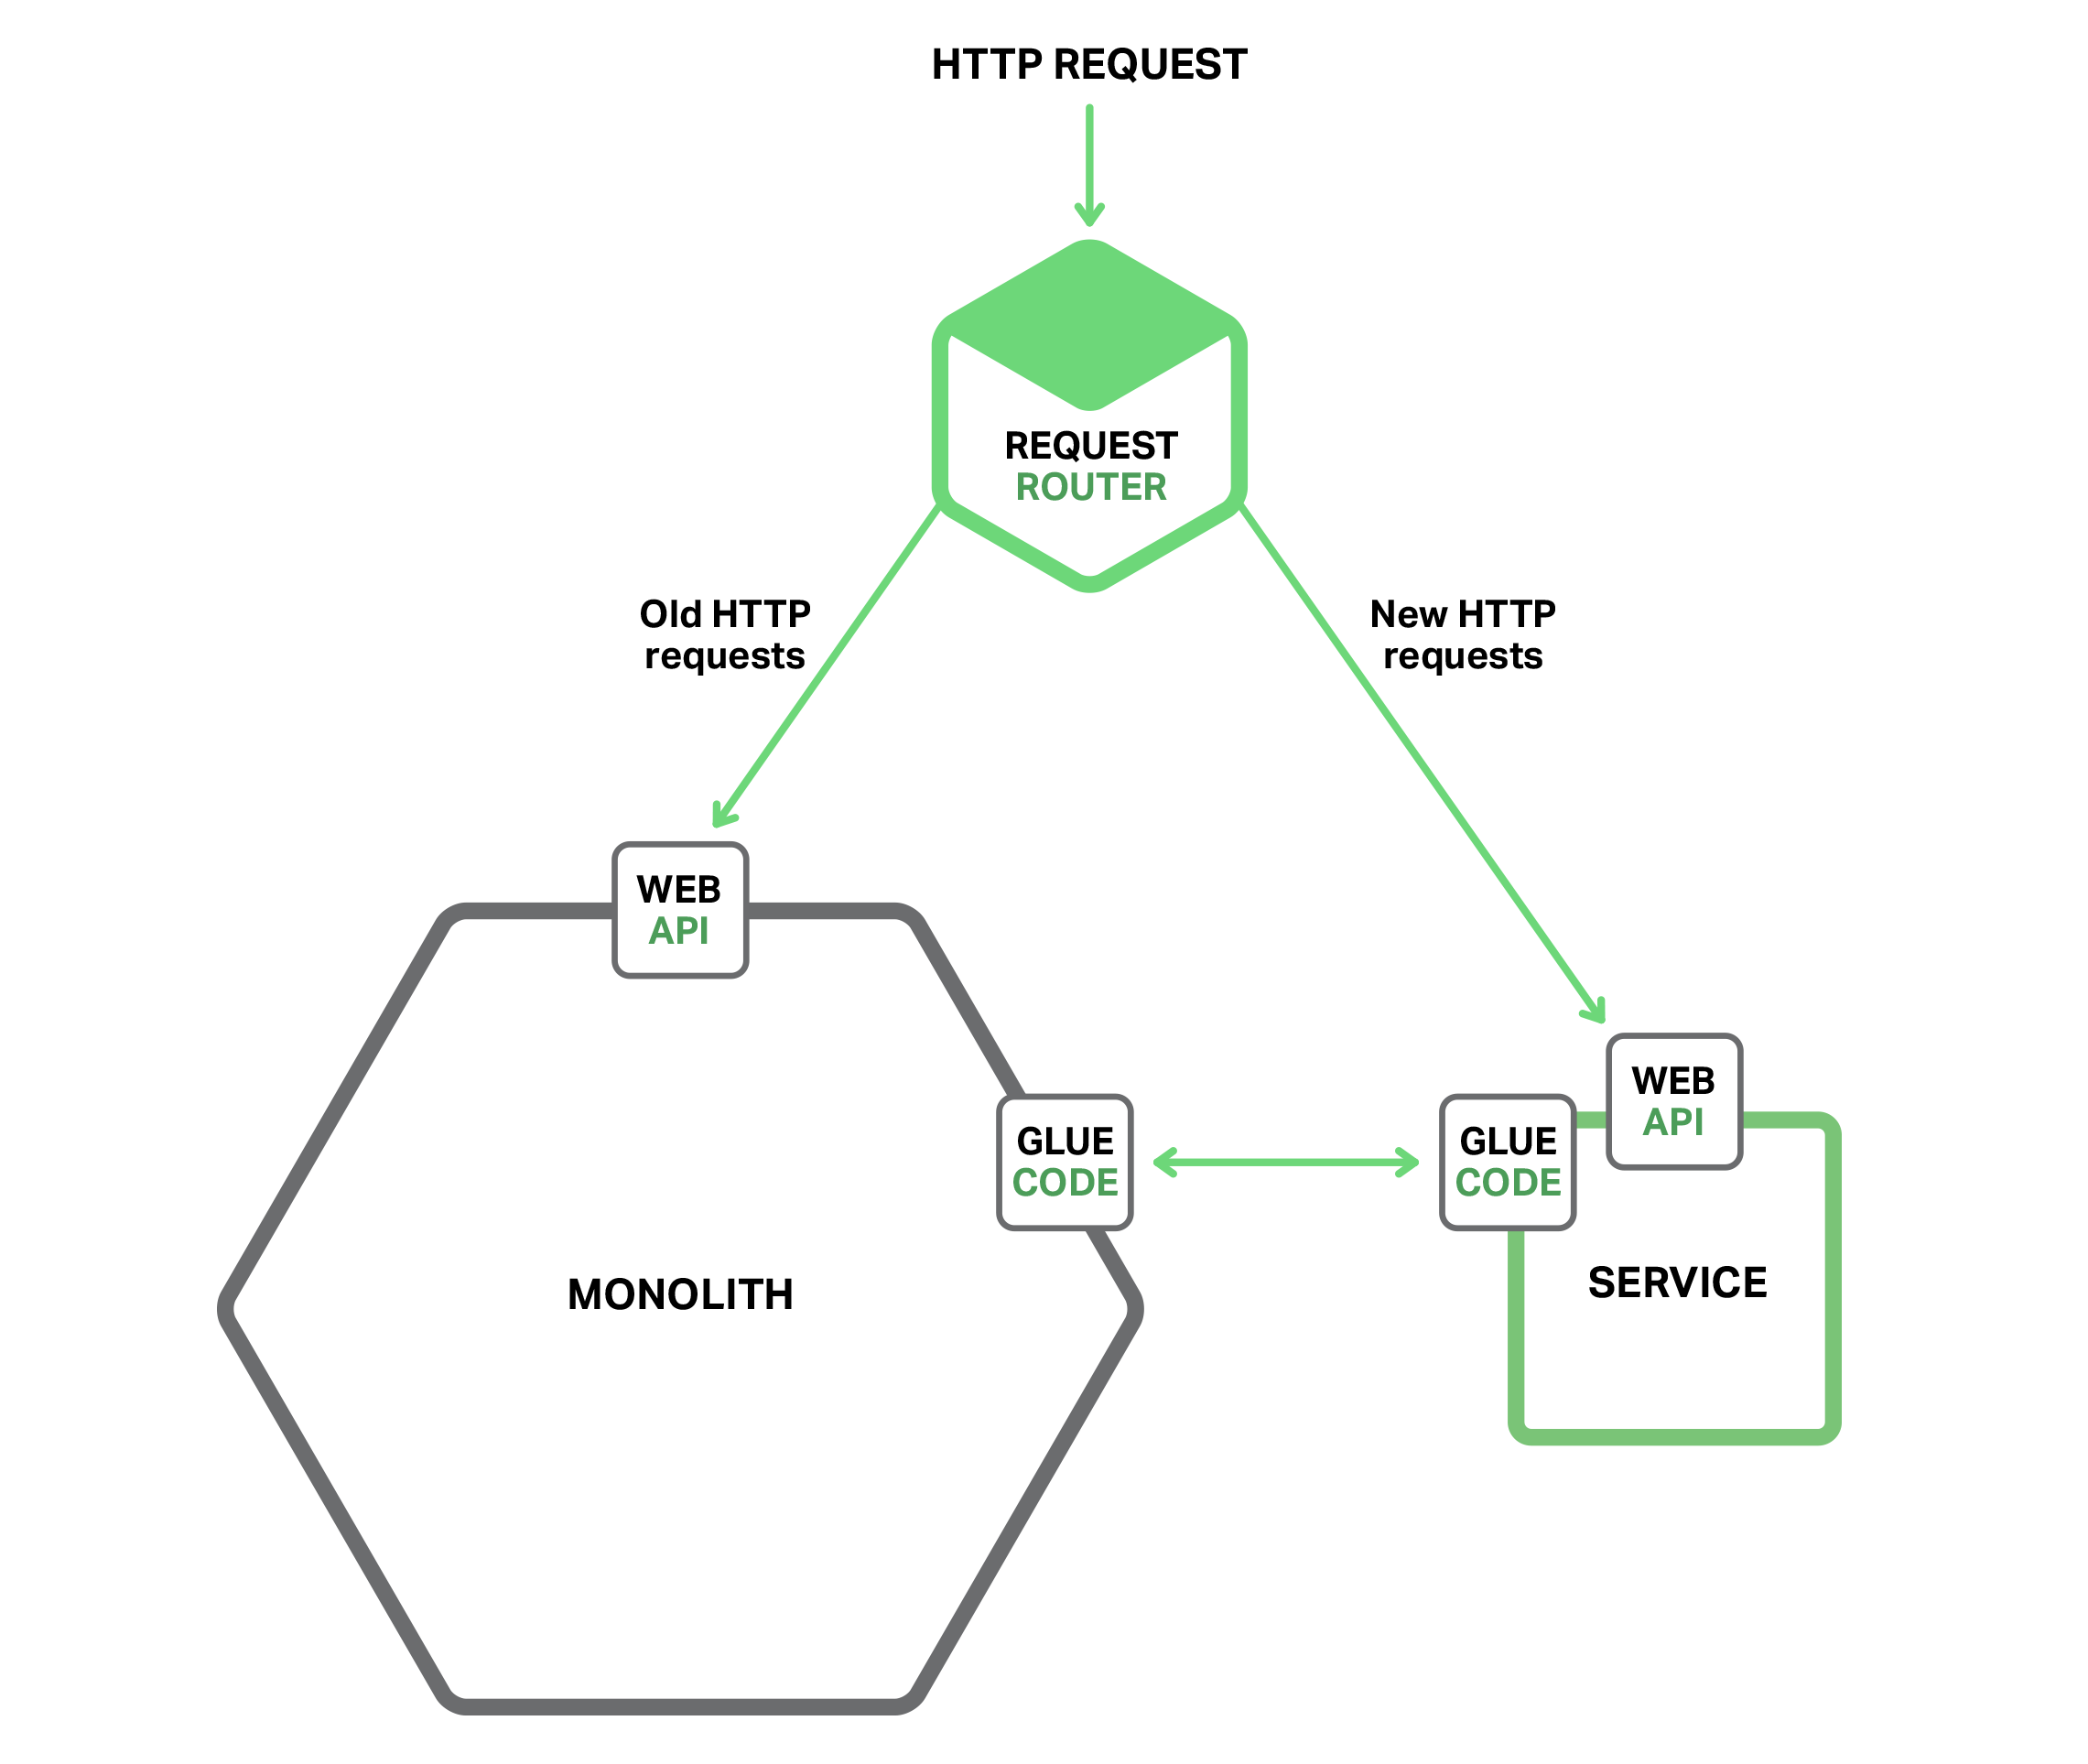
除了新服务和传统应用,还有两个模块,其一是请求路由器,负责处理入口(http)请求,有点像之前提到的 API 网关。路由器将新功能请求发送给新开发的服务,而将传统请求还发给单
体式应用。
另外一个是胶水代码(glue code),将微服务和单体应用集成起来,微服务很少能独立存在,经常会访问单体应用的数据。胶水代码,可能在单体应用或者为服务或者二者兼而有之,负责
数据整合。微服务通过胶水代码从单体应用中读写数据。
微服务有三种方式访问单体应用数据:
将新功能以轻量级微服务方式实现由很多优点,例如可以阻止单体应用变的更加无法管理。微服务本身可以开发、部署和独立扩展。采用微服务架构会给开发者带来不同的切身感受。
然而,这方法并不解决任何单体式本身问题,为了解决单体式本身问题必须深入单体应用做出改变。我们来看看这么做的策略。
策略2——将前端和后端分离
减小单体式应用复杂度的策略是讲表现层和业务逻辑、数据访问层分开。典型的企业应用至少有三个不同元素构成:
- 表现层——处理 HTTP 请求,要么响应一个 RESTAPI 请求,要么是提供一个基于 HTML 的图
形接口。对于一个复杂用户接口应用,表现层经常是代码重要的部分。
- 业务逻辑层——完成业务逻辑的应用核心。
- 数据访问层——访问基础元素,例如数据库和消息代理。
在表现层与业务数据访问层之间有清晰的隔离。业务层有由若干方面组成的粗粒度(coarsegrained)的 API,内部包含了业务逻辑元素。API 是可以将单体业务分割成两个更小应用的天然
边界,其中一个应用是表现层,另外一个是业务和数据访问逻辑。分割后,表现逻辑应用远程调用业务逻辑应用,下图表示迁移前后架构不同:
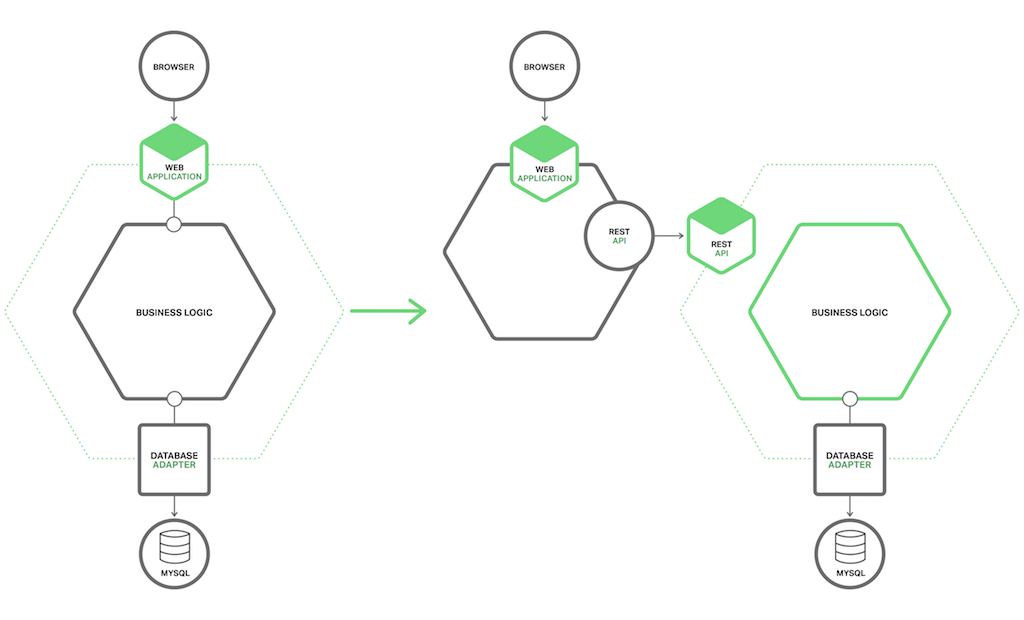
然而,这种策略只是部分的解决方案。很可能应用的两部分之一或者全部都是不可管理的,因此需要使用第三种策略来消除剩余的单体架构。
策略3——抽出服务
第三种迁移策略就是从单体应用中抽取出某些模块成为独立微服务。每当抽取一个模块变成微服务,单体应用就变简单一些;一旦转换足够多的模块,单体应用本身已经不成为问题了,要
么消失了,要么简单到成为一个服务。
排序那个模块应该被转成微服务
一个巨大的复杂单体应用由成十上百个模块构成,每个都是被抽取对象。决定第一个被抽取模块一般都是挑战,一般最好是从最容易抽取的模块开始,这会让开发者积累足够经验,这些经
验可以为后续模块化工作带来巨大好处。
转换模块成为微服务一般很耗费时间,一般可以根据获益程度来排序,一般从经常变化模块开始会获益最大。一旦转换一个模块为微服务,就可以将其开发部署成独立模块,从而加速开发
进程。
将资源消耗大户先抽取出来也是排序标准之一。例如,将内存数据库抽取出来成为一个微服务会非常有用,可以将其部署在大内存主机上。同样的,将对计算资源很敏感的算法应用抽取出
来也是非常有益的,这种服务可以被部署在有很多 CPU 的主机上。通过将资源消耗模块转换成微服务,可以使得应用易于扩展。
查找现有粗粒度边界来决定哪个模块应该被抽取,也是很有益的,这使得移植工作更容易和简单。例如,只与其他应用异步同步消息的模块就是一个明显边界,可以很简单容易地将其转换
为微服务。
如何抽取模块
抽取模块第一步就是定义好模块和单体应用之间粗粒度接口,由于单体应用需要微服务的数据,反之亦然,因此更像是一个双向 API。因为必须在负责依赖关系和细粒度接口模式之间做
好平衡,因此开发这种 API 很有挑战性,尤其对使用域模型模式的业务逻辑层来说更具有挑战,因此经常需要改变代码来解决依赖性问题,如图所示:
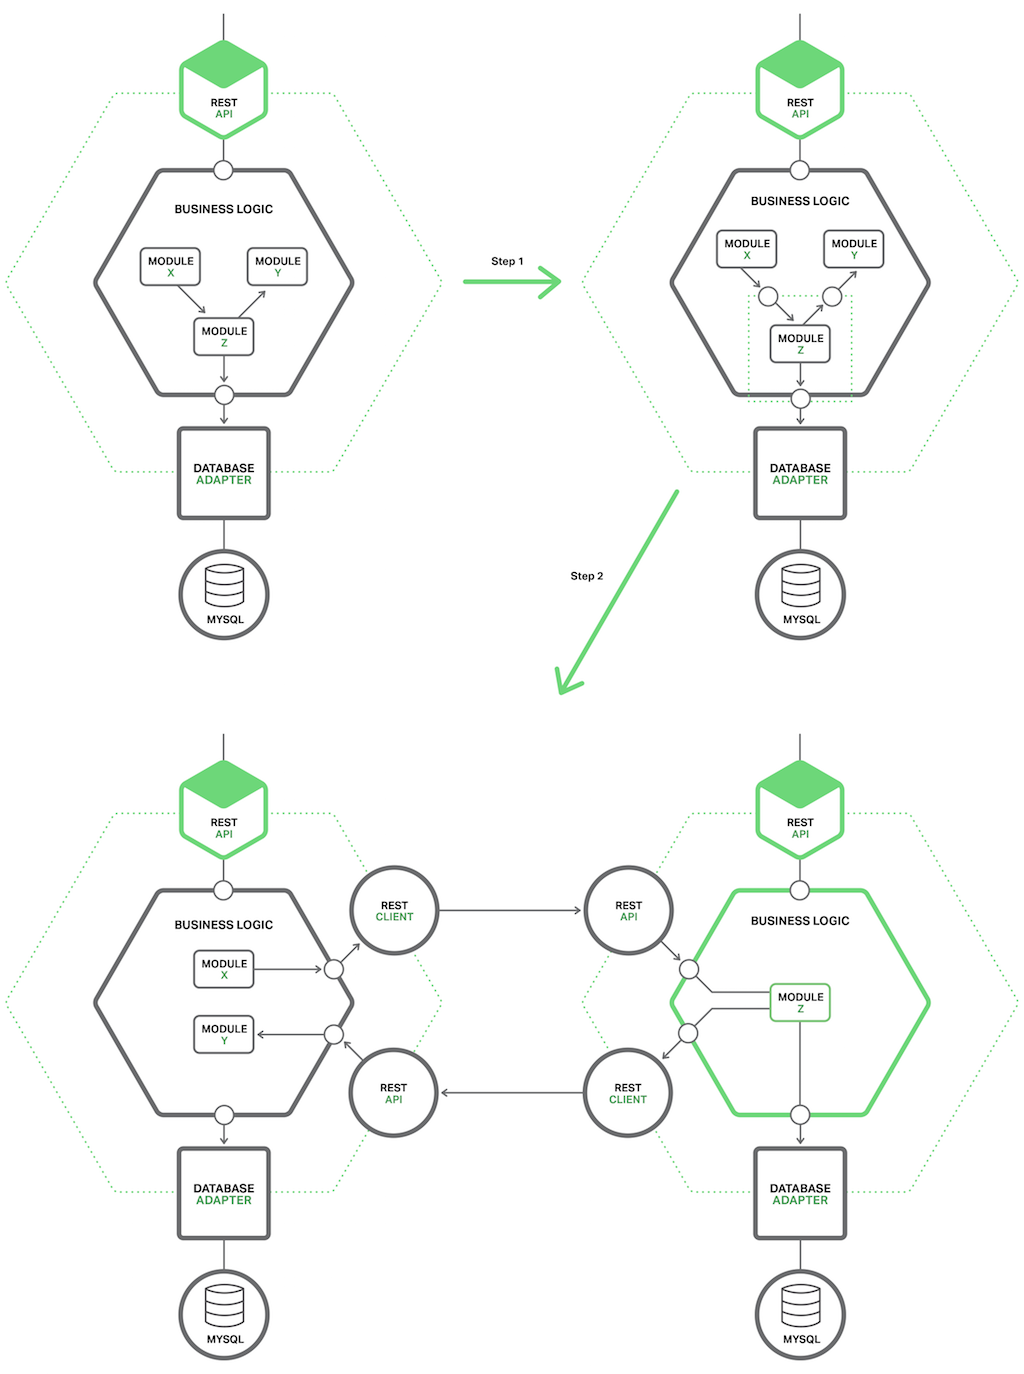
此例中,正在使用 Y 模块的 Z 模块是备选抽取模块,其元素正在被 X 模块使用,迁移第一步就是定义一套粗粒度 APIs,第一个接口应该是被 X 模块使用的内部接口,用于激活 Z 模块;第二
个接口是被 Z 模块使用的外部接口,用于激活 Y 模块。
全站分卷索引 · 72 卷
- 1互联网 Java 工程师进阶知识完全扫盲
- 2为什么使用消息队列?
- 3如何保证消息队列的高可用?
- 4如何保证消息不被重复消费?
- 5如何保证消息的可靠性传输?
- 6如何保证消息的顺序性?
- 7如何解决消息队列的延时以及过期失效问题?
- 8如何设计一个消息队列?
- 9搜索引擎
- 10ES 的分布式架构原理是什么?
- 11ES 写入数据的工作原理是什么?
- 12ES 在数十亿级别数量下如何提高查询效率?
- 13ES 生产集群的部署架构是什么?
- 14缓存
- 15Redis 和 Memcached 有什么区别?
- 16Redis 都有哪些数据类型以及适用场景?
- 17Redis 的过期策略都有哪些?
- 18如何保证 Redis 高并发、高可用?
- 19Redis 主从架构是怎样的?
- 20Redis 的持久化有哪几种方式?
- 21Redis 如何基于哨兵集群实现高可用?
- 22Redis 集群模式的工作原理能说一下么?
- 23Redis 的雪崩、穿透和击穿,如何应对?
- 24如何保证缓存与数据库双写一致性?
- 25如何解决 Redis 的并发竞争问题?
- 26生产环境中的 Redis 是怎么部署的?
- 27分库分表如何平滑过渡?
- 28设计一个动态扩容缩容的分库分表方案?
- 29分库分表之后,id 主键如何处理?
- 30读写分离
- 31高并发系统
- 32分布式系统
- 33系统拆分
- 34分布式服务框架
- 35Dubbo 支持哪些序列化协议?
- 36Dubbo 负载均衡策略和集群容错策略?
- 37Dubbo 的 SPI 思想是什么?
- 38如何基于 Dubbo 进行服务治理?
- 39分布式服务接口的幂等性如何设计?
- 40分布式服务接口请求的顺序性如何保证?
- 41如何自己设计一个类似 Dubbo 的 RPC 框架?
- 42CAP 定理的 P 是什么?
- 43分布式锁
- 44分布式锁如何设计?
- 45分布式事务
- 46分布式会话
- 47高可用架构
- 48电商网站详情页系统架构
- 49Hystrix 线程池技术实现资源隔离
- 50Hystrix 信号量机制实现资源隔离
- 51Hystrix 隔离策略细粒度控制
- 52深入 Hystrix 执行时内部原理
- 53基于 request cache 请求缓存技术优化批量商品数据查询接口
- 54基于本地缓存的 fallback 降级机制
- 55深入 Hystrix 断路器执行原理
- 56深入 Hystrix 线程池隔离与接口限流
- 57基于 timeout 机制为服务接口调用超时提供安全保护
- 58限流
- 59熔断
- 60微服务架构
- 61从单体式架构迁移到微服务架构
- 62微服务的事件驱动数据管理
- 63选择微服务部署策略
- 64Spring Cloud微服务架构
- 65你所知道的微服务技术栈都有哪些?
- 66谈谈服务发现组件 Eureka 的主要调用过程?
- 67海量数据处理
- 68如何找出某一天访问百度网站最多的 IP?
- 69如何在大量的数据中找出不重复的整数?
- 70如何在大量的数据中判断一个数是否存在?
- 71如何统计不同电话号码的个数?
- 72如何按照 query 的频度排序?