如何保证消息的顺序性?
所以此时一般是要求起码设置如下 4 个参数:
给 topic 设置 replication.factor 参数:这个值必须大于 1,要求每个 partition 必须有至少 2 个副本。
在 Kafka 服务端设置 min.insync.replicas 参数:这个值必须大于 1,这个是要求一个 leader 至少感知到有至少一个 follower 还跟自己保持联系,没掉队,这样才能确保 leader
挂了还有一个 follower 吧。
在 producer 端设置 acks=all:这个是要求每条数据,必须是写入所有 replica 之后,才能认为是写成功了。
在 producer 端设置 retries=MAX(很大很大很大的一个值,无限次重试的意思):这个是要求一旦写入失败,就无限重试,卡在这里了。
我们生产环境就是按照上述要求配置的,这样配置之后,至少在 Kafka broker 端就可以保证在 leader 所在 broker 发生故障,进行 leader 切换时,数据不会丢失。
生产者会不会弄丢数据?
如果按照上述的思路设置了 acks=all,一定不会丢,要求是,你的 leader 接收到消息,所有的 follower 都同步到了消息之后,才认为本次写成功了。如果没满足这个条件,生产者会自
动不断的重试,重试无限次。
面试题
如何保证消息的顺序性?
面试官心理分析
其实这个也是用 MQ 的时候必问的话题,第一看看你了不了解顺序这个事儿?第二看看你有没有办法保证消息是有顺序的?这是生产系统中常见的问题。
面试题剖析
发送到 MQ 里面,再消费出来依次执行,起码得保证人家是按照顺序来的吧?不然本来是:增加、修改、删除;你愣是换了顺序给执行成删除、修改、增加,不全错了么。
本来这个数据同步过来,应该最后这个数据被删除了;结果你搞错了这个顺序,最后这个数据保留下来了,数据同步就出错了。
先看看顺序会错乱的俩场景:
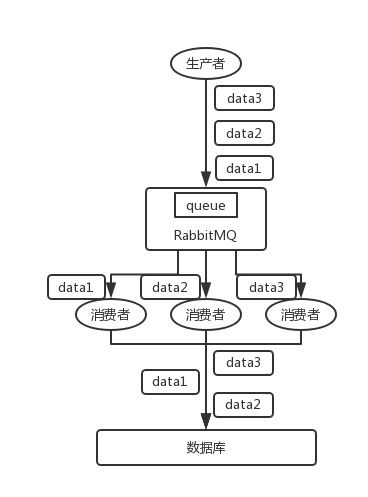
RabbitMQ:一个 queue,多个 consumer。比如,生产者向 RabbitMQ 里发送了三条数据,顺序依次是 data1/data2/data3,压入的是 RabbitMQ 的一个内存队列。有三个消费者分别从
MQ 中消费这三条数据中的一条,结果消费者2先执行完操作,把 data2 存入数据库,然后是 data1/data3。这不明显乱了。
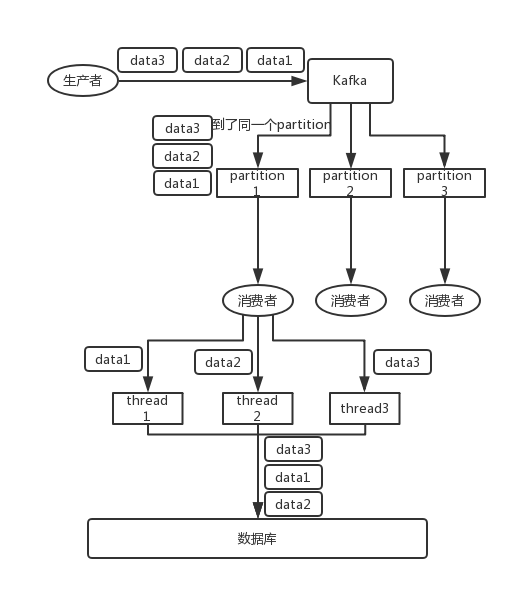
Kafka:比如说我们建了一个 topic,有三个 partition。生产者在写的时候,其实可以指定一个 key,比如说我们指定了某个订单 id 作为 key,那么这个订单相关的数据,一定会被分发
解决方案
RabbitMQ
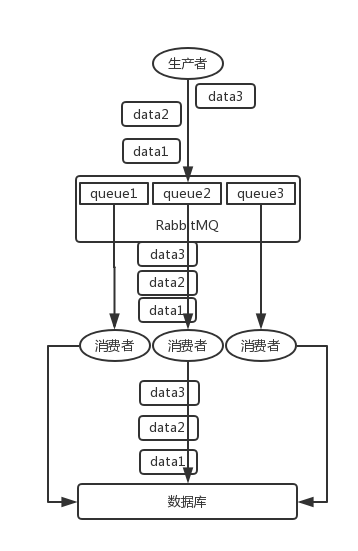
拆分多个 queue,每个 queue 一个 consumer,就是多一些 queue 而已,确实是麻烦点;或者就一个 queue 但是对应一个 consumer,然后这个 consumer 内部用内存队列做排队,然后分发
给底层不同的 worker 来处理。
Kafka
一个 topic,一个 partition,一个 consumer,内部单线程消费,单线程吞吐量太低,一般不会用这个。
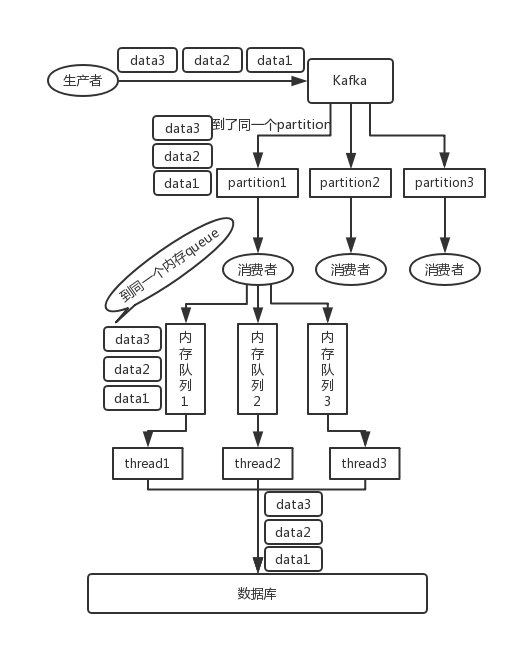
写 N 个内存 queue,具有相同 key 的数据都到同一个内存 queue;然后对于 N 个线程,每个线程分别消费一个内存 queue 即可,这样就能保证顺序性。
面试题
如何解决消息队列的延时以及过期失效问题?消息队列满了以后该怎么处理?有几百万消息持续积压几小时,说说怎么解决?
面试官心理分析
你看这问法,其实本质针对的场景,都是说,可能你的消费端出了问题,不消费了;或者消费的速度极其慢。接着就坑爹了,可能你的消息队列集群的磁盘都快写满了,都没人消费,这个
全站分卷索引 · 72 卷
- 1互联网 Java 工程师进阶知识完全扫盲
- 2为什么使用消息队列?
- 3如何保证消息队列的高可用?
- 4如何保证消息不被重复消费?
- 5如何保证消息的可靠性传输?
- 6如何保证消息的顺序性?
- 7如何解决消息队列的延时以及过期失效问题?
- 8如何设计一个消息队列?
- 9搜索引擎
- 10ES 的分布式架构原理是什么?
- 11ES 写入数据的工作原理是什么?
- 12ES 在数十亿级别数量下如何提高查询效率?
- 13ES 生产集群的部署架构是什么?
- 14缓存
- 15Redis 和 Memcached 有什么区别?
- 16Redis 都有哪些数据类型以及适用场景?
- 17Redis 的过期策略都有哪些?
- 18如何保证 Redis 高并发、高可用?
- 19Redis 主从架构是怎样的?
- 20Redis 的持久化有哪几种方式?
- 21Redis 如何基于哨兵集群实现高可用?
- 22Redis 集群模式的工作原理能说一下么?
- 23Redis 的雪崩、穿透和击穿,如何应对?
- 24如何保证缓存与数据库双写一致性?
- 25如何解决 Redis 的并发竞争问题?
- 26生产环境中的 Redis 是怎么部署的?
- 27分库分表如何平滑过渡?
- 28设计一个动态扩容缩容的分库分表方案?
- 29分库分表之后,id 主键如何处理?
- 30读写分离
- 31高并发系统
- 32分布式系统
- 33系统拆分
- 34分布式服务框架
- 35Dubbo 支持哪些序列化协议?
- 36Dubbo 负载均衡策略和集群容错策略?
- 37Dubbo 的 SPI 思想是什么?
- 38如何基于 Dubbo 进行服务治理?
- 39分布式服务接口的幂等性如何设计?
- 40分布式服务接口请求的顺序性如何保证?
- 41如何自己设计一个类似 Dubbo 的 RPC 框架?
- 42CAP 定理的 P 是什么?
- 43分布式锁
- 44分布式锁如何设计?
- 45分布式事务
- 46分布式会话
- 47高可用架构
- 48电商网站详情页系统架构
- 49Hystrix 线程池技术实现资源隔离
- 50Hystrix 信号量机制实现资源隔离
- 51Hystrix 隔离策略细粒度控制
- 52深入 Hystrix 执行时内部原理
- 53基于 request cache 请求缓存技术优化批量商品数据查询接口
- 54基于本地缓存的 fallback 降级机制
- 55深入 Hystrix 断路器执行原理
- 56深入 Hystrix 线程池隔离与接口限流
- 57基于 timeout 机制为服务接口调用超时提供安全保护
- 58限流
- 59熔断
- 60微服务架构
- 61从单体式架构迁移到微服务架构
- 62微服务的事件驱动数据管理
- 63选择微服务部署策略
- 64Spring Cloud微服务架构
- 65你所知道的微服务技术栈都有哪些?
- 66谈谈服务发现组件 Eureka 的主要调用过程?
- 67海量数据处理
- 68如何找出某一天访问百度网站最多的 IP?
- 69如何在大量的数据中找出不重复的整数?
- 70如何在大量的数据中判断一个数是否存在?
- 71如何统计不同电话号码的个数?
- 72如何按照 query 的频度排序?