选择微服务部署策略
前言
务应用简单些。
一个微服务应用由上百个服务构成,服务可以采用不同语言和框架分别写就。每个服务都是一个单一应用,可以有自己的部署、资源、扩展和监控需求。例如,可以根据服务需求运行若干
个服务实例,除此之外,每个实例必须有自己的 CPU,内存和 I/O 资源。尽管很复杂,但是更挑战的是服务部署必须快速、可靠和性价比高。
有一些微服务部署的模式,先讨论一下每个主机多服务实例的模式。
单主机多服务实例模式
部署微服务的一种方法就是单主机多服务实例模式,使用这种模式,需要提供若干台物理或者虚拟机,每台机器上运行多个服务实例。很多情况下,这是传统的应用部署方法。每个服务实
例运行一个或者多个主机的 well-known 端口,主机可以看做宠物。
下图展示的是这种架构:
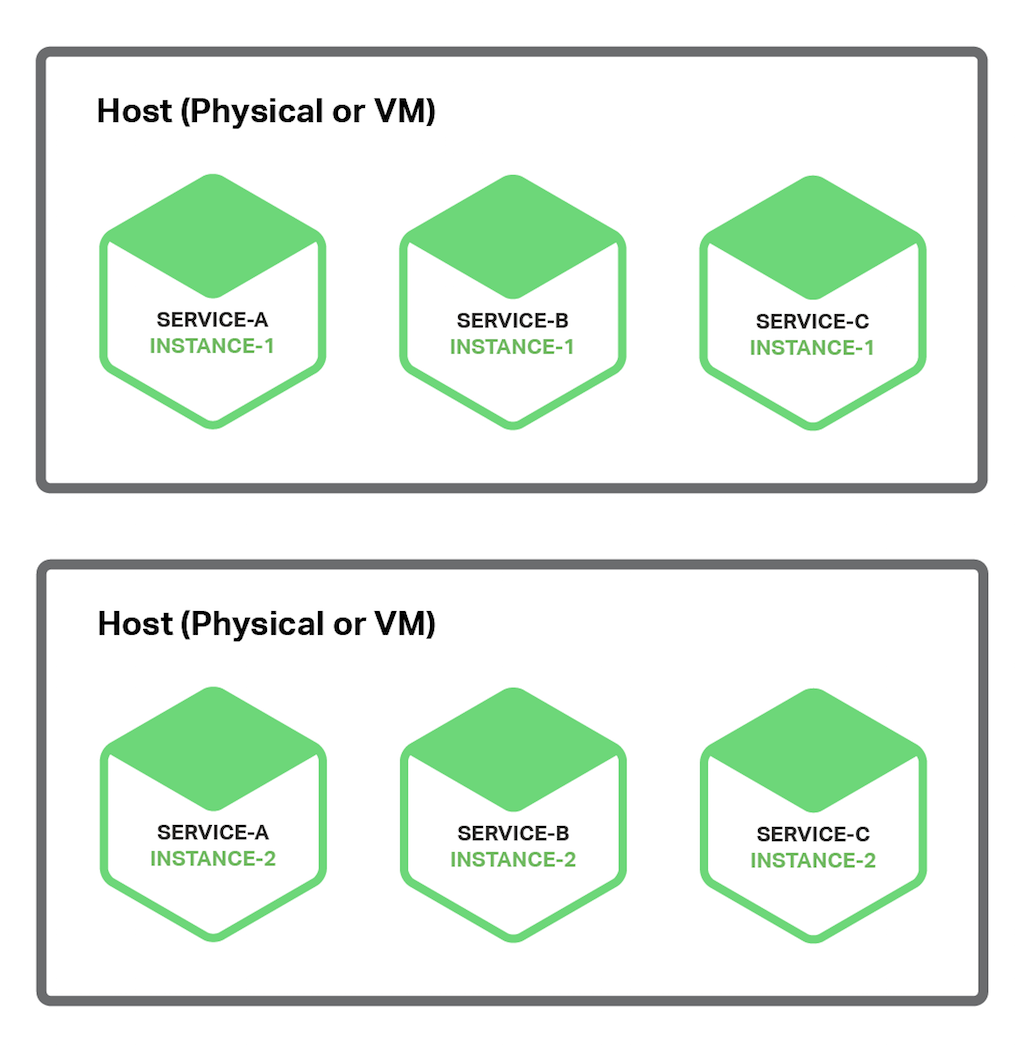
这种模式有一些参数,一个参数代表每个服务实例由多少进程构成。例如,需要在 Apache Tomcat Server 上部署一个 Java 服务实例作为 web 应用。一个 Node.js 服务实例可能有一个父
进程和若干个子进程构成。
另外一个参数定义同一进程组内有多少服务实例运行。例如,可以在同一个 Apache Tomcat Server 上运行多个 Java web 应用,或者在同一个 OSGI 容器内运行多个 OSGI 捆绑实例。
单主机多服务实例模式也是优缺点并存。主要优点在于资源利用有效性。多服务实例共享服务器和操作系统,如果进程组运行多个服务实例效率会更高,例如,多个 web 应用共享同一个
Apache Tomcat Server 和 JVM。
另一个优点在于部署服务实例很快。只需将服务拷贝到主机并启动它。如果服务用 Java 写的,只需要拷贝 JAR 或者 WAR 文件即可。对于其它语言,例如 Node.js 或者 Ruby,需要拷贝源
隔离,除非每个服务实例是独立进程。如果想精确监控每个服务实例资源使用,就不能限制每个实例资源使用。因此有可能造成某个糟糕的服务实例占用了主机的所有内存或者 CPU。
同一进程内多服务实例没有隔离。所有实例有可能,例如,共享同一个 JVM heap。某个糟糕服务实例很容易攻击同一进程中其它服务;更甚至于,有可能无法监控每个服务实例使用的资源
情况。
另一个严重问题在于运维团队必须知道如何部署的详细步骤。服务可以用不同语言和框架写成,因此开发团队肯定有很多需要跟运维团队沟通事项。其中复杂性增加了部署过程中出错的
可能性。
可以看到,尽管熟悉,但是单主机多服务实例有很多严重缺陷。下面看看是否有其他部署微服务方式能够避免这些问题。
单主机单服务实例模式
另外一种部署微服务方式是单主机单实例模式。当使用这种模式,每个主机上服务实例都是各自独立的。有两种不同实现模式:单虚拟机单实例和单容器单实例。
单虚拟机单实例模式
但是用单虚拟机单实例模式,一般将服务打包成虚拟机映像(image),例如一个 Amazon EC2 AMI。每个服务实例是一个使用此映像启动的 VM(例如,EC2 实例)。下图展示了此架构:
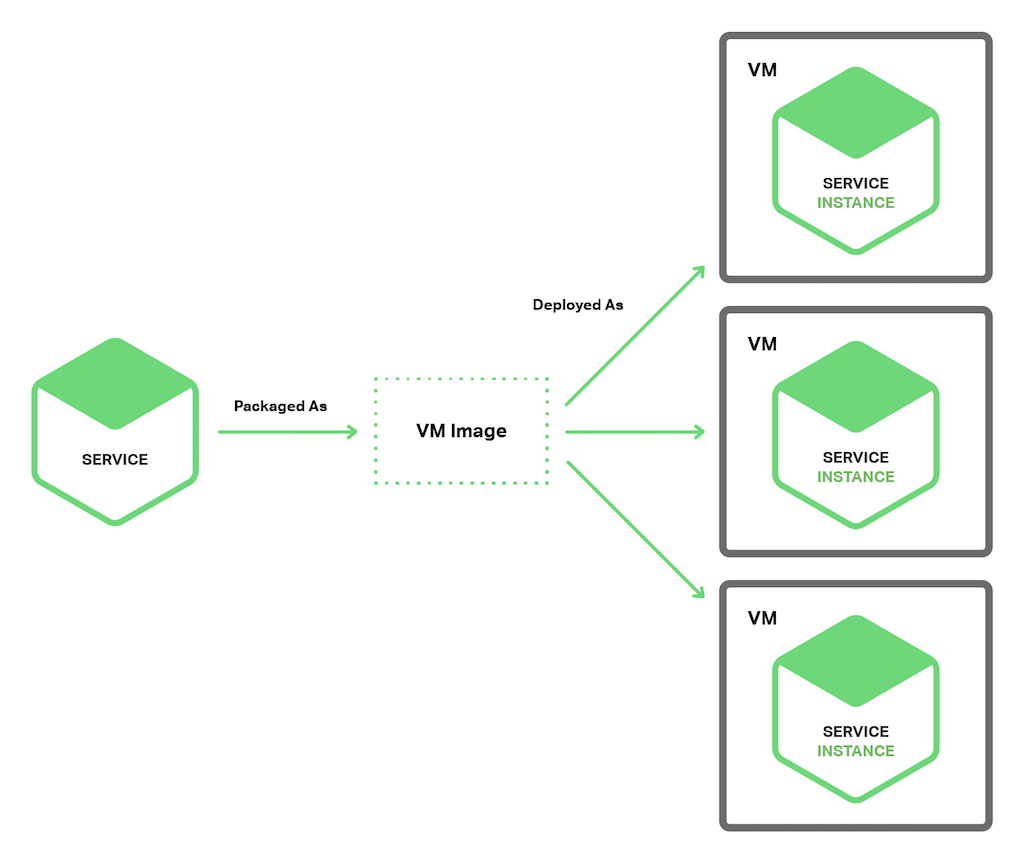
Netfix 采用这种架构部署 video streaming service。Netfix 使用 Aminator 将每个服务打包成一个 EC2 AMI。每个运行服务实例就是一个 EC2 实例。
有很多工具可以用来搭建自己的 VMs。可以配置持续集成(CI)服务(例如,Jenkins)避免 Aminator 将服务打包成 EC2 AMI。packer.io 是自动虚机映像创建的另外一种选择。跟 Aminator
不同,它支持一系列虚拟化技术,例如 EC2,DigitalOcean,VirtualBox 和 VMware。
Boxfuse 公司有一个创新方法创建虚机映像,克服了如下缺陷。Boxfuse 将 java 应用打包成最小虚机映像,它们创建迅速,启动很快,因为对外暴露服务接口少而更加安全。
CloudNative 公司有一个用于创建 EC2 AMI 的 SaaS 应用,Bakery。用户微服务架构通过测试后,可以配置自己的 CI 服务器激活 Bakery。Bakery 将服务打包成 AMI。使用如 Bakery 的 SaaS
应用意味着用户不需要浪费时间在设置自己的 AMI 创建架构。
每虚拟机服务实例模式有许多优势,主要的 VM 优势在于每个服务实例都是完全独立运行的,都有各自独立的 CPU 和内存而不会被其它服务占用。
另外一个好处在于用户可以使用成熟云架构,例如 AWS 提供的,云服务都提供如负载均衡和扩
的资源,包括操作系统。而且,在一个典型的公有 IaaS 环境,虚机资源都是标准化的,有可能未被充分利用。
而且,公有 IaaS 根据 VM 来收费,而不管虚机是否繁忙;例如 AWS 提供了自动扩展功能,但是对随需应用缺乏快速响应,使得用户不得不多部署虚机,从而增加了部署费用。
另外一个缺点在于部署服务新版本比较慢。虚机镜像因为大小原因创建起来比较慢,同样原因,虚机初始化也比较慢,操作系统启动也需要时间。但是这并不一直是这样,一些轻量级虚
机,例如使用 Boxfuse 创建的虚机,就比较快。
第三个缺点是对于运维团队,它们负责许多客制化工作。除非使用如 Boxfuse 之类的工具,可以帮助减轻大量创建和管理虚机的工作;否则会占用大量时间从事与核心业务不太无关的工
作。
那么我们来看看另外一种仍然具有虚机特性,但是比较轻量的微服务部署方法。
单容器单服务实例模式
当使用这种模式时,每个服务实例都运行在各自容器中。容器是运行在操作系统层面的虚拟化机制。一个容器包含若干运行在沙箱中的进程。从进程角度来看,他们有各自的命名空间和根
文件系统;可以限制容器的内存和 CPU 资源。某些容器还具有 I/O 限制,这类容器技术包括 Docker 和 Solaris Zones。
下图展示了这种模式:
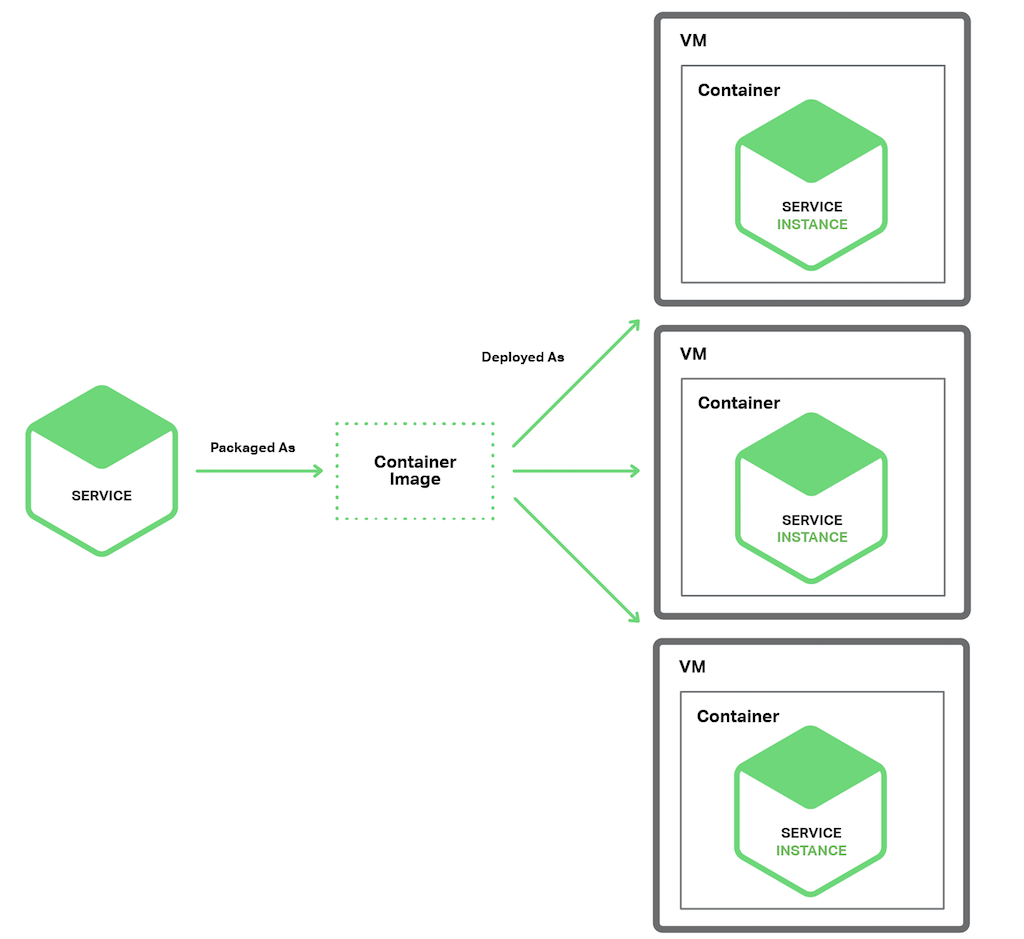
使用这种模式需要将服务打包成容器映像。一个容器映像是一个运行包含服务所需库和应用的文件系统。某些容器映像由完整的 linux 根文件系统组成,其它则是轻量级的。例如,为了部
署 Java 服务,需要创建包含 Java 运行库的容器映像,也许还要包含 Apache Tomcat server,以及编译过的 Java 应用。
一旦将服务打包成容器映像,就需要启动若干容器。一般在一个物理机或者虚拟机上运行多个容器,可能需要集群管理系统,例如 k8s 或者 Marathon,来管理容器。集群管理系统将主机作
为资源池,根据每个容器对资源的需求,决定将容器调度到那个主机上。
单容器单服务实例模式也是优缺点都有。容器的优点跟虚机很相似,服务实例之间完全独立,可以很容易监控每个容器消耗的资源。跟虚机相似,容器使用隔离技术部署服务。容器管理
API 也可以作为管理服务的 API。
然而,跟虚机不一样,容器是一个轻量级技术。容器映像创建起来很快,例如,在笔记本电脑上,将 Spring Boot 应用打包成容器映像只需要 5 秒钟。因为不需要操作系统启动机制,容器启
第三,容器经常被部署在按照虚机收费的架构上,很显然,客户也会增加部署费用来应对负载的增长。
有趣的是,容器和虚机之间的区别越来越模糊。如前所述,Boxfuse 虚机启动创建都很快, Clear Container 技术面向创建轻量级虚机。unikernel 公司的技术也引起大家关注,Docker 最近
收购了 Unikernel 公司。
除了这些之外,server-less 部署技术,避免了前述容器和 VM 技术的缺陷,吸引了越来越多的注意。下面我们来看看。
Serverless部署
AWS Lambda 是 serverless 部署技术的例子,支持 Java,Node.js 和 Python 服务;需要将服务打包成 ZIP 文件上载到 AWS Lambda 就可以部署。可以提供元数据,提供处理服务请求函数的
名字(一个事件)。AWS Lambda 自动运行处理请求足够多的微服务,然而只根据运行时间和消耗内存量来计费。当然细节决定成败,AWS Lambda 也有限制。但是大家都不需要担心服务
器,虚拟机或者容器内的任何方面绝对吸引人。
Lambda 函数是无状态服务。一般通过激活 AWS 服务处理请求。例如,当映像上载到 S3 bucket 激活 Lambda 函数后,就可以在 DynamoDB 映像表中插入一个条目,给 Kinesis 流发布
一条消息,触发映像处理动作。Lambda 函数也可以通过第三方 web 服务激活。
有四种方法激活 Lambda 函数:
直接方式,使用 web 服务请求自动方式,回应例如 AWS S3,DynamoDB,Kinesis 或者 Simple Email Service 等产生的事件
自动方式,通过 AWS API 网关来处理应用客户端发出的 HTTP 请求定时方式,通过 cron 响应--很像定时器方式
可以看出,AWS Lambda 是一种很方便部署微服务的方式。基于请求计费方式意味着用户只需要承担处理自己业务那部分的负载;另外,因为不需要了解基础架构,用户只需要开发自己的
应用。
然而还是有不少限制。不需要用来部署长期服务,例如用来消费从第三方代理转发来的消息,请求必须在 300 秒内完成,服务必须是无状态,因为理论上 AWS Lambda 会为每个请求生成一
个独立的实例;必须用某种支持的语言完成,服务必须启动很快,否则,会因为超时被停止。
部署微服务应用也是一种挑战。用各种语言和框架写成的服务成百上千。每种服务都是一种迷
全站分卷索引 · 72 卷
- 1互联网 Java 工程师进阶知识完全扫盲
- 2为什么使用消息队列?
- 3如何保证消息队列的高可用?
- 4如何保证消息不被重复消费?
- 5如何保证消息的可靠性传输?
- 6如何保证消息的顺序性?
- 7如何解决消息队列的延时以及过期失效问题?
- 8如何设计一个消息队列?
- 9搜索引擎
- 10ES 的分布式架构原理是什么?
- 11ES 写入数据的工作原理是什么?
- 12ES 在数十亿级别数量下如何提高查询效率?
- 13ES 生产集群的部署架构是什么?
- 14缓存
- 15Redis 和 Memcached 有什么区别?
- 16Redis 都有哪些数据类型以及适用场景?
- 17Redis 的过期策略都有哪些?
- 18如何保证 Redis 高并发、高可用?
- 19Redis 主从架构是怎样的?
- 20Redis 的持久化有哪几种方式?
- 21Redis 如何基于哨兵集群实现高可用?
- 22Redis 集群模式的工作原理能说一下么?
- 23Redis 的雪崩、穿透和击穿,如何应对?
- 24如何保证缓存与数据库双写一致性?
- 25如何解决 Redis 的并发竞争问题?
- 26生产环境中的 Redis 是怎么部署的?
- 27分库分表如何平滑过渡?
- 28设计一个动态扩容缩容的分库分表方案?
- 29分库分表之后,id 主键如何处理?
- 30读写分离
- 31高并发系统
- 32分布式系统
- 33系统拆分
- 34分布式服务框架
- 35Dubbo 支持哪些序列化协议?
- 36Dubbo 负载均衡策略和集群容错策略?
- 37Dubbo 的 SPI 思想是什么?
- 38如何基于 Dubbo 进行服务治理?
- 39分布式服务接口的幂等性如何设计?
- 40分布式服务接口请求的顺序性如何保证?
- 41如何自己设计一个类似 Dubbo 的 RPC 框架?
- 42CAP 定理的 P 是什么?
- 43分布式锁
- 44分布式锁如何设计?
- 45分布式事务
- 46分布式会话
- 47高可用架构
- 48电商网站详情页系统架构
- 49Hystrix 线程池技术实现资源隔离
- 50Hystrix 信号量机制实现资源隔离
- 51Hystrix 隔离策略细粒度控制
- 52深入 Hystrix 执行时内部原理
- 53基于 request cache 请求缓存技术优化批量商品数据查询接口
- 54基于本地缓存的 fallback 降级机制
- 55深入 Hystrix 断路器执行原理
- 56深入 Hystrix 线程池隔离与接口限流
- 57基于 timeout 机制为服务接口调用超时提供安全保护
- 58限流
- 59熔断
- 60微服务架构
- 61从单体式架构迁移到微服务架构
- 62微服务的事件驱动数据管理
- 63选择微服务部署策略
- 64Spring Cloud微服务架构
- 65你所知道的微服务技术栈都有哪些?
- 66谈谈服务发现组件 Eureka 的主要调用过程?
- 67海量数据处理
- 68如何找出某一天访问百度网站最多的 IP?
- 69如何在大量的数据中找出不重复的整数?
- 70如何在大量的数据中判断一个数是否存在?
- 71如何统计不同电话号码的个数?
- 72如何按照 query 的频度排序?