Web 编程基础
系统就是这样一步步演进过来的。
尽管在最后系统的架构已经不是当初的架构,而系统本身的业务逻辑变化并没有发生太大的变化。
特别是对于如博客这一类的系统来说,他的一些技术实现已经趋于稳定,而且是你经常使用的东西。所以,下次试试用新的技术的时候,可以先从对你的博客的重写开始。
Web 编程基础
从浏览器到服务器
如果你的操作系统带有 cURL 这个软件 (在 GNU/Linux、Mac OS 都自带这个工具, Windows用户可以从http://curl.haxx.se/download.html下载到),那么我们可以直接用
下面的命令来看这看这个过程 (-v 参数可以显示一次 http 通信的整个过程):
curl -v https://www.phodal.com
我们就会看到下面的响应过程:
- Rebuilt URL to: https://www.phodal.com/
*Trying 54.69.23.11...
- Connected to www.phodal.com (54.69.23.11) port 443 (#0)
- TLS 1.2 connection using TLS_ECDHE_RSA_WITH_AES_256_CBC_SHA384
- Server certificate: www.phodal.com
- Server certificate: COMODO RSA Domain Validation Secure Server CA
- Server certificate: COMODO RSA Certification Authority
- Server certificate: AddTrust External CA Root
> GET / HTTP/1.1 > Host: www.phodal.com
> User-Agent: curl/7.43.0 > Accept: */*
> < HTTP/1.1 403 Forbidden
< Server: phodal/0.19.4 < Date: Tue, 13 Oct 2015 05:32:13 GMT
< Content-Type: text/html; charset=utf-8
< Connection: keep-alive <
<html> <head><title>403 Forbidden</title></head>
<body bgcolor="white"> <center><h1>403 Forbidden</h1></center>
<hr><center>phodal/0.19.4</center> </body>
</html>
- Connection #0 to host www.phodal.com left intact
我们尝试用 cURL 去访问我的网站,会根据访问的域名找出其 IP,通常这个映射关系是来源于 ISP 缓存 DNS(英语:Domain Name System)服务器 [ˆDNSServer]。
以 “*” 开始的前 8 行是一些连接相关的信息,称为响应首部。我们向域名 https:
//www.phodal.com/发出了请求,接着 DNS 服务器告诉了我们网站服务器的 IP,即 54.69.23.11。出于安全考虑,在这里我们的示例,我们是以 HTTPS 协议为例,所以在
这里连接的端又是 443。因为使用的是 HTTPS 协议,所以在这里会试图去获取服务器证书,接着获取到了域名相关的证书信息。
随后以 “>” 开始的内容,便是向 Web 服务器发送请求。Host 即是我们要访问的主机的域名,GET / 则代表着我们要访问的是根目录,如果我们要访问 https:
//www.phodal.com/about/页面在这里,便是 GET 资源文件 /about。紧随其后的是 HTTP 的版本号(HTTP/1.1)。User-Agent 通过指向的是使用者行为的软件,通常会加
上硬件平台、系统软件、应用软件和用户个人偏好等等的一些信息。Accept则指的是告知服务器发送何种媒体类型。
这个过程,大致如下图所示:
在图中,我们会发现解析 DNS 的时候,我们需要先本地 DNS 服务器查询。如果没有的话,再向根域名服务器查询——这个域名由哪个服务器来解析。直至最后拿到真正
的服务器 IP 才能获取页面。
当我们拿到相应的 HTML、JS、CSS 后,我们就开始渲染这个页面了。
HTTP 协议说到这里,我们不得不说说 HTTP 协议——超文本传输协议。它也是一个基于文本的传输协议,这就是为什么你在上面看到的都是文本的传输过程。
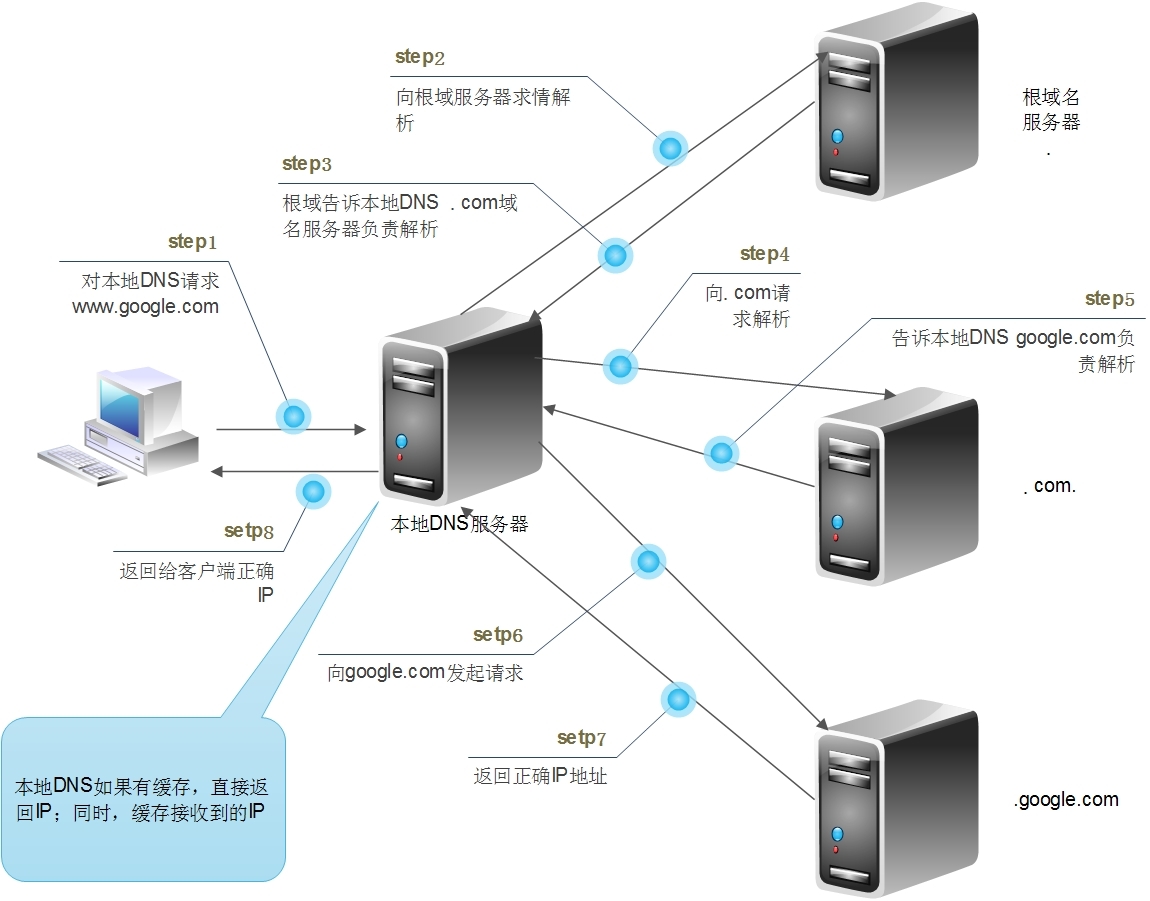
图 26: DNS 到服务器的过程
全站分卷索引 · 119 卷
- 1Growth: 全栈增长工程师指南
- 2软件开发的核心难题:沟通
- 3大公司的专家与小公司的全栈
- 4全栈工程师的未来:无栈
- 5基础知识篇
- 6工具只是辅助
- 7语言也是一种工具
- 8提高效率的工具
- 9IDE
- 10终端或命令提示符
- 11包管理
- 12环境搭建
- 13Windows
- 14GNU/Linux
- 15学好一门语言的艺术
- 16输出是最好的输入
- 17如何应用一门新的技术
- 18Web 编程基础
- 19从 HTML 到页面显示
- 20HTML
- 21中文?
- 22其他 HTML 标记
- 23小结
- 24CSS
- 25简介
- 26样式与目标
- 27更有趣的 CSS
- 28JavaScript
- 29JavaScriptFul
- 30面向对象
- 31其他
- 32前端与后台
- 33后台语言选择
- 34PHP
- 35Model
- 36View
- 37Controller
- 38后台即服务
- 39后台即服务
- 40数据库
- 41搜索引擎
- 42前端框架选择
- 43前台与后台交互
- 44JSON
- 45WebSocket
- 46编码过程
- 47Web 应用的构建系统
- 48Web 应用的构建过程
- 49Web 应用的构建实战
- 50Git 与版本控制
- 51Tasking
- 52Tasking 开发任务
- 53写代码只是在码字
- 54内置索引与外置引擎
- 55内置索引与外置引擎
- 56如何测试
- 57测试替身
- 58Mock
- 59测试先行
- 60可读的代码
- 61命名
- 62函数长度
- 63代码重构
- 64提炼函数
- 65内联函数
- 66查询取代临时变量
- 67重构到设计模式
- 68上线
- 69隔离硬件:虚拟机
- 70隔离操作系统:容器虚拟化
- 71隔离底层:Servlet 容器
- 72隔离依赖版本:虚拟环境
- 73隔离语言:DSL
- 74GNU/Linux
- 75HTTP 服务器
- 76数据库端缓存
- 77前端缓存
- 78运行机制
- 79自动化部署
- 80依赖与包仓库
- 81构建软件包
- 82数据分析
- 83想法-构建
- 84产品-衡量
- 85数据分析
- 86分析数据
- 87用户数据分析:Google Analytics
- 88流量获取
- 89移动应用
- 90网站性能
- 91SEO
- 92什么样的网站需要 SEO?
- 93内容
- 94UX 入门
- 95什么是简单?
- 96进阶
- 97认知设计
- 98持续交付
- 99持续集成系统
- 100持续交付
- 101持续部署
- 102持续阅读
- 103遗留系统与修改代码
- 104遗留代码
- 105修改遗留代码
- 106速度优化
- 107模块重构
- 108Retro
- 109三个维度
- 110架构模式
- 111预设计式架构
- 112演进式架构:拥抱变化
- 113意图导向
- 114重构
- 115模式与演进
- 116相关阅读资料
- 117架构解耦
- 118CQRS
- 119CQRS 结合微服务