前端缓存
我们这里说的前端缓存可以理解为一般使用的 cdn 技术,利用 squid 等做前端缓冲技术,主要还是针对静态文件类型,比如图片,css,js,html 等静态文件。
客户端缓存
浏览器端的缓存,可以让用户请求一次之后,下一次不在从服务器端请求数据,直接从本地缓存读取,可以减轻服务器负担也可以加快用户的访问速度。
HTML5 离线缓存
application cahce是将大部分图片资源、js、css等静态资源放在manifest文件配置中。当页面打开时通过 manifest 文件来读取本地文件或是请求服务器文件。
离线访问对基于网络的应用而言越来越重要。虽然所有浏览器都有缓存机制,但它们并不可靠,也不一定总能起到预期的作用。HTML5 使用 ApplicationCache 接又可以
解决由离线带来的部分难题。前提是你需要访问的 Web 页面至少被在线访问过一次。
可配置
让我们写的 Web 应用可配置是一项很有挑战性,也很实用的技能。
起先,我们在本地开发的时候为本地创建了一套环境,也创建了本地的配置。接着我们需要将我们的包部署到测试环境,也生成了测试环境的相应配置。这其中如果有其
他的环境,我们也需要创建相应的环境。最后,我们还需要为产品环境创建全新的配置。
下图是 Druapl 框架的部署流:
在不同的环境下,他们使用不同的 Content。这些 Content 的内容不仅仅可以是一些系统相当的配置,也可以是一些不同环境下的 UI 等等。而在这其中也会涉及到一些
比较复杂的知识,下面只是做一些简单的介绍。
环境配置
最常见的例子就是我们需要在不同的环境有不同的配置。大原则就是我们不能直接使用产品的环境测试,因此我们就需要为不同的环境配置不同的数据库:
- 开发环境。即开发者用于开发的环境,大部分的数据都是由我们自己注入的,在
开发的过程中我们也会添加一些数据。
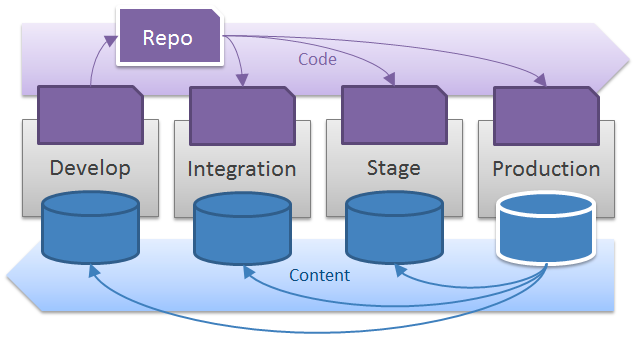
图 66: Drupal Deployment Flow
- 集成测试环境/测试环境。和开发环境一样,这些数据也是由我们注入的,而这些
数据主要是为于测试目的。当我们的应用出现 Bug 的时候,我们可能就需要添加新的测试及其测试数据。
- 模拟环境(Stageing)。在软件最终发布前,开发或者设计人员对软件进行调整后
可以及时预览改变的测试环境,这个环境更接近于产品最终发布后的运行环境。
因此,这个环境的数据一般来说就是产品环境的一些旧数据——可能是几个月前,几年前的数据。
- 产品环境。即线上环境,都是真实的用户数据。
因此从理论上来说,我们就需要 4~5 个不同的数据库配置。而这些不同的数据库配置并不代表着他们使用的是相同的数据库。我们可以在本地环境使用SQLite,而在我们
的产品环境使用 MySQL。不过,最好的情况是我们应该使用同一个配置。这样当出现问题的时候,我们也很容易排查、
而除了数据库配置之外,我们还有一些其他配置。因此针对于不同的环境的配置最好独立地写在不同的文件里。并且这些配置最好可以以文件名来区分,如针对于开发环
境,就是 dev.config.js,针对于测试环境就是 test.config.js。
因此,为了实现不同的环境使用不同的配置,我们就需要有一个变更控制。如果我们只有相应的配置,而没有对应的运行机制那就有问题了。
全站分卷索引 · 119 卷
- 1Growth: 全栈增长工程师指南
- 2软件开发的核心难题:沟通
- 3大公司的专家与小公司的全栈
- 4全栈工程师的未来:无栈
- 5基础知识篇
- 6工具只是辅助
- 7语言也是一种工具
- 8提高效率的工具
- 9IDE
- 10终端或命令提示符
- 11包管理
- 12环境搭建
- 13Windows
- 14GNU/Linux
- 15学好一门语言的艺术
- 16输出是最好的输入
- 17如何应用一门新的技术
- 18Web 编程基础
- 19从 HTML 到页面显示
- 20HTML
- 21中文?
- 22其他 HTML 标记
- 23小结
- 24CSS
- 25简介
- 26样式与目标
- 27更有趣的 CSS
- 28JavaScript
- 29JavaScriptFul
- 30面向对象
- 31其他
- 32前端与后台
- 33后台语言选择
- 34PHP
- 35Model
- 36View
- 37Controller
- 38后台即服务
- 39后台即服务
- 40数据库
- 41搜索引擎
- 42前端框架选择
- 43前台与后台交互
- 44JSON
- 45WebSocket
- 46编码过程
- 47Web 应用的构建系统
- 48Web 应用的构建过程
- 49Web 应用的构建实战
- 50Git 与版本控制
- 51Tasking
- 52Tasking 开发任务
- 53写代码只是在码字
- 54内置索引与外置引擎
- 55内置索引与外置引擎
- 56如何测试
- 57测试替身
- 58Mock
- 59测试先行
- 60可读的代码
- 61命名
- 62函数长度
- 63代码重构
- 64提炼函数
- 65内联函数
- 66查询取代临时变量
- 67重构到设计模式
- 68上线
- 69隔离硬件:虚拟机
- 70隔离操作系统:容器虚拟化
- 71隔离底层:Servlet 容器
- 72隔离依赖版本:虚拟环境
- 73隔离语言:DSL
- 74GNU/Linux
- 75HTTP 服务器
- 76数据库端缓存
- 77前端缓存
- 78运行机制
- 79自动化部署
- 80依赖与包仓库
- 81构建软件包
- 82数据分析
- 83想法-构建
- 84产品-衡量
- 85数据分析
- 86分析数据
- 87用户数据分析:Google Analytics
- 88流量获取
- 89移动应用
- 90网站性能
- 91SEO
- 92什么样的网站需要 SEO?
- 93内容
- 94UX 入门
- 95什么是简单?
- 96进阶
- 97认知设计
- 98持续交付
- 99持续集成系统
- 100持续交付
- 101持续部署
- 102持续阅读
- 103遗留系统与修改代码
- 104遗留代码
- 105修改遗留代码
- 106速度优化
- 107模块重构
- 108Retro
- 109三个维度
- 110架构模式
- 111预设计式架构
- 112演进式架构:拥抱变化
- 113意图导向
- 114重构
- 115模式与演进
- 116相关阅读资料
- 117架构解耦
- 118CQRS
- 119CQRS 结合微服务