SEO
- 后台优化,如数据库端缓存
- 启用页面缓存,即应用层缓存
减少下载量简单地来说,就是减少对服务器的请求:
- 使用 CDN
- 使用外部 JavaScript 和 CSS
- 缓存:使用 gzip 压缩、添加 Expires 头、配置 ETag、使 AjaX 可缓存
网络连接上的优化主要就是对域名到服务器进行优化,因此从方法上有:
- DNS 域名解析加速
- 减少 DNS 查找
SEO
这是一个老的,有些过时纸,但非常平易近人,甚至在我们中间的非白皮书的读者图标微笑什么每个程序员都应该知道的关于搜索引擎优化和他们绝对
概念的解释更详细,我只提一笔带过。
搜索时发生什么了?
- 用户输入查询内容
- 查询处理以及分词技术
- 确定搜索意图及返回相关、新鲜的内容
为什么需要 SEO?
这是一个有趣的问题,答案总会来源于为网站带来更多的流量。
爬虫与索引
我们先看看来自谷歌的爬虫工作的一点内容
抓取是 Googlebot 发现新网页并更新这些网页以将网页添加到 Google 索引中的过程。
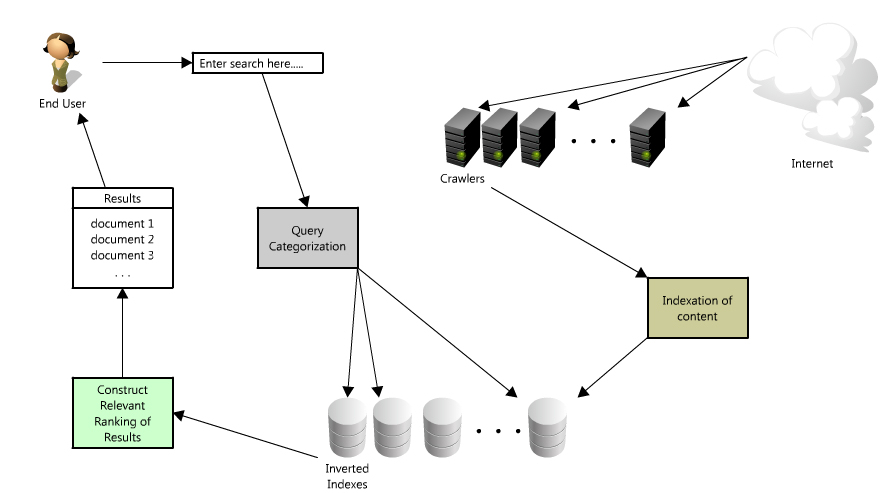
图 77: search-engine-arch
我们使用许多计算机来获取(或 “抓取”)网站上的大量网页。执行获取任务的程序叫做 Googlebot(也被称为漫游器或信息采集软件)。Googlebot 使用
算法来进行抓取:计算机程序会确定要抓取的网站、抓取频率以及从每个网站中获取的网页数量。
Google 的抓取过程是根据网页网址的列表进行的,该列表是在之前进行的抓取过程中形成的,且随着网站管理员所提供的站点地图数据不断进行扩
充。Googlebot 在访问每个网站时,会检测每个网页上的链接,并将这些链接添加到它要抓取的网页列表中。新建立的网站、对现有网站所进行的更改
以及无效链接都会被记录下来,并用于更新 Google 索引。
也就是如原文所说:
谷歌的爬虫 (又或者说蛛蛛) 能够抓取你整个网站索引的所有页。
为什么谷歌上可以搜索整个互联网的内容?因为,他解析并存储了。而更有意思的是,他会为同样的内容建立一个索引或者说分类,按照一定的相关性,针对于某个关键
词的内容。
PageRank 对于一个网站来说是相当重要的,只是这个相比也比较复杂。包括其他网站链接向你的网站,以及流量,当然还有域名等等。
全站分卷索引 · 119 卷
- 1Growth: 全栈增长工程师指南
- 2软件开发的核心难题:沟通
- 3大公司的专家与小公司的全栈
- 4全栈工程师的未来:无栈
- 5基础知识篇
- 6工具只是辅助
- 7语言也是一种工具
- 8提高效率的工具
- 9IDE
- 10终端或命令提示符
- 11包管理
- 12环境搭建
- 13Windows
- 14GNU/Linux
- 15学好一门语言的艺术
- 16输出是最好的输入
- 17如何应用一门新的技术
- 18Web 编程基础
- 19从 HTML 到页面显示
- 20HTML
- 21中文?
- 22其他 HTML 标记
- 23小结
- 24CSS
- 25简介
- 26样式与目标
- 27更有趣的 CSS
- 28JavaScript
- 29JavaScriptFul
- 30面向对象
- 31其他
- 32前端与后台
- 33后台语言选择
- 34PHP
- 35Model
- 36View
- 37Controller
- 38后台即服务
- 39后台即服务
- 40数据库
- 41搜索引擎
- 42前端框架选择
- 43前台与后台交互
- 44JSON
- 45WebSocket
- 46编码过程
- 47Web 应用的构建系统
- 48Web 应用的构建过程
- 49Web 应用的构建实战
- 50Git 与版本控制
- 51Tasking
- 52Tasking 开发任务
- 53写代码只是在码字
- 54内置索引与外置引擎
- 55内置索引与外置引擎
- 56如何测试
- 57测试替身
- 58Mock
- 59测试先行
- 60可读的代码
- 61命名
- 62函数长度
- 63代码重构
- 64提炼函数
- 65内联函数
- 66查询取代临时变量
- 67重构到设计模式
- 68上线
- 69隔离硬件:虚拟机
- 70隔离操作系统:容器虚拟化
- 71隔离底层:Servlet 容器
- 72隔离依赖版本:虚拟环境
- 73隔离语言:DSL
- 74GNU/Linux
- 75HTTP 服务器
- 76数据库端缓存
- 77前端缓存
- 78运行机制
- 79自动化部署
- 80依赖与包仓库
- 81构建软件包
- 82数据分析
- 83想法-构建
- 84产品-衡量
- 85数据分析
- 86分析数据
- 87用户数据分析:Google Analytics
- 88流量获取
- 89移动应用
- 90网站性能
- 91SEO
- 92什么样的网站需要 SEO?
- 93内容
- 94UX 入门
- 95什么是简单?
- 96进阶
- 97认知设计
- 98持续交付
- 99持续集成系统
- 100持续交付
- 101持续部署
- 102持续阅读
- 103遗留系统与修改代码
- 104遗留代码
- 105修改遗留代码
- 106速度优化
- 107模块重构
- 108Retro
- 109三个维度
- 110架构模式
- 111预设计式架构
- 112演进式架构:拥抱变化
- 113意图导向
- 114重构
- 115模式与演进
- 116相关阅读资料
- 117架构解耦
- 118CQRS
- 119CQRS 结合微服务