大公司的专家与小公司的全栈
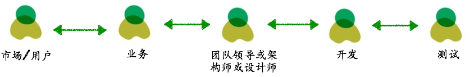
图 9: 敏捷软件开发的沟通模型
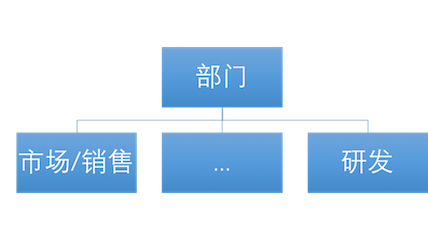
图 10: 组织结构
如果市场部门/产品经理没有与研发团队坐一起来分析问题,那么问题就多了。当一个需求在实现的过程中遇到问题,到底是哪个部门的问题?
同样的如果我们的研发部门是这样子的结构:
那么在研发、上线的过程中仍然会遇到各种的沟通问题。
现在,让我们回过头来看看大公司的专家与小公司的全栈。
大公司的专家与小公司的全栈
如果你经常看一些关于全栈和专家的技术文章的时候,你就会发现不同的人在强调不同的方向。大公司的文章喜欢强调成为某个领域的专家,小公司喜欢小而美的团
队——全栈工程师。
如我们所见的:大公司和小公司都在解决不同类型的问题。大公司要解决性能问题,小公司都活下去需要依赖于近乎全能的人。并且,大公司和小公司都在加班。如果从这
种意义上来说,我们可以发现其实大公司是在剥削劳动力。
专家
我们所见到的那些关于技术人员应该成为专家的文章,多数是已经成为某个技术领域里的专家写的文章。并且我们可以发现很有意思的一点是:他们都是管理者。管理者
出于招聘的动机,因此更需要细分领域的专家来帮助他们解决问题。
全栈
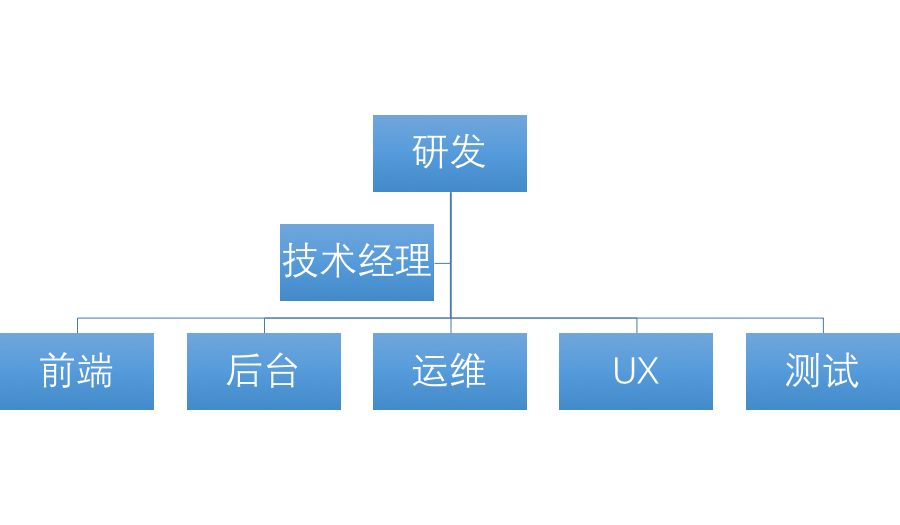
图 11: 研发部门
相似的,我们所看到的那些关于成为全栈工程师的文章,多数是初创公司的CTO写的。而这些初创公司的 CTO 也多数是全栈工程师,他们需要招聘全栈工程师来帮助他
们解决问题。
两种不同的学习模型而不知你是否也注意到一点:专家们也在强调“一专多长”。因为单纯依靠于一个领域的技术而存在的专家已经很少了,技术专家们不得不依据于公司的
需求去开拓不同的领域。毕竟 “公司是指全部资本由股东出资构成,以营利为目的而依法设立的一种企业组织形式;”,管理人们假设技术本身是相通的,既然你在技术领域
里有相当高的长板,那么进入一个新的技术也不是一件难的事。
作为一个技术人员,我们是这个领域中的某个子领域专家。而作为这样一个专家,我们要扩展向另外一个领域的学习也不是一件很难的事。借鉴于我们先前的学习经验,
我们可以很快的掌握这个新子域的知识。如我们所见,我们可以很快地补齐图中的短板:
在近来的探索中发现有一点非常有意思:如果依赖于20/80法则的话,那么成为专家和全栈的学习时间是相当的。在最开始的时候,我们要在我们的全栈工程和专家都在
某个技术领域达到 80 分的水平。
那么专家,还需要80%的时间去深入这个技术领域。而全栈工程师,则可以依赖于这 80% 的时候去开拓四个新的领域:
尽管理论上是如此,但是专家存在跨领域的学习障碍——套用现有模式。而全栈也存在学习障碍——如何成为专家,但是懂得如何学习新的领域。
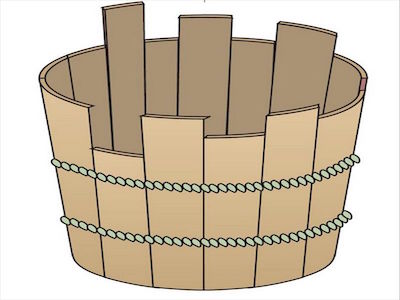
图 12: 木桶
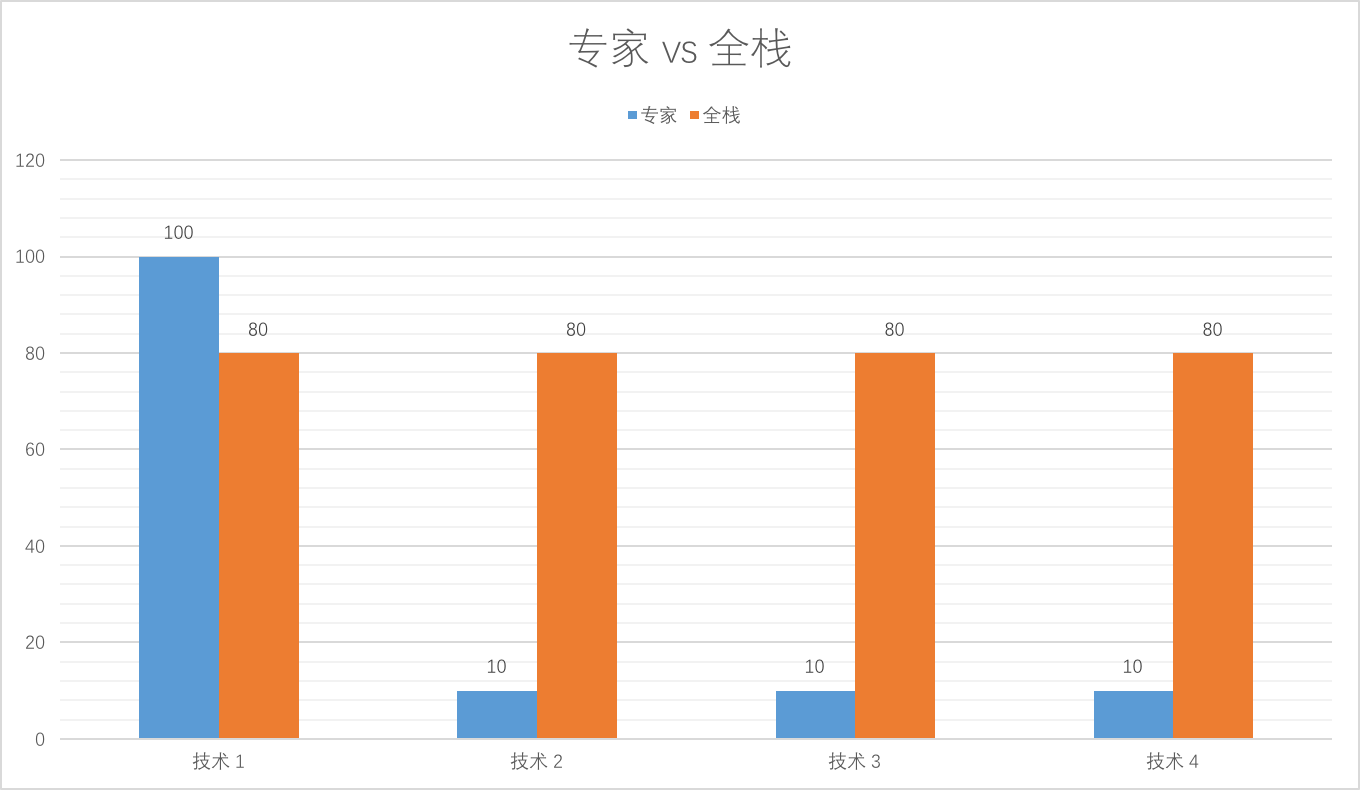
图 13: 全栈与专家学习时间
全站分卷索引 · 119 卷
- 1Growth: 全栈增长工程师指南
- 2软件开发的核心难题:沟通
- 3大公司的专家与小公司的全栈
- 4全栈工程师的未来:无栈
- 5基础知识篇
- 6工具只是辅助
- 7语言也是一种工具
- 8提高效率的工具
- 9IDE
- 10终端或命令提示符
- 11包管理
- 12环境搭建
- 13Windows
- 14GNU/Linux
- 15学好一门语言的艺术
- 16输出是最好的输入
- 17如何应用一门新的技术
- 18Web 编程基础
- 19从 HTML 到页面显示
- 20HTML
- 21中文?
- 22其他 HTML 标记
- 23小结
- 24CSS
- 25简介
- 26样式与目标
- 27更有趣的 CSS
- 28JavaScript
- 29JavaScriptFul
- 30面向对象
- 31其他
- 32前端与后台
- 33后台语言选择
- 34PHP
- 35Model
- 36View
- 37Controller
- 38后台即服务
- 39后台即服务
- 40数据库
- 41搜索引擎
- 42前端框架选择
- 43前台与后台交互
- 44JSON
- 45WebSocket
- 46编码过程
- 47Web 应用的构建系统
- 48Web 应用的构建过程
- 49Web 应用的构建实战
- 50Git 与版本控制
- 51Tasking
- 52Tasking 开发任务
- 53写代码只是在码字
- 54内置索引与外置引擎
- 55内置索引与外置引擎
- 56如何测试
- 57测试替身
- 58Mock
- 59测试先行
- 60可读的代码
- 61命名
- 62函数长度
- 63代码重构
- 64提炼函数
- 65内联函数
- 66查询取代临时变量
- 67重构到设计模式
- 68上线
- 69隔离硬件:虚拟机
- 70隔离操作系统:容器虚拟化
- 71隔离底层:Servlet 容器
- 72隔离依赖版本:虚拟环境
- 73隔离语言:DSL
- 74GNU/Linux
- 75HTTP 服务器
- 76数据库端缓存
- 77前端缓存
- 78运行机制
- 79自动化部署
- 80依赖与包仓库
- 81构建软件包
- 82数据分析
- 83想法-构建
- 84产品-衡量
- 85数据分析
- 86分析数据
- 87用户数据分析:Google Analytics
- 88流量获取
- 89移动应用
- 90网站性能
- 91SEO
- 92什么样的网站需要 SEO?
- 93内容
- 94UX 入门
- 95什么是简单?
- 96进阶
- 97认知设计
- 98持续交付
- 99持续集成系统
- 100持续交付
- 101持续部署
- 102持续阅读
- 103遗留系统与修改代码
- 104遗留代码
- 105修改遗留代码
- 106速度优化
- 107模块重构
- 108Retro
- 109三个维度
- 110架构模式
- 111预设计式架构
- 112演进式架构:拥抱变化
- 113意图导向
- 114重构
- 115模式与演进
- 116相关阅读资料
- 117架构解耦
- 118CQRS
- 119CQRS 结合微服务