输入URL回车后发生了什么
通过C页面实现A和B通信
window.name(共享变量) + iframe
使用Apache做转发
逆向代理,让跨域变成同域。
输入URL回车后发生了什么
简易版
- URL解析
- 查找缓存
- 域名解析:浏览器缓存>系统缓存>本地hosts>根域名>顶级域名>二级域名>三级域名
- TCP三次握手
- 发送HTTP请求
- 服务器处理请求并返回报文
- 浏览器解析渲染页面
- TCP四次ഀ手关闭TCP连接
从宏观是上理解从输入URL到页面渲染的过程,主要分为导航阶段和渲染阶段.
A 导航阶段
一、浏览器主进程
- 用户输入URL
1、浏览器进程检查url,组装协议,构成完整的url,这时候有两种情况:
输入的是搜索内容:地址栏会使用浏览器默认的搜索引擎,来合成新的带搜索关键字的URL。
输入的是请求URL:地址栏会根据规则,给这段内容加上协议,合成为完整的URL;
2、浏览器进程通过进程间通信(IPC)把url请求发送给网络进程;
URL一般包括几大部分:
protocol,协议头,譬如有http,ftp等 host,主机域名或IP地址
port,端口号 path,目录路径
query,即查询参数 fragment,即 #后的hash值,一般用来定位到某个位置
二、网络进程
命中,直接从缓存获取资源,并不会发送请求。如果没有命中,则进入下一步。
没有命中强缓存规则,浏览器会发送请求,根据请求头的If-Modified-Since(last_modified)和If-None- Match(ETag)判断是否命中协商缓存,如果命中,直接从缓存获取资源。如果没有命中,则进入下一步。
如果前两步都没有命中,则直接从服务端获取资源。
4、准备IP地址和端口:进行DNS解析时先查找缓存,没有再使用DNS服务器解析,查找顺序为:
浏览器缓存;
本机缓存;
hosts文件;
路由器缓存;
ISP DNS缓存;
DNS递归查询(本地DNS服务器 -> 权限DNS服务器 -> 顶级DNS服务器 -> 13台根DNS服务器)
5、等待TCP队列:浏览器会为每个域名最多维护6个TCP连接,如果发起一个HTTP请求时,这 6个 TCP连接都处于忙碌状态,那么这个请求就会处于排队状态,解决方案:
采用域名分片技术:将一个站点的资源放在多个(CDN)域名下面。
升级为HTTP2,就没有6个TCP连接的限制了;
6、通过三次握手建立TCP连接:
第一次:客户端先向服务器端发送一个同步数据包,报文的TCP首部中:标志位:同步SYN为1,表示这是一个请求建立连接的数据包;序号Seq=x,x为所传送数据的第一个字节的序号,随后进入SYN-SENT状态;
标志位值为1表示该标志位有效。
第二次:服务器根据收到数据包的SYN标志位判断为建立连接的请求,随后返回一个确认数据包,其中标志位 SYN=1,ACK=1,序号seq=y,确认号ack=x + 1表示收到了客户端传输过来的x字节数据,并希望下次从x+1
个字节开始传,并进入SYN-RCVD状态;
这里要区分标志位ACK和确认号ack;
第三次:客户端收到后,再给服务器发送一个确认数据包,标志位ACK=1,序号seq=x+1,确认号 ack=y+1,随后进入ESTABLISHED状态;
服务器端收到后,也进入ESTABLISHED状态,由此成功建立了TCP连接,可以开始数据传送;
为什么要第三次挥手?避免服务器等待造成资源浪费,具体原因:
如果没有最后一个数据包确认(第三次握手),A先发出一个建立连接的请求数据包,由于网络原因绕远路了。A经过设定的超时时间后还未收到B的确认数据包。
于是发出第二个建立连接的请求数据包,这次网路通畅,B的确认数据包也很快就到达A。于是A与B开始传输数据;
过了一会A第一次发出的建立连接的请求数据包到达了B,B以为是再次建立连接,所以又发出一个确认数据包。由于A已经收到了一个确认数据包,所以会忽略B发来的第二个确认数据包,但是B发出确认数据包之后
就要一直等待A的回复,而A永远也不会回复。
由此造成服务器资源浪费,这种情况多了B计算机可能就停止响应了。
7、构建并发送HTTP请求信息;
当服务器接收到浏览器的请求之后,就会进行逻辑操作,处理完之后返回一个HTTP响应消息,包括,响应行,响应头和响应体。
服务器响应之后,现在HTTP默认开启长连接,页面关闭后,TCP连接会经过四次挥手断开
8、服务器端处理请求;
9、客户端处理响应,首先检查服务器响应报文的状态码:
如果是301/302表示服务器已更换域名需要重定向,这时网络进程会从响应头的Location字段里面读取重定向的地址,然后再发起新的HTTP或者HTTPS请求,跳回第4步。
如果是200,就检查Content-Type字段,值为text/html说明是HTML文档,是application/octet-stream说明是文件下载;
10、请求结束,当通用首部字段Conection不是Keep-Alive时,即不为TCP长连接时,通过四次ഀ手断开TCP连接:
四次挥手步骤(抽象派)
主动方:我已经关闭了向你那边的主动通道了,只能被动接收了被动方:收到通道关闭的信息
被动方:那我也告诉你,我这边向你的主动通道也关闭了主动方:最后收到数据,之后双方无法通信
第一次:客户端(主动断开连接)发送数据包给服务器,其中标志位FIN=1,序号位seq=u,并停止发送数据;
第二次:服务器收到数据包后,由于还需传输数据,无法立即关闭连接,先返回一个标志位ACK=1,序号 seq=v,确认号ack=u+1的数据包;
第三次:服务器准备好断开连接后,返回一个数据包,其中标志位FIN=1,标志位ACK=1,序号seq=w,确认号ack=u+1;
第四次:客户端收到数据包后,返回一个标志位ACK=1,序号seq=u+1,确认号ack=w+1的数据包。
由此通过四次ഀ手断开TCP连接。
为什么要四次挥手?
由于服务器不能马上断开连接,导致FIN释放连接报文与ACK确认接收报文需要分两次传输,即第二次和第三次"ഀ 手";
- 准备渲染进程
11、准备渲染进程:浏览器进程检查当前url是否与之前打开了渲染进程的页面的根域名相同,如果相同,则复用原来的进程,如果不同,则开启新的渲染进程;
- 提交文档
12、提交文档:
渲染进程准备好后,浏览器向渲染进程发起“提交文档”的消息,渲染进程接收到消息后与网络进程建立传输数据的“管道”
B 渲染阶段
渲染步骤大致可以分为以下几步:
- 解析HTML,构建DOM树
- 解析CSS,生成CSS规则树
- 合并DOM树和CSS规则,生成render树
- 布局render树(Layout/reflow),负责各元素尺寸、位置的计算
- 绘制render树(paint),绘制页面像素信息
- 浏览器会将各层的信息发送给GPU,GPU会将各层合成(composite),显示在屏幕上
在渲染阶段通过渲染流水线在渲染进程的主线程和合成线程配合下,完成页面的渲染;
三、渲染进程
- 构建DOM树
13、先将请求回来的数据解压,随后HTML解析器将其中的HTML字节流通过分词器拆分为一个个Token,然后生成节点Node,最后解析成浏览器识别的DOM树结构。[解析HTML,生成DOM树]
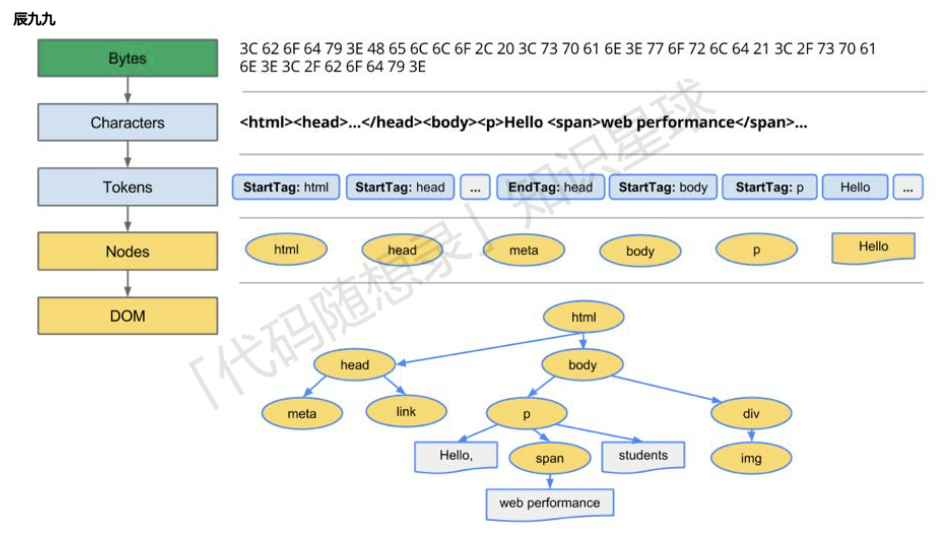
1.
- 重点过程
- Conversion转换:浏览器将获得的HTML内容(Bytes)基于他的编码转换为单个字符
- Tokenizing分词:浏览器按照HTML规范标准将这些字符转换为不同的标记token。每个token都有自己独特
的含义以及规则集
- Lexing词法分析:分词的结果是得到一堆的token,此时把他们转换为对象,这些对象分别定义他们的属性和
规则
- DOM构建:因为HTML标记定义的就是不同标签之间的关系,这个关系就像是一个树形结构一样。例如:
渲染引擎还有一个安全检查模块叫 XSSAuditor,是用来检测词法安全的。在分词器解析出来 Token 之后,它会检测这些模块是否安全,比如是否引用了外部脚本,是否符合 CSP 规范,是否存在跨站点请求等。如果
出现不符合规范的内容,XSSAuditor 会对该脚本或者下载任务进行拦截。
首次解析HTML时渲染进程会开启一个预解析线程,遇到HTML文档中内嵌的JavaScript和CSS外部引用就会同步提前下载这些文件,下载时间以最后下载完的文件为准。
- 构建CSSOM
14、CSS解析器将CSS转换为浏览器能识别的styleSheets也就是CSSOM:可以通过控制台输入 document.styleSheets查看;
这里要考虑一下阻塞的问题,由于JavaScript有修改CSS和HTML的能力,所以,需要先等到 CSS 文件下载完成并生成 CSSOM,然后再执行 JavaScript 脚本,最后再继续构建 DOM。由于这种阻塞,导致了解析白屏;[解析CSS, 生
成CSSOM]
优化方案:
- 移除js和css的文件下载:通过内联 JavaScript、内联 CSS;
- 尽量减少文件大小:如通过 webpack 等工具移除不必要的注释,并压缩 js 文件;
- 将不进行DOM操作或CSS样式修改的 JavaScript 标记上 async 或者 defer异步引入;
- 使用媒体查询属性:将大的CSS文件拆分成多个不同用途的 CSS 文件,只有在特定的场景下才会加载特定的
CSS 文件。
可以通过浏览器调试工具的Network面板中的DOMContentLoaded查看最后生成DOM树所需的时间;
- 样式计算
15、转换样式表中的属性值,使其标准化。比如将em转换为px,color转换为rgb;
16、计算DOM树中每个节点的具体样式,这里遵循CSS的继承和层叠规则;可以通过Chrome调试工具的 Elements选项的Computed查看某一标签的最终样式;
- 布局阶段
[结合DOM和CSSOM树,生成渲染树]
17、创建布局树,遍历DOM树中的所有节点,去掉所有隐藏的节点(比如head,添加了display:none的节点),只在布局树中保留可见的节点。
18、计算布局树中节点的坐标位置(较复杂,这里不展开),对于每个可见的节点,找到CSSOM树中对应规则并应用, 根据每个可见节点及其对应的样式,生成渲染树;
图层
一般来说,可以把普通文档流看成一个图层。特定的属性可以生成一个新的图层。不同的图层渲染互不影响,所以对于某些频繁需要渲染的建议单独生成一个新图层,提高性能。但也不能生成过多的图层,会引起反作用。
通过以下几个常用属性可以生成新图层
3D 变换:translate3d、translateZ will-change
video、iframe 标签通过动画实现的 opacity 动画转换
position: fixed
- 图层绘制
20、为每个图层生成绘制列表(即绘制指令),并将其提交到合成线程。以上操作都是在渲染进程中的主线程中进行的,提交到合成线程后就不阻塞主线程了;
- 切分图块
21、合成线程将图层切分成大小固定的图块(256x256或者512x512)然后优先绘制靠近视口的图块,这样就可以大大加速页面的显示速度;
四、GPU 进程
- 栅格化操作
22、在光栅化线程池中将图块转换成位图,通常这个过程都会使用GPU来加速生成,使用GPU生成位图的过程叫快速栅格化,或者GPU栅格化,生成的位图被保存在GPU内存中。
五、浏览器主进程
- 合成与显示
23、合成:一旦所有图块都被光栅化,合成线程就会将它们合成为一张图片,并生成一个绘制图块的命令—— “DrawQuad”,然后将该命令提交给浏览器进程。
注意了:合成的过程是在渲染进程的合成线程中完成的,不会影响到渲染进程的主线程执行;
24、显示:浏览器进程里面有一个叫viz的组件,用来接收合成线程发过来的DrawQuad命令,然后根据 DrawQuad命令,将其页面内容绘制到内存中,最后再将内存显示在屏幕上。将像素发送给GPU,展示在页面上
(GPU将多个合成层合并成一个层,展示)
到这里,经过这一系列的阶段,编写好的HTML、CSS、JavaScript等文件,经过浏览器就会显示出漂亮的页面了。
全站分卷索引 · 154 卷
- 1代码随想录知识星球精华(最强八股文)第五版(前端篇))
- 2html语义化
- 3src 和 href 的区别
- 4link 与 @import 的区别
- 5iframe
- 6CSS
- 7伪元素和伪类
- 8block,inline,inline-block
- 9重排、重绘和合成
- 10盒子模型
- 11margin 合并
- 12margin和padding 的值为百分比时
- 13浮动
- 14定位
- 15CSS选择器
- 16CSS选择器优先级
- 17选择器权重Specificity
- 18CSS属性继承
- 19不可/可继承属性
- 20display: none与 visibility: hidden的区别
- 21background-size
- 22client、offset&scroll
- 23CSS3新特性
- 24flex布局
- 25常见布局
- 26三栏布局
- 27垂直居中
- 28水平垂直居中
- 29CSS画三角形
- 30使chrome支持12px以下文字
- 31响应式布局
- 32媒体查询
- 33过渡与动画
- 34JavaScript 动画 和 CSS动画
- 35SCSS
- 36CSS性能优化
- 37有哪些数据类型
- 38判断数据类型
- 39类型转换
- 40parseInt&parseFloat
- 41浮点数求和步骤
- 42十进制小数转二进制
- 430.1+0.2 为什么不等于 0.3
- 44undefined 和 undeclared 的区别
- 45JavaScript NaN 属性
- 46isFinite()&isNaN()
- 47数组
- 48对原数组有影响
- 49对原数组无影响
- 50数组去重
- 51数组拍平
- 52ES6新增的数组方法
- 53判断是否存在某个值
- 54arguments为啥不是数组
- 55对象
- 56遍历对象的方法
- 57判断对象是否具有属性
- 58for in 和 for of 的区别
- 59继承方式
- 60instanceof
- 61深浅拷贝
- 62freeze属性
- 63函数
- 64函数柯里化
- 65函数的 length
- 66箭头函数和普通函数区别
- 67构造函数
- 68执行上下文
- 69作用域
- 70作用域和作用域链
- 71闭包和内存泄漏
- 72this
- 73关于 this 的指向问题
- 74改变this指向的方法(bind / call / apply)
- 75字符串
- 76DOM和事件
- 77哪些事件支持冒泡
- 78阻止冒泡
- 79HTMLCollection、NodeList
- 80dom.onclick 和 dom.addEventListener的区别
- 81e.target和e.currentTarget
- 82页面生命周期
- 83异步
- 84内存管理GC
- 85其它
- 86JavaScript 中日期时间格式转换
- 87input和object实现双向绑定
- 88JSON.stringify()
- 89escape、encodeURI&encodeURIComponent
- 90移动端滚动穿透和溢出
- 91ES6
- 92Map字典
- 93... 与rest
- 94proxy
- 95模块化
- 96Ajax、Fetch和Axios
- 97Webpack
- 98浏览器:事件循环
- 99浏览器内核
- 100浏览器同源策略
- 101输入URL回车后发生了什么
- 102HTTP
- 103HTTP 2.0
- 104浏览器存储
- 105鉴权
- 106Webstorage
- 107浏览器执行机制
- 108AST 抽象语法树
- 109性能优化
- 110CSS
- 111网络相关
- 112使用HTTP2.0
- 113图片
- 114CDN图片
- 115其他文件优化
- 116降低APP首页开屏渲染时间
- 117页面白屏
- 118HTTPS中间人攻击
- 119Web Worker
- 120Service Worker
- 121微前端
- 122Vue
- 123v-show 和 v-if 的区别
- 124双向数据绑定的原理
- 125Vue中的插槽使用
- 126Vue中的key
- 127Vue过滤器
- 128Vue中Scoped原理
- 129Vue中$nextTick的使用
- 130Vue中实现组件通信的方式
- 131Vue-router
- 132Vue路由传参
- 133前端路由
- 134Vuex
- 135虚拟DOM
- 136DIFF 算法
- 137Vue3和Vue2有哪些区别
- 138说一说你对React的理解
- 139React事件机制
- 140说一说你对react refs的理解
- 141react中key的作用
- 142组件开发
- 143有状态组件和无状态组件
- 144函数式组件和类组件的区别
- 145PureComponent&Component
- 146常见 Hooks
- 147状态管理
- 148redux toolkit
- 149React18新特性
- 150client中的createRoot取代以前的ReactDOM.render
- 151Suspense
- 152新的Hooks
- 153VDom一定更快吗
- 154Fiber