虚拟内存
分页是一维地址空间,分段是二维的。
大小是否可以改变:
页的大小不可变,段的大小可以动态改变。
出现的原因:
分页主要用于实现虚拟内存,从而获得更大的地址空间;分段主要是为了使程序和数据可以被划分为逻辑上独立的地址空间并且有助于共享和保护。
虚拟内存
简述
属于计算机系统内存管理的一种技术,虚拟地址空间构成虚拟内存,它使得应用程序认为自己拥有连续的可用内存空间,但实际上是被分隔的多个物理内存页、以及部分暂时存储在磁盘上的交换分区所构成的。虚拟内存的实现通
过硬件异常、硬件地址翻译、主存、磁盘以及内核软件共同完成
1、地址空间:
地址空间是物理内存的抽象,是一个进程可用于寻址内存的一套地址集合。
2、分页:
地址空间被分割成多个块,每一块称作一页或页面(Page)。每一页有连续的地址范围,这些页被映射到连续的物理内存(页框)。
3、页表:
页表的目的是把虚拟页面(虚拟地址)映射为页框(物理地址)。页表给出了虚拟地址与物理地址的映射关系。从数学的角度说页表是一个函数,他的参数是虚拟页号,结果是物理页页框号
4、加速分页:
(1)TLB加速分页
概念:将虚拟地址直接映射到物理地址,而不必再访问页表,这种设备被称为转换检测缓冲区(TLB)、相联存储器或快表
工作过程:将一个虚拟地址放入MMU中进行转换时,硬件首先通过将该虚拟页号与TLB中所有表项同时进行匹配,判断虚拟页面是否在其中:
- 虚拟页号在TLB中。如果MMU检测一个有效的匹配并且访问操作并不违反保护位,则将页框号直接从TLB中取
出而不必访问页表。
- 虚拟页号不在TLB中。如果MMU检测到没有有效的匹配项就会进行正常的页表查询。接着从TLB中淘汰一个表
项,然后用新的页表项替换它。
(2)软件TLB管理
5、针对大内存的页表
三个重要的能力:
- 高速缓存
按照存储器层次结构中的缓存划分来看,将位于k层的更小更快的存储设备作为存储在k+1层的更大更慢的存储设备的缓存。具体如下:
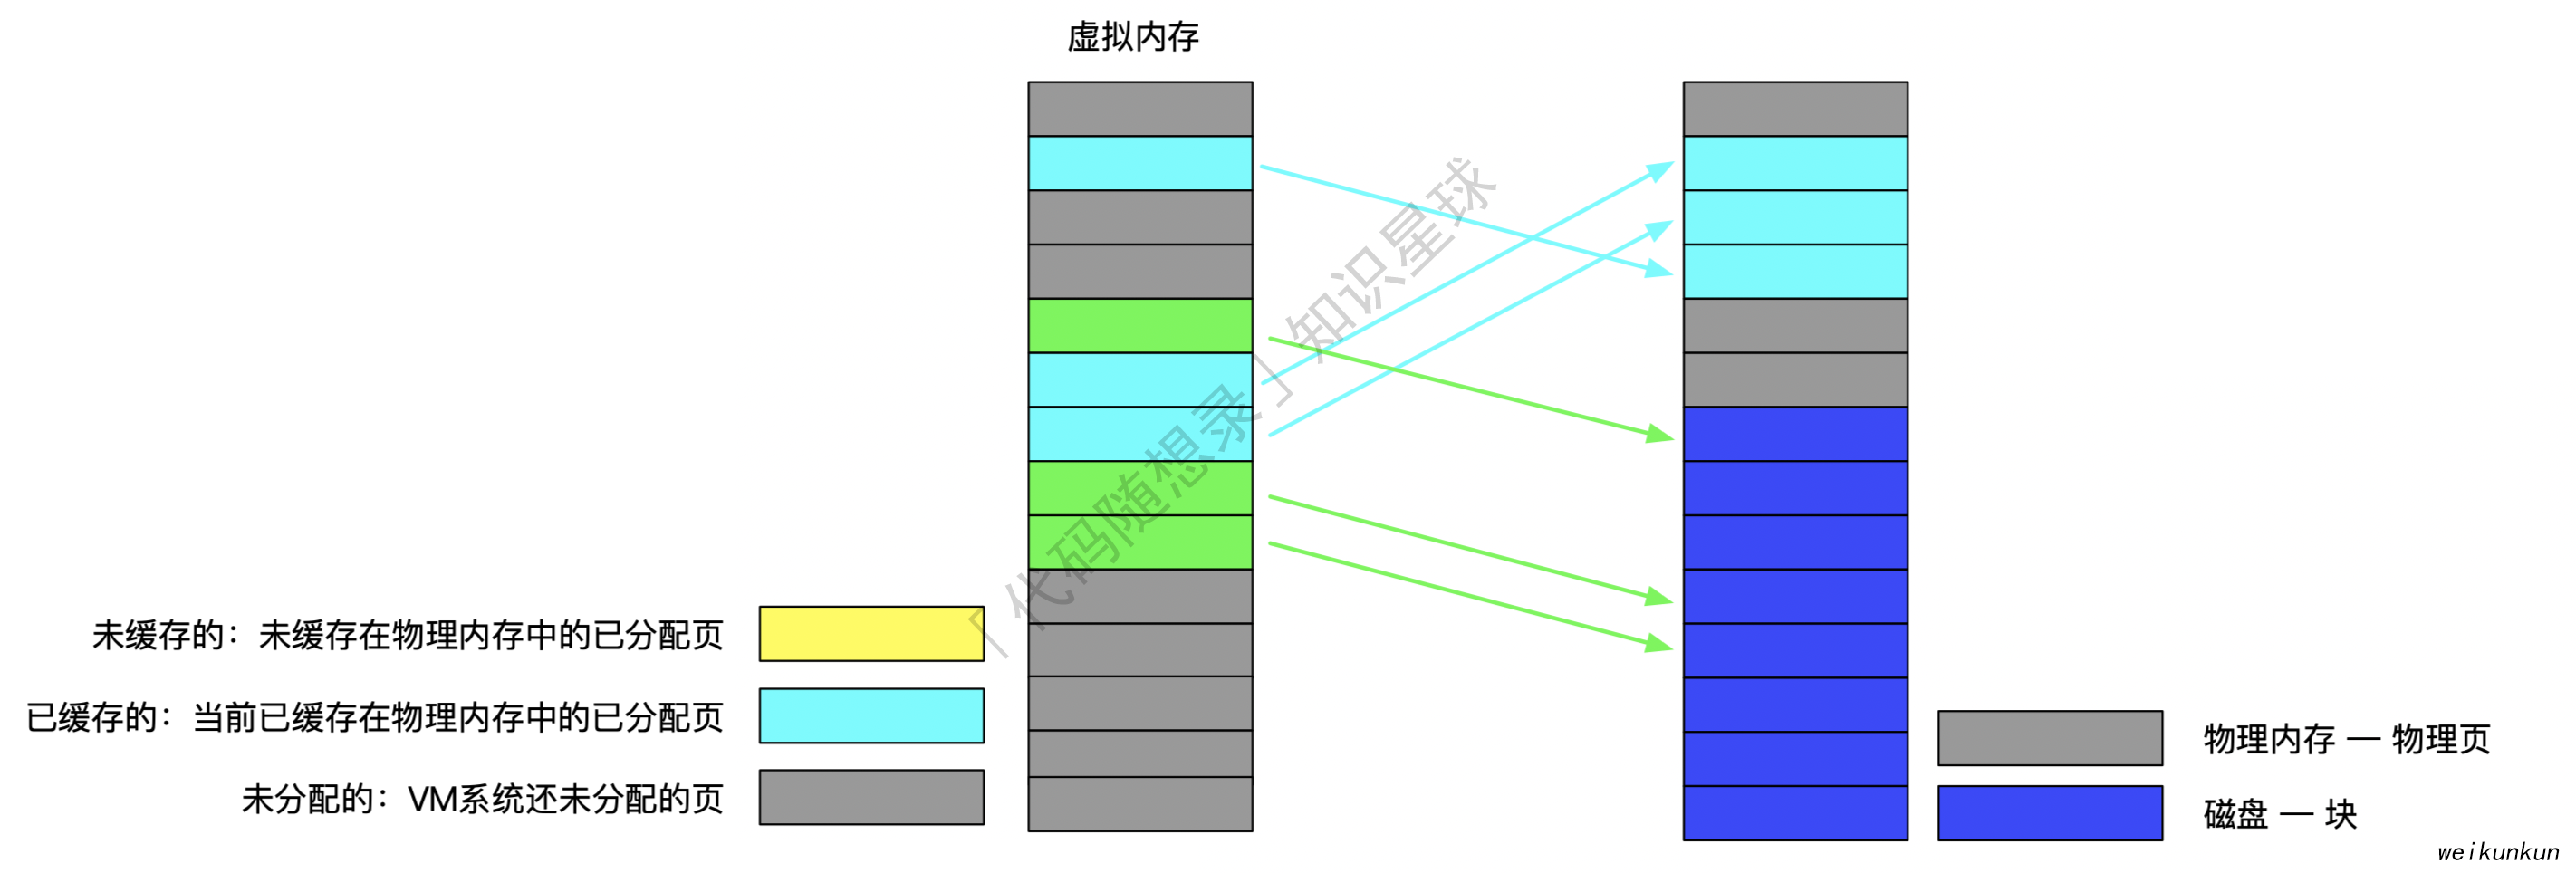
在虚拟内存中的虚拟页共分为三种类型:
- 未分配(没有被进程申请使用的,也就是空闲的虚拟内存,不占用虚拟内存磁盘的任何空间)
- 未缓存(仅仅加载到磁盘中的页)
- 已缓存(已经加载到内存中的内存页(页框))
- 内存管理
- 内存保护
现代操作系统中,用户进程不应该被允许修改它的只读代码段;
而且也不应该允许它读取或修改任何内核中的代码和数据结构;
并且也不允许其读取或者修改其他进程的私有内存,以及修改和其他进程共享的虚拟页面。
如果不对进程的内存访问进行限制,攻击者就能够访问和修改其他进程的私有内存,进而导致整个系统崩溃。大体的虚拟寻址如下:
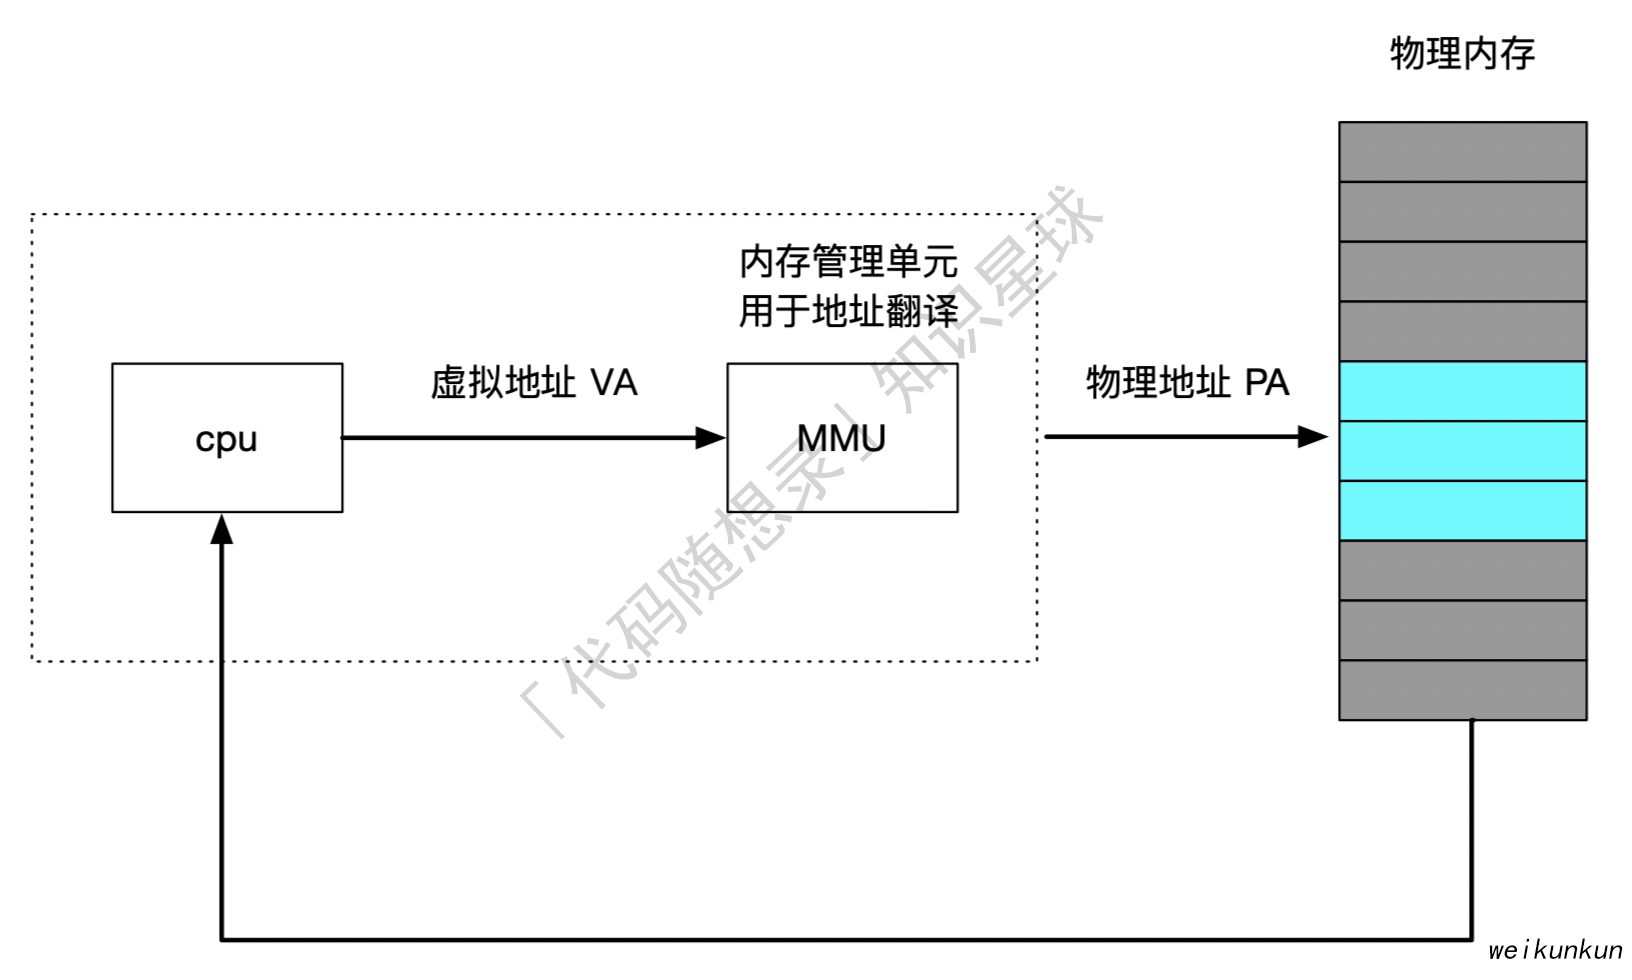
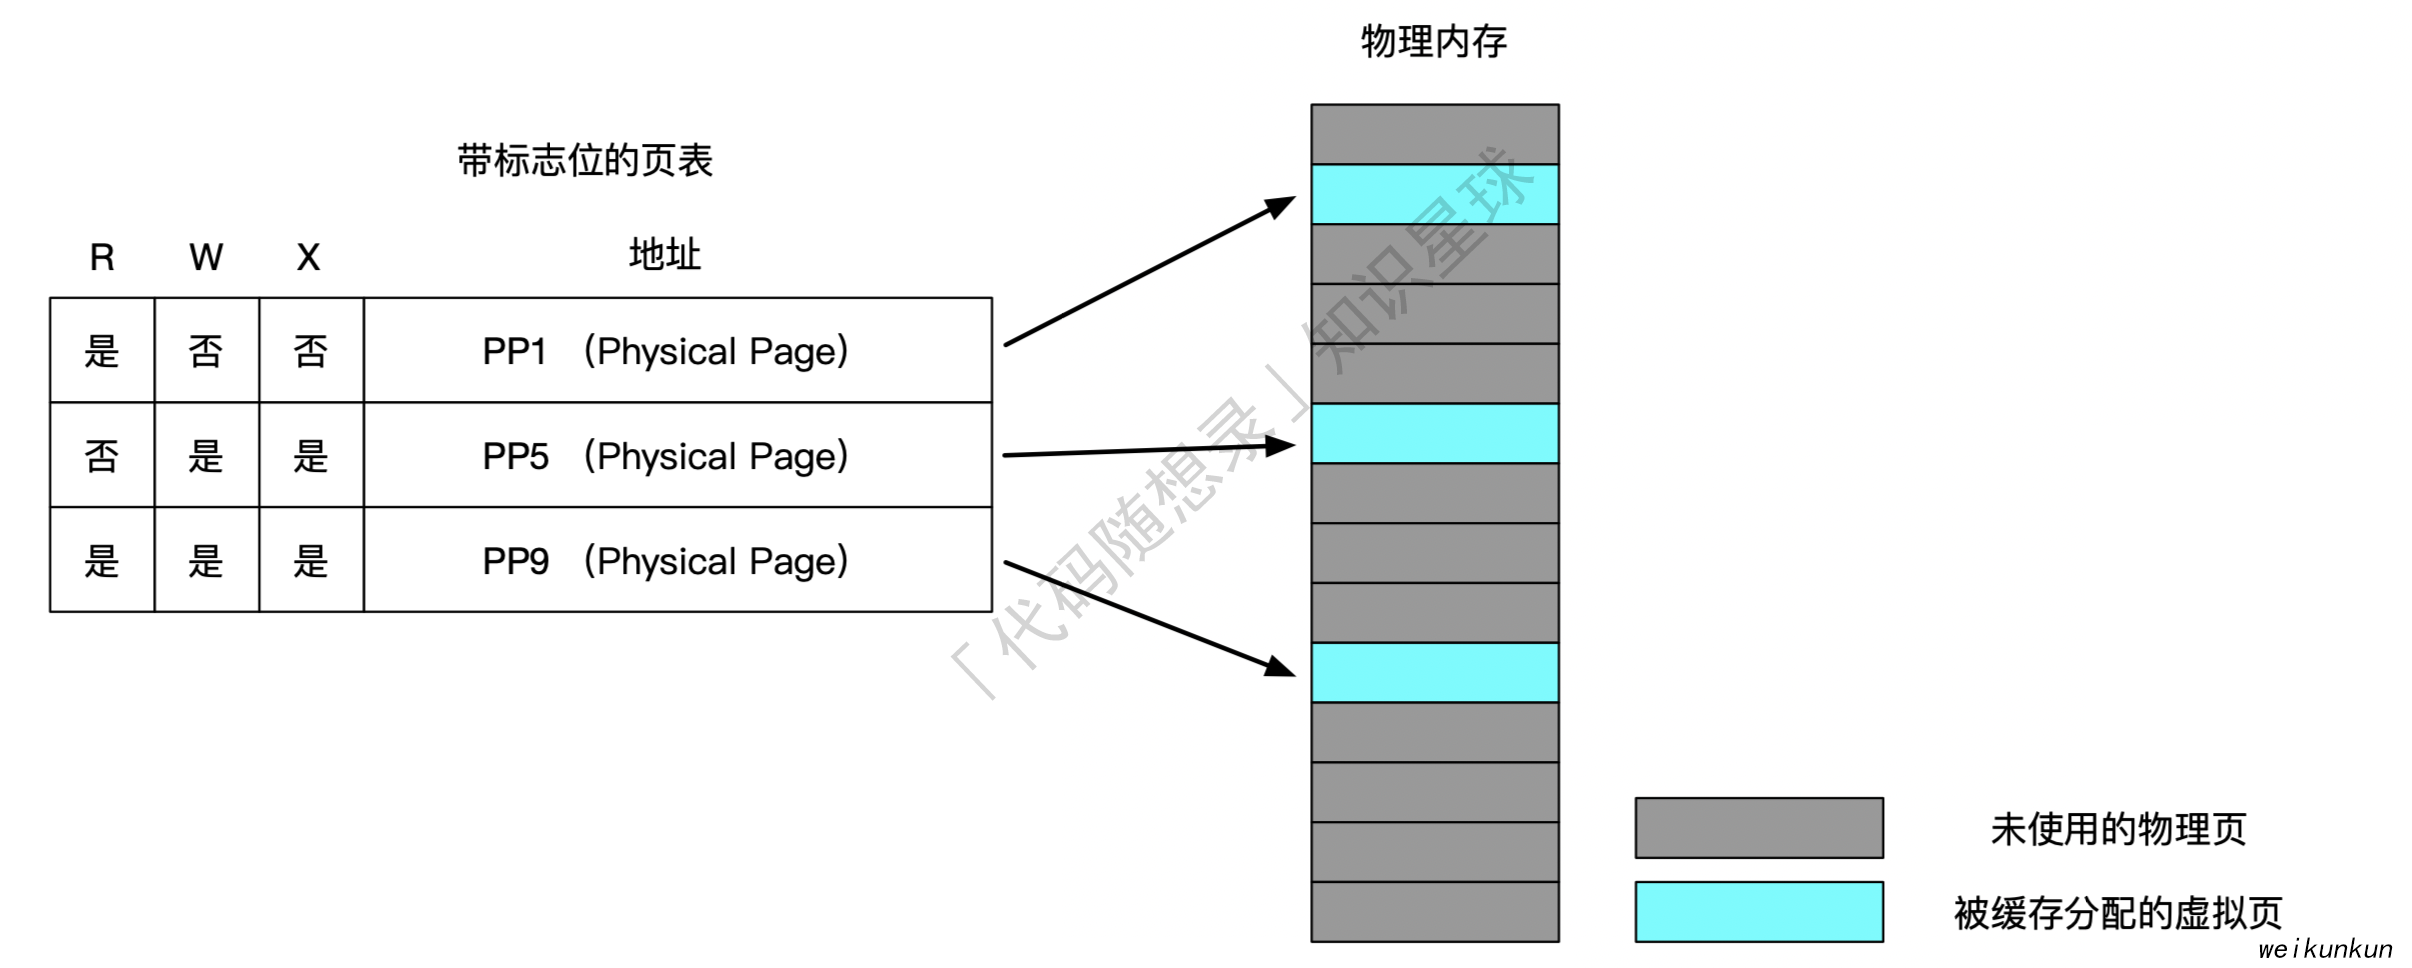
通过MMU,每次都会读取页表中的一个页表条目(PTE),通过在这些页表条目(PTE)中添加一些标志位,就能够实现对一个虚拟页的访问控制权限。譬如:
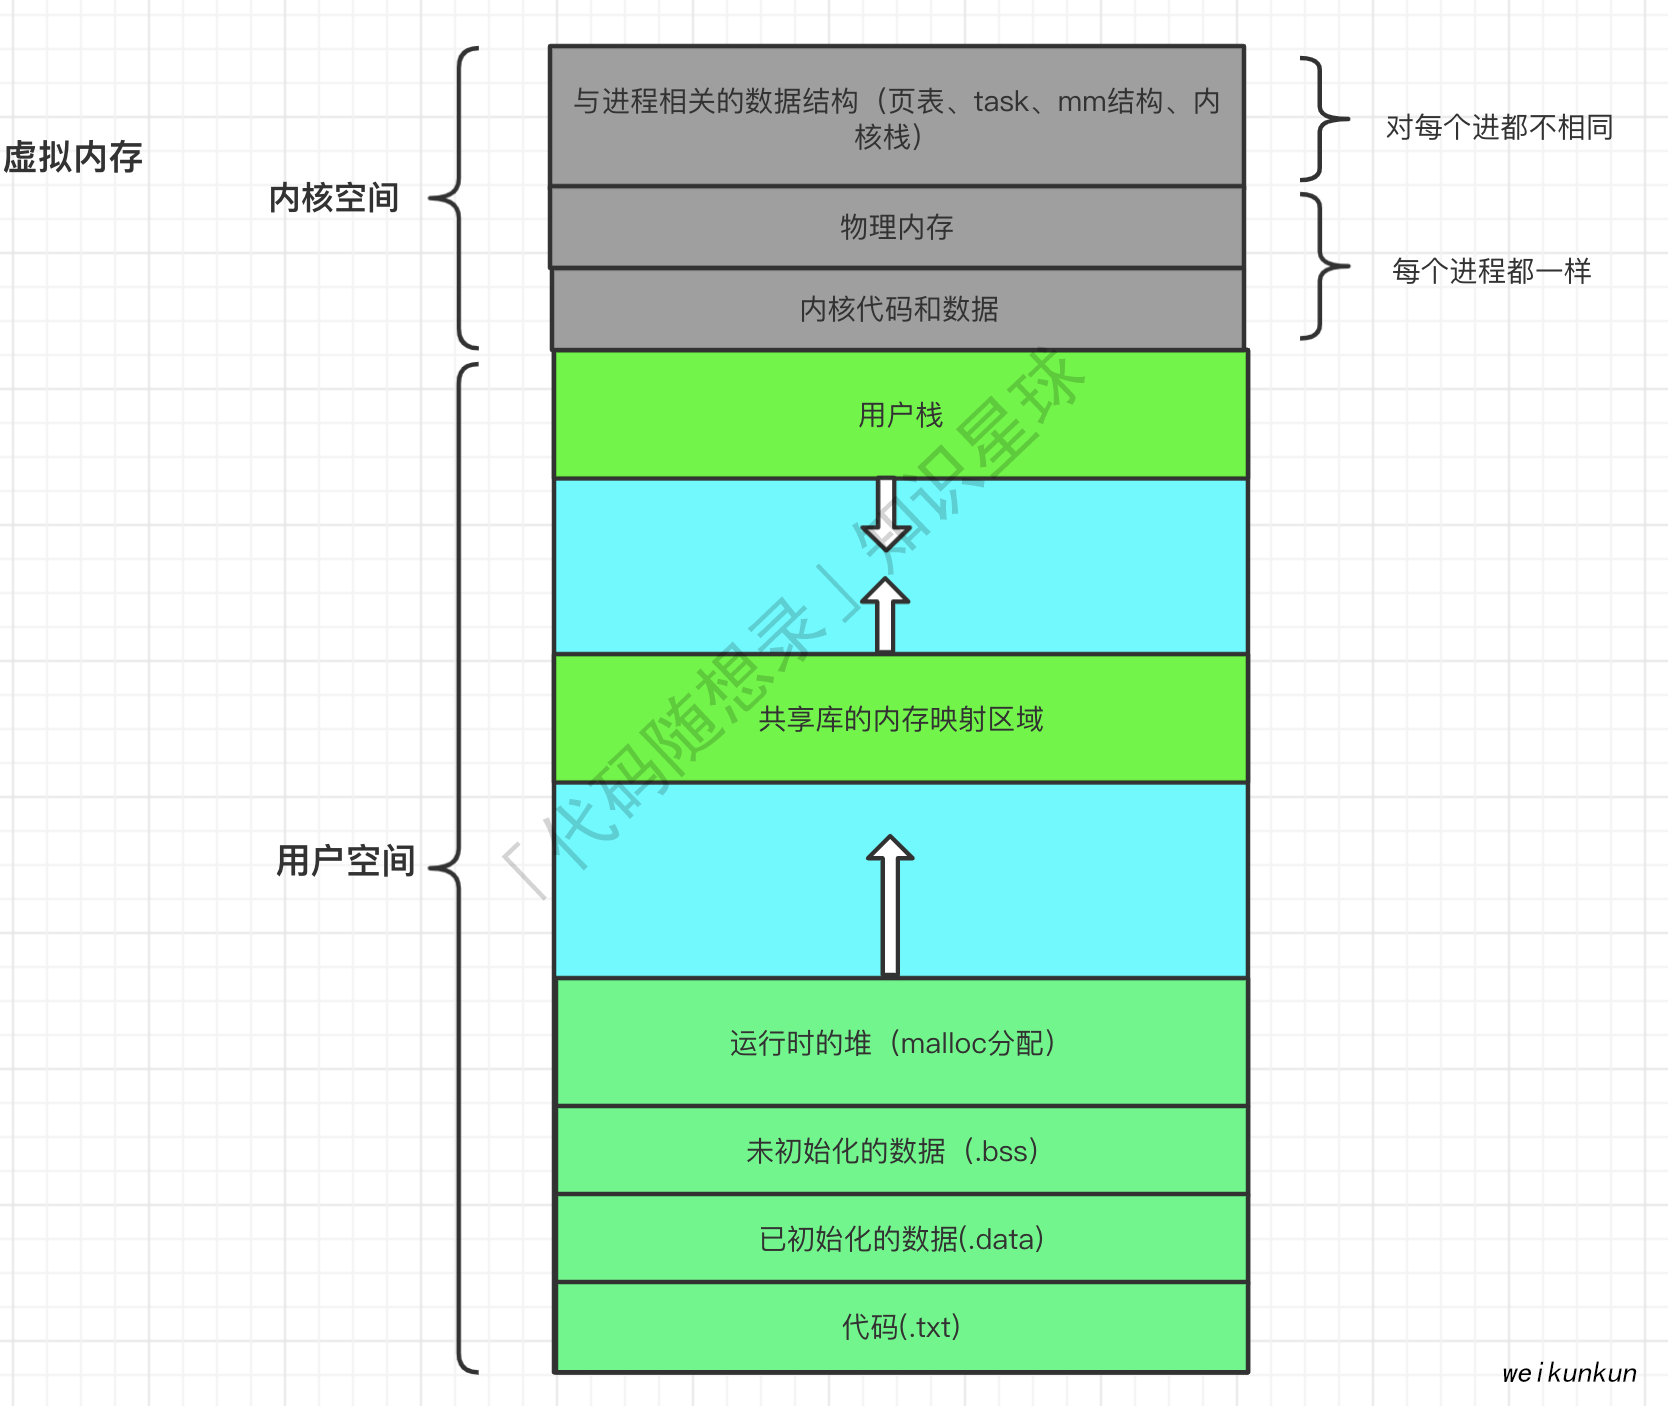
相关的其他概念
- 用户态和内核态
为了使操作系统内核提供一个无懈可击的进程抽象,处理器必须提供一种机制,限制一个应用可以执行的指令以及他可以用来访问的地址空间范围。
处理器通常是用某个控制寄存器中的一个模式位来提供这种观功能的,该寄存器描述了进程当前享有的特权。
当设置了模式位时:
进程就运行在内核态中。
运行在内核态中的进程可以执行指令集中的任何指令,并且可以访问系统中的任何内存位置。
没有设置模式位时:
进程就运行在用户态。用户模式中的进程不允许执行特权指令。
比如:停止处理器、改变模式位、或者发起一个I/O操作。同时也不允许用户态下的进程直接引用地址空间中内核空间的代码和数据。
任何这样的尝试都会导致致命的保护故障。用户态下的程序必须通过系统调用接口间接的访问内核代码和数据。
- 上下文切换'
上下文切换属于一种较高层形式的异常控制流,进行上下切换涉及到的内容如下:
(1)各种寄存器,TLB 也是其中之一。
(2)程序计数器
(3)用户栈
(4)内核栈
(5)内核中的各种数据结构
- 页表
全站分卷索引 · 230 卷
- 1代码随想录知识星球精华(最强八股文)第五版(计算机基础篇)
- 2DNS
- 3DNS解析过程
- 4递归查询和迭代查询
- 5HTTP特性与简述
- 6HTTP版本演变
- 7HTTP/2
- 8HTTP1.1协议的性能问题
- 9兼容HTTP1.1
- 10二进制帧
- 11并发传输
- 12服务器主动推送资源
- 13总结
- 14HTTP/3
- 15HTTP/2的缺点
- 16QUIC协议的特点
- 17HTTP/3协议
- 18HTTP缓存
- 19协商缓存
- 20HTTPS
- 21HTTPS的特点
- 22非对称加密
- 23摘要算法+数字签名
- 24数字证书
- 25证书信任链
- 26HTTPS是怎么建立连接的
- 27TCP与UDP头部格式
- 28TCP
- 29列举TCP选项
- 30TCP三次握手
- 31为什么需要三次握手?
- 32什么是半连接队列
- 33什么是SYN攻击
- 34为什么挥手需要四次
- 35TIME_WAIT 过多有什么危害?
- 36TCP的滑动窗口
- 374. 程序是如何表示发送方的四个部分的呢?
- 386. 接收窗口和发送窗口的大小是相等的吗?
- 391. 慢启动
- 403. 拥塞发生
- 414. 快速恢复
- 42IP基础
- 43IP地址
- 44在浏览器中输入URL并按下回车之后会发生什么
- 45TCP 抓包实践
- 46TCP连接与断开优化
- 47TCP内核参数
- 48主动方的优化
- 49被动方的优化
- 50Linux是如何收发网络包的
- 51收发流程
- 52面试题
- 53TCP/IP四层网络模型
- 54五层网络体系结构
- 55HTTP响应报文
- 56HTTP常见字段
- 57什么是TCP粘包问题?如何解决TCP粘包问题?
- 58UDP会不会产生粘包问题呢?
- 59请求报文
- 60时间消耗
- 61HTTP缓存有几种
- 62HTTP1.0和HTTP1.1的区别?
- 63HTPP1.1和HTTP1.0有什么区别
- 64HTTP/3
- 65HTTPS是如何建立连接的
- 66DNS是什么
- 67递归查询和迭代查询
- 68TCP与UDP的区别
- 69TCP和UDP分别在什么场景使用?
- 70三次握手的过程
- 71Keep-Alive的优缺点
- 72CDN的工作流程
- 73Session的工作原理
- 74TCP重传机制是怎么实现的?
- 75什么是SS0
- 76HTTP优化方案
- 77浏览器地址栏输入URL回车后涉及到的流程
- 781.5 浏览器发送HTTP/HTTPS请求到web服务器
- 79SYN攻击
- 80操作系统
- 81操作系统的功能
- 82进程和线程
- 83线程基础
- 84进程调度
- 85进程调度方式
- 86进程通信
- 87消息传递(消息队列)
- 88信号量
- 89信号
- 90线程通信
- 91多线程
- 92进程通信
- 93消息队列
- 94信号
- 95守护进程
- 96互斥与同步
- 974. 互斥锁解锁
- 983. 处理方法
- 99读写锁
- 1002. 销毁读写锁
- 1014. 写锁定
- 1021. 创建条件变量
- 1034. 阻塞线程
- 104信号量
- 1054. V操作
- 1062. 读者-写者问题
- 107存储系统
- 108虚拟内存
- 109内存分段
- 110内存分页
- 111虚拟内存
- 112文件系统
- 1135. 文件访问
- 114目录
- 1154. 目录操作
- 1163. 目录的实现
- 1177. 虚拟文件系统
- 1184. 文件系统性能
- 119磁盘编址
- 120三层抽象
- 121外设管理
- 122Linux
- 123select/poll/epoll的区别和联系
- 124Linux 内存管理
- 125Linux虚拟内存
- 126Linux 信号
- 127Linux设计
- 1283. 各种IO模型的比较
- 129Linux网络
- 130Linux中的软链接和硬链接有什么区别?
- 131什么是中断和异常
- 132信号和信号量有什么区别
- 133Linux中如何查看一个进程
- 134进程、线程的区别?
- 135进程之间的通信方式
- 136如何解除死锁
- 137分段和分页的区别
- 138IO多路复用
- 139MySQL表连接
- 140过滤条件
- 141执行一次update语句,发生了什么
- 142用户账号存储
- 143用户账号删除
- 144索引
- 145索引有哪些类别
- 1462. 按照存储分类
- 1475. 按照字段个数分类
- 148索引区分度
- 149索引什么时候会失效
- 150事务的四大特性ACID
- 151并行事务会出现什么问题
- 152幻读是如何解决的
- 153事务隔离的实现
- 154读已提交是怎么实现的
- 155锁
- 1561、全局锁
- 1573、行级锁
- 158锁的划分
- 1592.、程序员角度
- 160Innodb使用表锁还是行锁
- 161什么是binlog
- 162执行引擎
- 163MySQL常见问题
- 1642. 事务
- 1653. 脏页
- 1664. 表结构
- 1676. 查询效率
- 168MySQL分库分表
- 169垂直分表
- 170水平分库
- 171分库分表的问题
- 172数据库排序思路
- 173MySQL主从复制
- 1745. 主从复制模式
- 175面试题
- 176执行一条select语句,发生了什么?
- 177你对关系范式有哪些了解
- 178数据库
- 179Redis基础
- 180Redis单线程为什么还这么快
- 181Redis底层数据结构
- 182Redis持久化
- 183AOF日志
- 184RDB快照
- 185Redis功能
- 1862. 哨兵模式
- 1873. 切片集群
- 188Redis哨兵机制是什么
- 189什么是集群脑裂
- 190过期删除策略有哪些
- 191Redis的LRU算法和LFU算法有什么区别
- 192什么是缓存击穿
- 193如何保证删除缓存操作一定能成功?
- 194为什么Redis是单线程
- 195Redis底层使用了什么数据结构
- 196Redis实现分布式锁
- 197缓存中的热点数据和冷数据是什么
- 198缓存雪崩、击穿、穿透和解决办法【常问】
- 199Redis过期删除策略有哪些
- 200关键概念
- 201单例模式的应用场景
- 202工厂模式
- 203实际应用
- 204抽象工厂模式
- 205概念
- 206应用
- 207实现步骤
- 208主要角色
- 209代理模式应用
- 210策略模式
- 211示例
- 212装饰模式
- 213主要角色
- 21423种设计模式的概念
- 215创建型模式
- 216行为型模式
- 217设计原则
- 218迪米特法则
- 219你在实际开发中用过哪些设计模式
- 220依赖倒置
- 221代理模式和适配器模式有什么区别
- 222固定长度编码
- 223冯诺依曼模型
- 224总线
- 225输入/输出设备
- 226编译系统如何工作
- 227处理器解释指令
- 228场景题 & 系统设计
- 229如何设计一个本地缓存
- 230如何设计一个RPC框架