IP地址
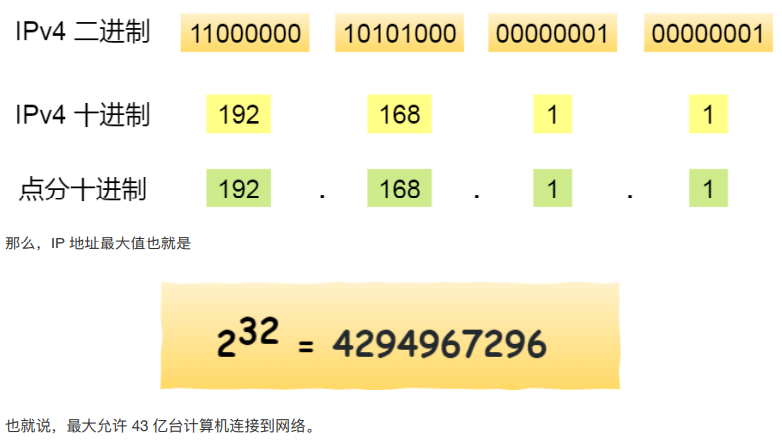
实际上让 43 亿台计算机全部连网其实是不可能的,更何况 IP 地址是由「网络标识」和「主机标识」这两个部分组成的,所以实际能够连接到网络的计算机个数更是少了很多。
但可以根据一种可以更换IP地址的技术NAT,使得可连接计算机数超过43亿台。
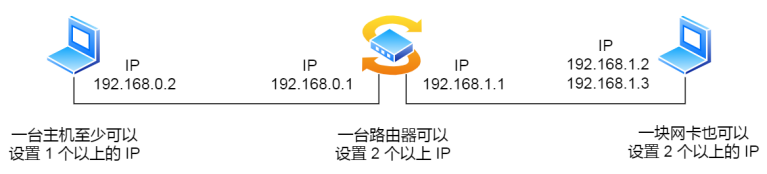
1、IP地址分类
IP地址被分为了五种类型:
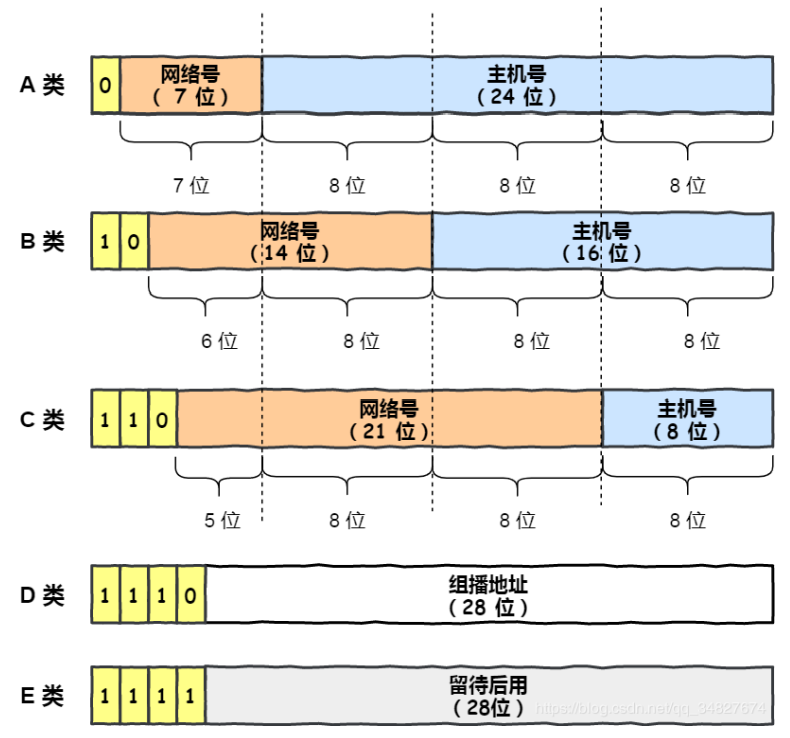
(1)A、B、C类地址
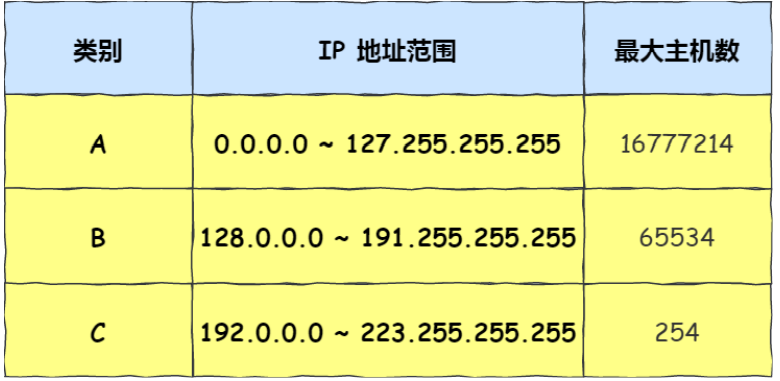
最大主机数=2^主机号位数-2,其中有两个地址,全0和全1是比较特殊的:
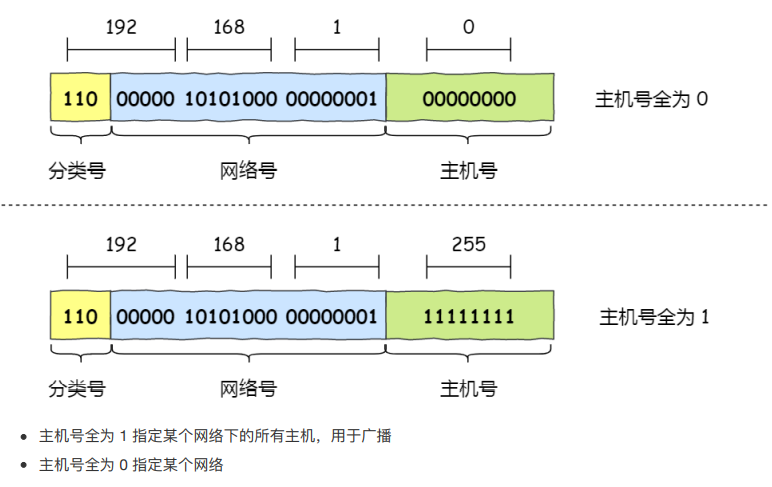
广播地址用于在同一个链路中相互连接的主机之间发送数据包。广播地址可以分为本地广播和直接广播两种。
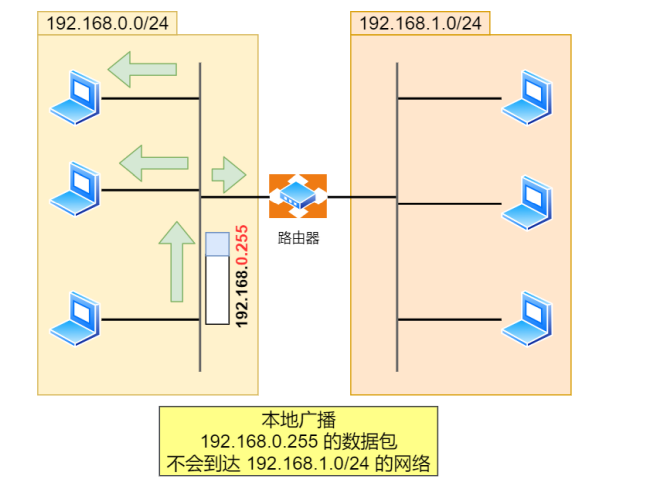
在本网络内广播的叫做本地广播。例如网络地址为 192.168.0.0/24的情况下,广播地址是 192.168.0.255。
因为这个广播地址的 IP 包会被路由器屏蔽,所以不会到达 192.168.0.0/24 以外的其他链路上。
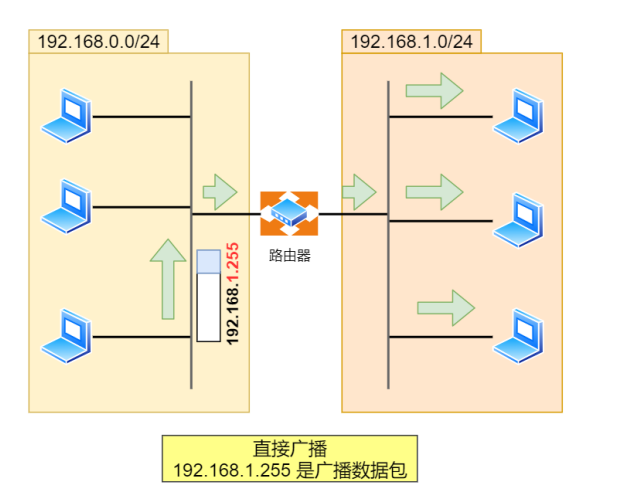
在不同网络之间的广播叫做直接广播。
例如网络地址为192.168.0.0/24 的主机向 192.168.1.255/24的目标地址发送 IP 包。收到这个包的路由器,将数据转发给192.168.1.0/24从而使得所有 192.168.1.1~192.168.1.254的主机都能收到这个包(由于直接
广播有一定的安全问题,多数情况下会在路由器上设置为不转发。)
(2)什么是D、E类地址?
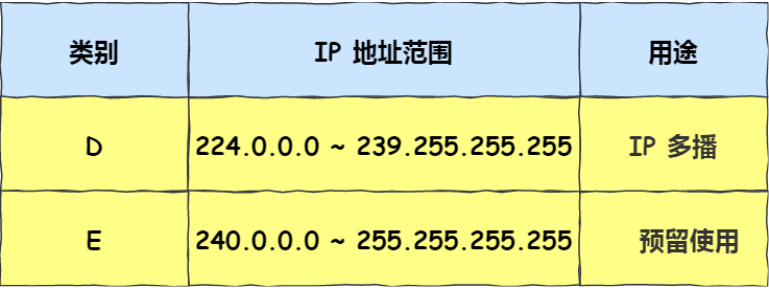
D 类和 E 类地址是没有主机号的,所以不可用于主机 IP,D 类常被用于多播,E 类是预留的分类,暂时未使用。
多播地址用于将包发送给特定组内的所有主机。由于广播无法穿透路由,若想给其他网段发送同样的包,就可以使用可以穿透路由的多播。
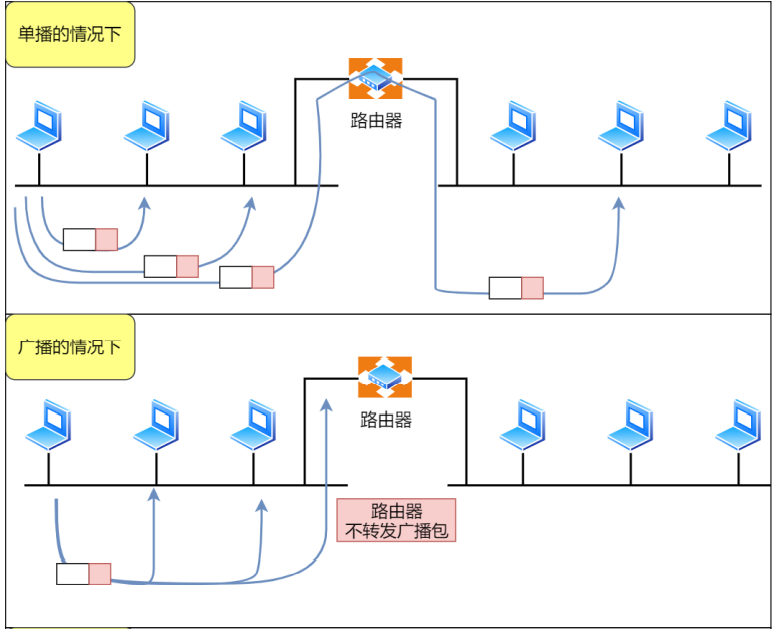
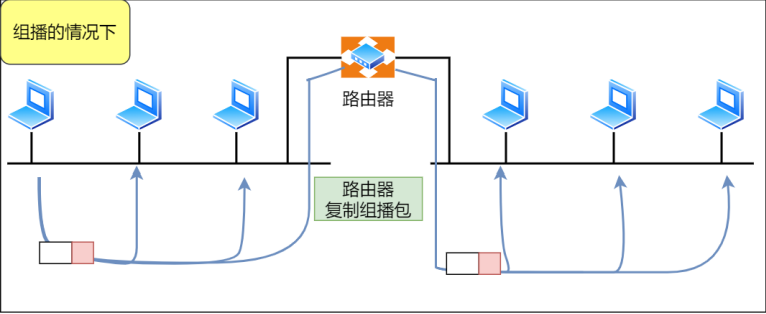
多播使用的 D 类地址,其前四位是 1110 就表示是多播地址,而剩下的 28 位是多播的组编号。
从 224.0.0.0 ~ 239.255.255.255 都是多播的可用范围,其划分为以下三类:
224.0.0.0 ~ 224.0.0.255 为预留的组播地址,只能在局域网中,路由器是不会进行转发的。
224.0.1.0 ~ 238.255.255.255 为用户可用的组播地址,可以用于 Internet 上。
239.0.0.0 ~ 239.255.255.255 为本地管理组播地址,可供内部网在内部使用,仅在特定的本地范围内有效。
(3)IP分类的优缺点
优点:
可以根据IP地址的前四位来判别IP地址属于哪个类别。简单明了,选路简单。
缺点:
同一网络下没有地址层次,比如一个公司里用了 B 类地址,但是可能需要根据生产环境、测试环境、开发环境来划分地址层次,而这种 IP 分类是没有地址层次划分的功能,所以这就缺少地址的灵活性。
A、B、C类有个尴尬处境,就是不能很好的与现实网络匹配。
C 类地址能包含的最大主机数量实在太少了,只有 254 个,估计一个网吧都不够用。
(4)CIDR无分类地址
这种方式不再有分类地址的概念,32 比特的 IP 地址被划分为两部分,前面是网络号,后面是主机号。
(i)如何划分网络号和主机号呢?
表示形式 a.b.c.d/x,其中 /x 表示前 x 位属于网络号, x 的范围是 0 ~ 32,这就使得 IP 地址更加具有灵活性。
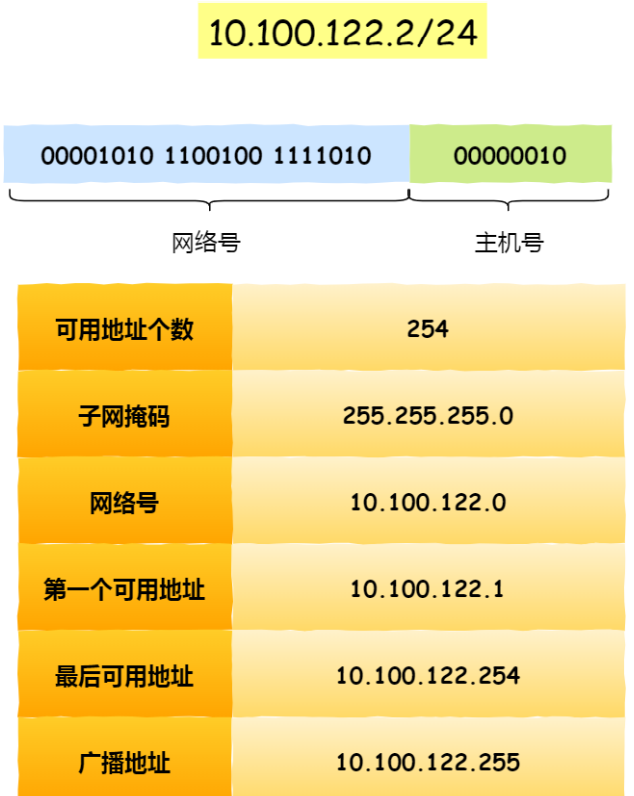
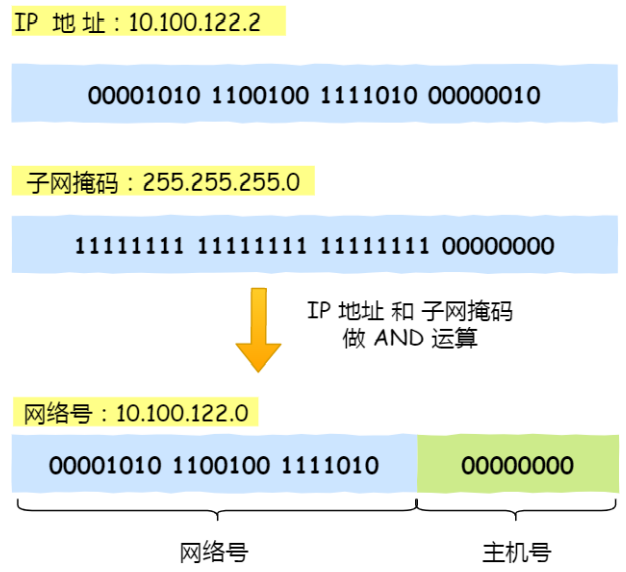
还有另一种划分网络号与主机号形式,那就是子网掩码,掩码的意思就是掩盖掉主机号,剩余的就是网络号。
将子网掩码和 IP 地址按位计算 AND,就可得到网络号。
(ii)为什么要分离网络号和主机号?
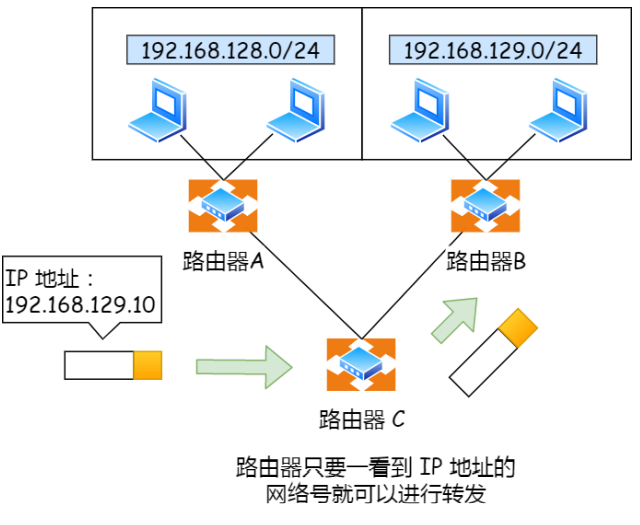
因为两台计算机要通讯,首先要判断是否处于同一个广播域内,即网络地址是否相同。如果网络地址相同,表明接受方在本网络上,那么可以把数据包直接发送到目标主机。
路由器寻址工作中,也就是通过这样的方式来找到对应的网络号的,进而把数据包转发给对应的网络内。
(iii)如何进行子网划分?
通过子网掩码划分出网络号和主机号,那实际上子网掩码还有一个作用,那就是划分子网。
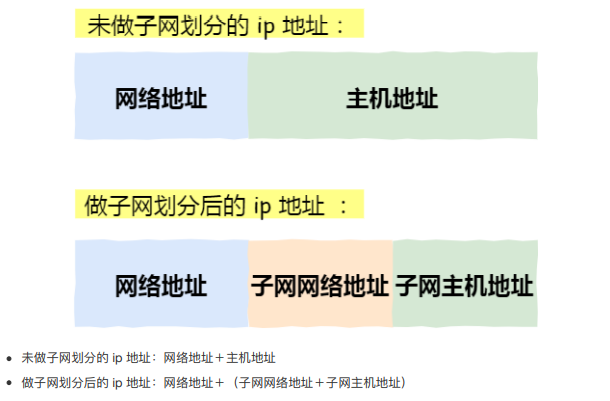
子网划分实际上是将主机地址分为两个部分:子网网络地址和子网主机地址。形式如下:
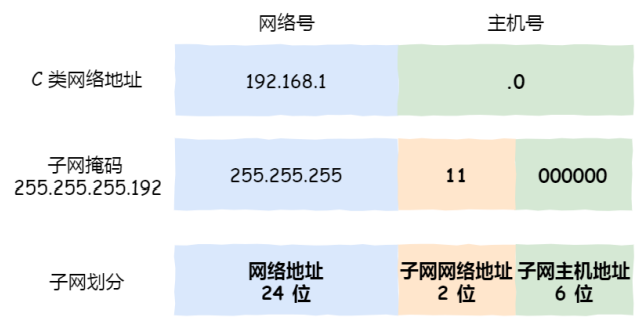
假设对 C 类地址进行子网划分,网络地址 192.168.1.0,使用子网掩码 255.255.255.192 对其进行子网划分。
C 类地址中前 24 位是网络号,最后 8 位是主机号,根据子网掩码可知从 8 位主机号中借用 2 位作为子网号(对应 4个子网)。
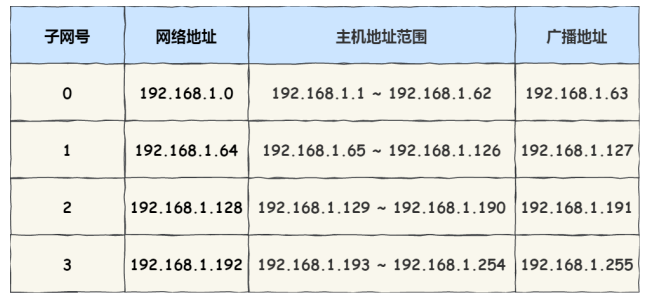
划分后的4个子网如下:
2、公有IP地址与私有IP地址
在A、B、C分类地址,实际又分公有IP地址和私有IP地址。
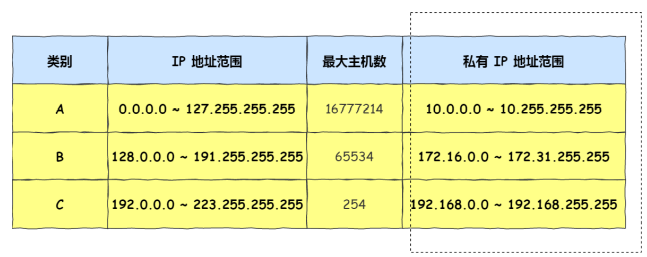
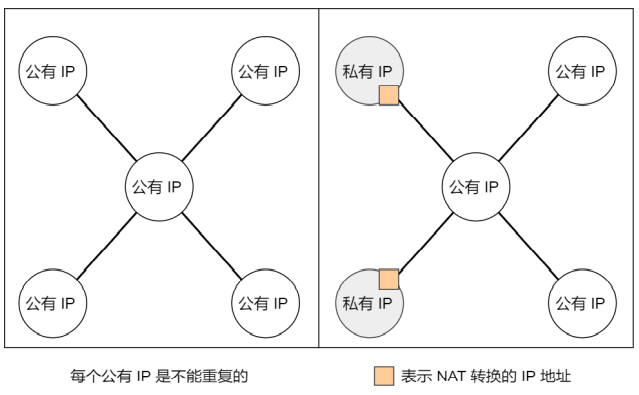
因此,你学校的某个私有 IP 地址和我学校的可以是一样的。就像每个小区都有自己的楼编号和门牌号,你小区家可以叫 1 栋 101 号,我小区家也可以叫 1 栋 101,没有任何问题。但一旦出了小区,就需要带上中山路 666 号
(公网 IP 地址),是国家统一分配的,不能两个小区都叫中山路 666。
所以,公有 IP 地址是有个组织统一分配的,假设你要开一个博客网站,那么你就需要去申请购买一个公有 IP,这样全世界的人才能访问。并且公有 IP 地址基本上要在整个互联网范围内保持唯一
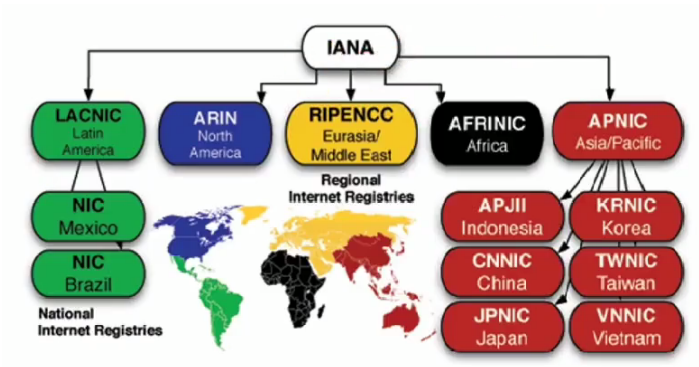
那么公有IP地址由谁管理呢?
私有 IP 地址通常是内部的 IT 人员管理,公有 IP 地址是由 ICANN 组织管理,中文叫「互联网名称与数字地址分配机构」。 IANA 是 ICANN 的其中一个机构,它负责分配互联网 IP 地址,是按州的方式层层分配。
3、IP地址与路由控制
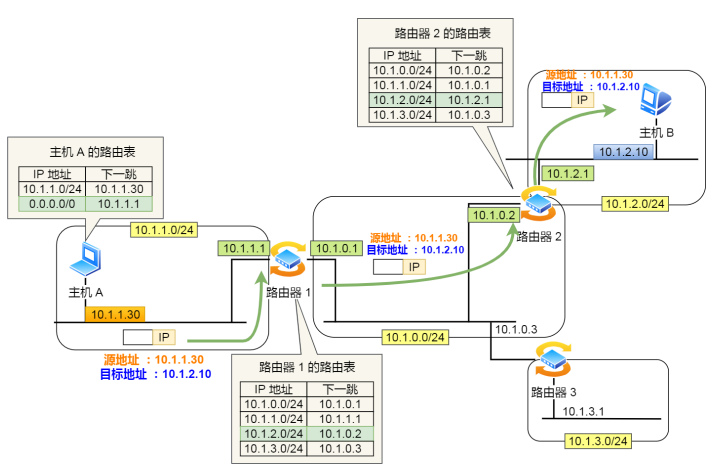
IP地址的网络地址这一部分是用于进行路由控制。路由控制表中记录着网络地址与下一步应该发送至路由器的地址。在主机和路由器上都会有各自的路由器控制表。
在发送 IP 包时,首先要确定 IP 包首部中的目标地址,再从路由控制表中找到与该地址具有相同网络地址的记录,根据该记录将 IP 包转发给相应的下一个路由器。如果路由控制表中存在多条相同网络地址的记录,就选择相同位
数最多的网络地址,也就是最长匹配。
举例说明:
环回地址是不会流向网络:
环回地址是在同一台计算机上的程序之间进行网络通信时所使用的一个默认地址。计算机使用一个特殊的 IP 地址 127.0.0.1 作为环回地址。
与该地址具有相同意义的是一个叫做 localhost 的主机名。使用这个 IP 或主机名时,数据包不会流向网络
4、IP分片与重组
每种数据链路的最大传输单元 MTU 都是不相同的,如 FDDI 数据链路 MTU 4352、以太网的 MTU 是 1500 字节等。
每种数据链路的 MTU 之所以不同,是因为每个不同类型的数据链路的使用目的不同。使用目的不同,可承载的 MTU 也就不同。
其中,我们最常见数据链路是以太网,它的 MTU 是 1500 字节。那么当 IP 数据包大小大于 MTU 时, IP 数据包就会被分片。经过分片之后的 IP 数据报在被重组的时候,只能由目标主机进行,路由器是不会进行重组的。
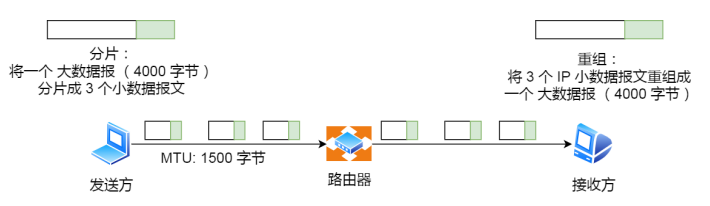
在分片传输中,一旦某个分片丢失,则会造成整个 IP 数据报作废,所以 TCP 引入了 MSS 也就是在 TCP 层进行分片不由 IP 层分片,那么对于 UDP 我们尽量不要发送一个大于 MTU 的数据报文。
5、IPV6基本认识
IPV6:更多的地址,更好的安全性和扩展性。
但IPV4和IPV6不能兼容。所以不但要我们电脑、手机之类的设备支持,还需要网络运营商对现有的设备进行升级,所以这可能是 IPv6 普及率比较慢的一个原因。
(1)IPV6的亮点
了传输的性能。
IPv6 有应对伪造 IP 地址的网络安全功能以及防止线路窃听的功能,大大提升了安全性。
(2)IPV6地址的标识方法
IPv4 地址长度共 32 位,是以每 8 位作为一组,并用点分十进制的表示方式。
IPv6 地址长度是 128 位,是以每 16 位作为一组,每组用冒号「:」隔开。
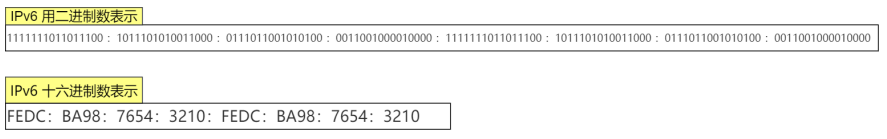
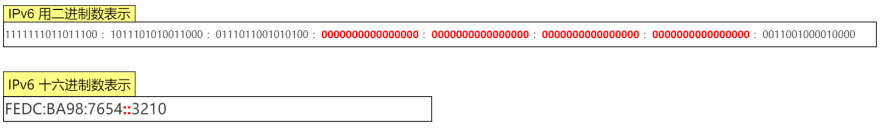
如果出现连续的 0 时还可以将这些 0 省略,并用两个冒号「::」隔开。但是,一个 IP 地址中只允许出现一次两个连续的冒号。
(3)IPV6地址的结构
IPv6 类似 IPv4,也是通过 IP 地址的前几位标识 IP 地址的种类。 IPv6 的地址主要有以下类型地址:
单播地址:用于一对一的通信;
组播地址:用于一对多的通信;
任播地址:用于通信最近的节点,最近的节点是由路由协议决定;
没有广播地址。
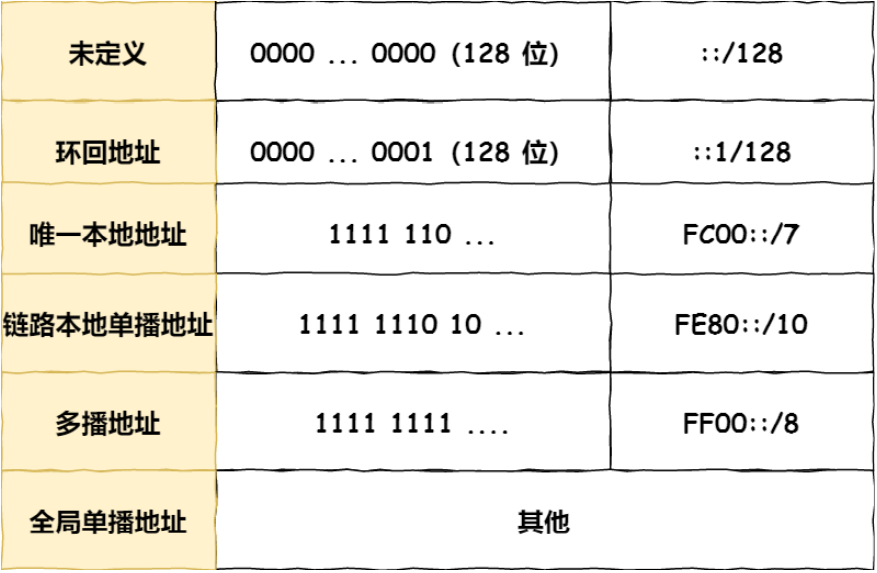
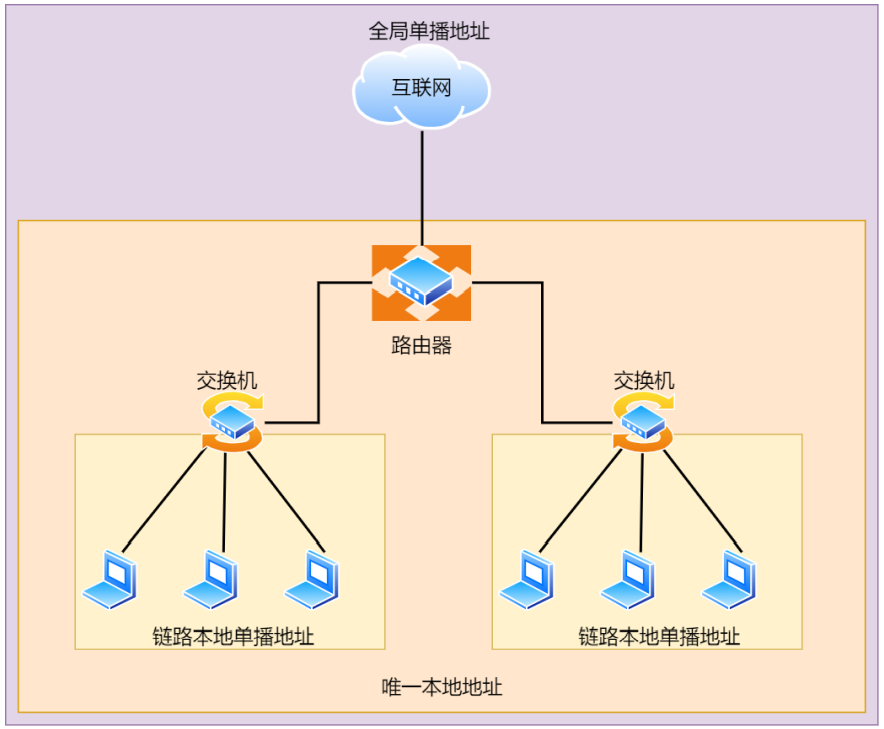
在内网里单播通信,可以使用唯一本地地址,相当于 IPv4 的私有 IP
在互联网通信,可以使用全局单播地址,相当于 IPv4 的公有 IP
6、IPV4首部与IPV6首部
IPv4 首部与 IPv6 首部 IPv4 首部与 IPv6 首部的差异如下图:
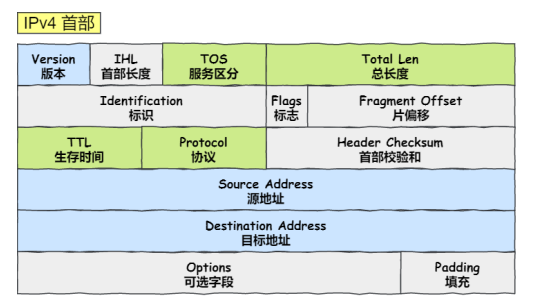
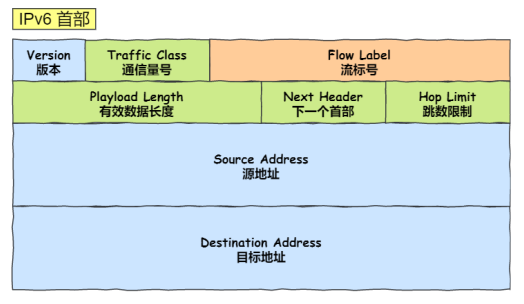
其中:
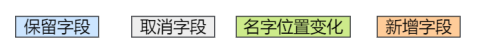
IPV6相比IPV4的首部改进
取消了首部校验和字段:
因为在数据链路层和传输层都会校验,因此 IPv6 直接取消了 IP 的校验。
取消了分片/重新组装相关字段:
分片与重组是耗时的过程,IPv6 不允许在中间路由器进行分片与重组,这种操作只能在源与目标主机,这将大大提高了路由器转发的速度。
取消选项字段:
选项字段不再是标准 IP 首部的一部分了,但它并没有消失,而是可能出现在 IPv6 首部中的「下一个首部」指出的位置上。删除该选项字段使的 IPv6 的首部成为固定长度的 40 字节。
2、ARP与RARP协议
(1)ARP协议
在传输一个 IP 数据报的时候,确定了源 IP 地址和目标 IP 地址后,就会通过主机「路由表」确定 IP 数据包下一跳。然而,网络层的下一层是数据链路层,所以我们还要知道「下一跳」的 MAC 地址。
由于主机的路由表中可以找到下一跳的 IP 地址,所以可以通过 ARP 协议(Address Resolution Protocol,地址解析协议),求得下一跳的 MAC 地址。
ARP是如何知道对方的MAC地址的呢?ARP 是借助 ARP 请求与 ARP 响应两种类型的包确定 MAC 地址的。
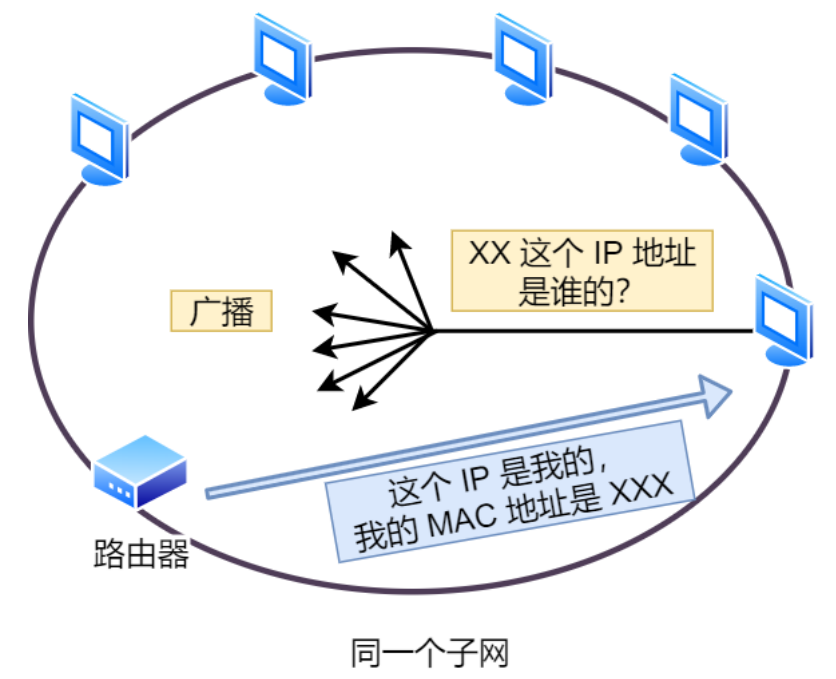
主机会通过广播发送 ARP 请求,这个包中包含了想要知道的 MAC 地址的主机 IP 地址。
当同个链路中的所有设备收到 ARP 请求时,会去拆开 ARP 请求包里的内容,如果 ARP 请求包中的目标 IP 地址与自己的 IP 地址一致,那么这个设备就将自己的 MAC 地址塞入 ARP 响应包返回给主机。
操作系统通常会把第一次通过 ARP 获取的 MAC 地址缓存起来,以便下次直接从缓存中找到对应 IP 地址的 MAC 地址。不过,MAC 地址的缓存是有一定期限的,超过这个期限,缓存的内容将被清除。
(2)RARP协议
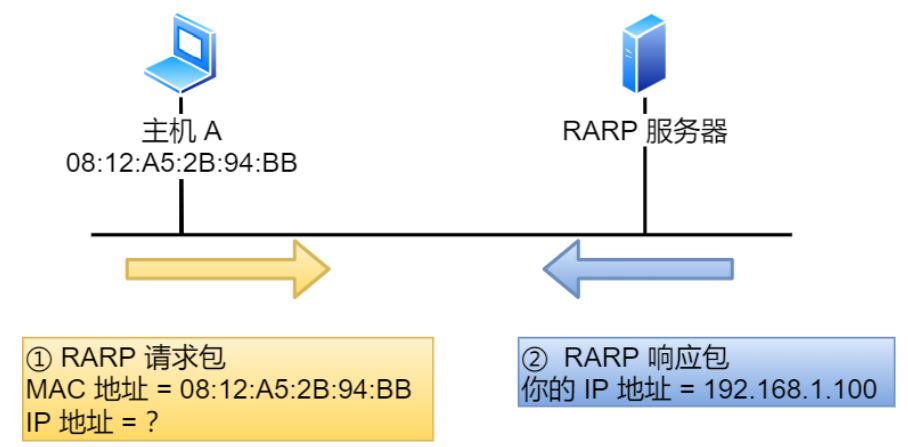
ARP 协议是已知 IP 地址求 MAC 地址,那 RARP 协议正好相反,它是已知 MAC 地址求 IP 地址。
例如将打印机服务器等小型嵌入式设备接入到网络时就经常会用得到。通常这需要架设一台 RARP 服务器,在这个服务器上注册设备的 MAC 地址及其 IP 地址。然后再将这个设备接入到网络
接着:
3、DHCP动态获取IP地址
DHCP(Dynamic Host Configuration Protocol,动态主机配置协议)。我们的电脑通常都是通过 DHCP 动态获取 IP 地址,大大省去了配 IP 信息繁琐的过程。
接下来,我们来看看我们的电脑是如何通过 4 个步骤的过程,获取到 IP 的:
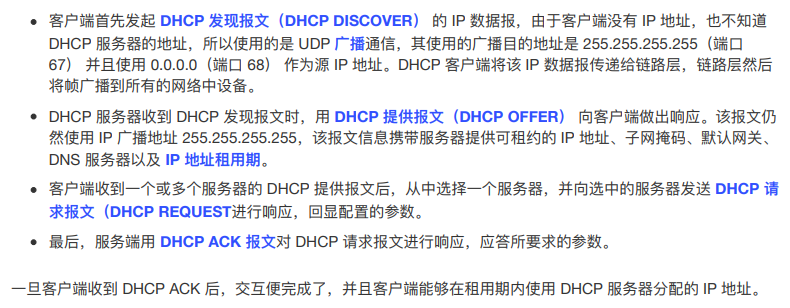
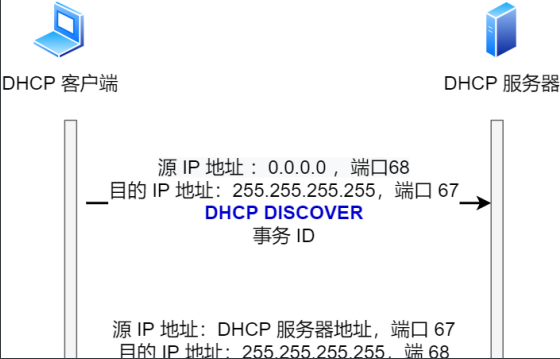
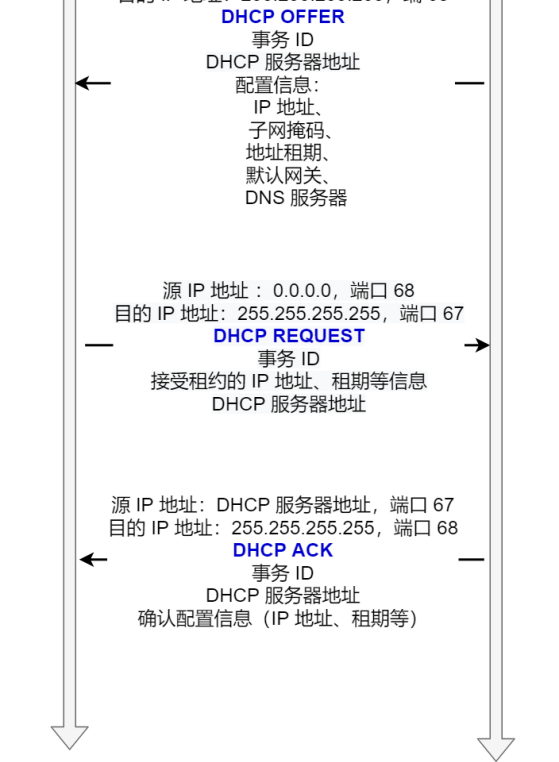
说明: DHCP 客户端进程监听的是 68 端口号,DHCP 服务端进程监听的是 67 端口号。
如果租约的 DHCP IP 地址快期后,客户端会向服务器发送 DHCP 请求报文:
服务器如果同意继续租用:
则用 DHCP ACK 报文进行应答,客户端就会延长租期。
服务器如果不同意继续租用:
则用 DHCP NACK 报文,客户端就要停止使用租约的 IP 地址。可以发现,DHCP 交互中,全程都是使用 UDP 广播通信。
疑问:
咦,用的是广播,那如果 DHCP 服务器和客户端不是在同一个局域网内,路由器又不会转发广播包,那不是每个网络都要配一个 DHCP 服务器?
为了解决这一问题,就出现了 DHCP 中继代理。有了 DHCP 中继代理以后,对不同网段的 IP 地址分配也可以由一
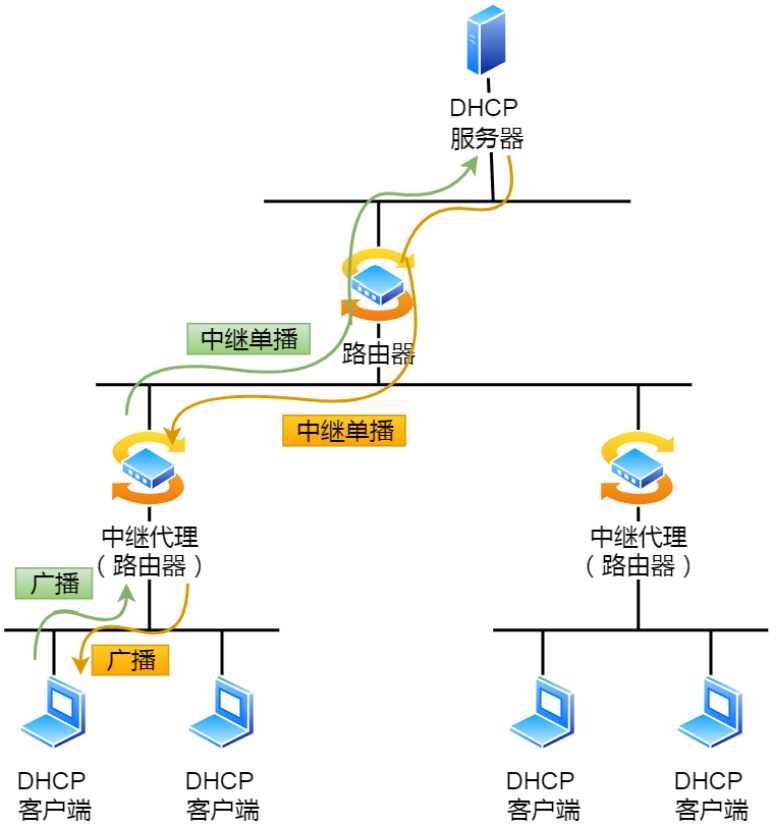
DHCP 客户端会向 DHCP 中继代理发送 DHCP 请求包,而 DHCP 中继代理在收到这个广播包以后,再以单播的形式发给 DHCP 服务器。
服务器端收到该包以后再向 DHCP 中继代理返回应答,并由 DHCP 中继代理将此包广播给 DHCP 客户端。
因此,DHCP 服务器即使不在同一个链路上也可以实现统一分配和管理IP地址。
4、NAT( Network Address Translation, 网络地址转换)
IPv4 的地址是非常紧缺的,在前面我们也提到可以通过无分类地址来减缓 IPv4 地址耗尽的速度,但是互联网的用户增速是非常惊人的,所以 IPv4 地址依然有被耗尽的危险。
于是,提出了一种网络地址转换 NAT 的方法,再次缓解了 IPv4 地址耗尽的问题。简单的来说 NAT 就是同个公司、家庭、教室内的主机对外部通信时,把私有 IP 地址转换成公有 IP 地址。
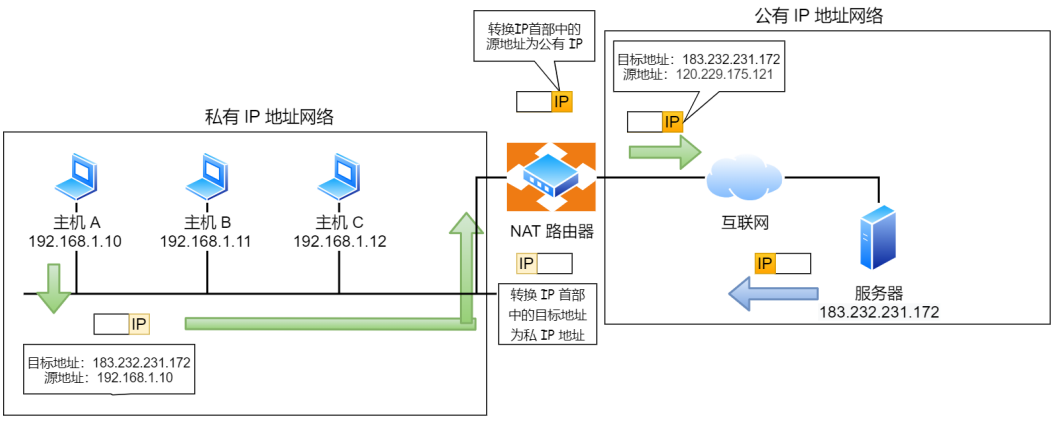
疑问:
那不是 N 个私有 IP 地址,你就要 N 个公有 IP 地址?这怎么就缓解了 IPv4 地址耗尽的问题?这不瞎扯吗?
确实是,普通的 NAT 转换没什么意义。由于绝大多数的网络应用都是使用传输层协议 TCP 或 UDP 来传输数据的。因此,可以把 IP 地址 + 端口号一起进行转换。这样,就用一个全球 IP 地址就可以了,这种转换技术就叫网
络地址与端口转换 NAPT。
来看看下面的图解:
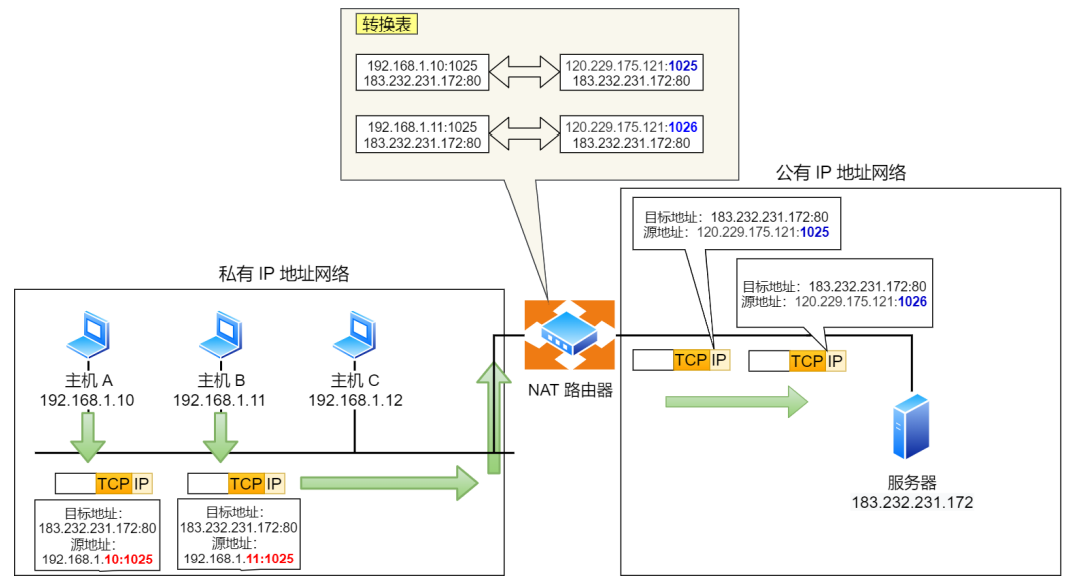
图中有两个客户端 192.168.1.10 和 192.168.1.11 同时与服务器 183.232.231.172 进行通信,并且这两个客户端的本地端口都是 1025。此时,两个私有 IP 地址都转换 IP 地址为公有地址 120.229.175.121,但是以不同的端口号
作为区分。
于是,生成一个 NAPT 路由器的转换表,就可以正确地转换地址跟端口的组合,令客户端 A、B 能同时与服务器之间进行通信。这种转换表在 NAT 路由器上自动生成。例如,在 TCP 的情况下,建立 TCP 连接首次握手时的 SYN
外部无法主动与 NAT 内部服务器建立连接,因为 NAPT 转换表没有转换记录。
转换表的生成与转换操作都会产生性能开销。
通信过程中,如果 NAT 路由器重启了,所有的 TCP 连接都将被重置。
(2)如何解决NAT潜在的问题呢?
改用IPV6:
IPv6 可用范围非常大,以至于每台设备都可以配置一个公有 IP 地址,就不搞那么多花里胡哨的地址转换了,但是 IPv6 普及速度还需要一些时间。
NAT 穿透技术:
NAT 穿越技术能够让网络应用程序主动发现自己位于 NAT 设备之后,并且会主动获得 NAT 设备的公有 IP,并为自己建立端口映射条目,注意这些都是 NAT设备后的应用程序自动完成的。也就是说,客户端主动从 NAT 设备获取
公有 IP 地址,然后自己建立端口映射条目,然后用这个条目对外通信,就不需要 NAT 设备来进行转换了。
5、ICMP互联网控制报文协议
ICMP( Internet Control Message Protocol,也就是互联网控制报文协议)。
网络包在复杂的网络传输环境里,常常会遇到各种问题。当遇到问题的时候,总不能死个不明不白,没头没脑的作风不是计算机网络的风格。所以需要传出消息,报告遇到了什么问题,这样才可以调整传输策略,以此来控制整个
局面。
(1)ICMP功能都有啥
ICMP的主要功能包括:确认 IP 包是否成功送达目标地址、报告发送过程中 IP 包被废弃的原因和改善网络设置等。
在 IP 通信中如果某个 IP 包因为某种原因未能达到目标地址,那么这个具体的原因将由 ICMP 负责通知。
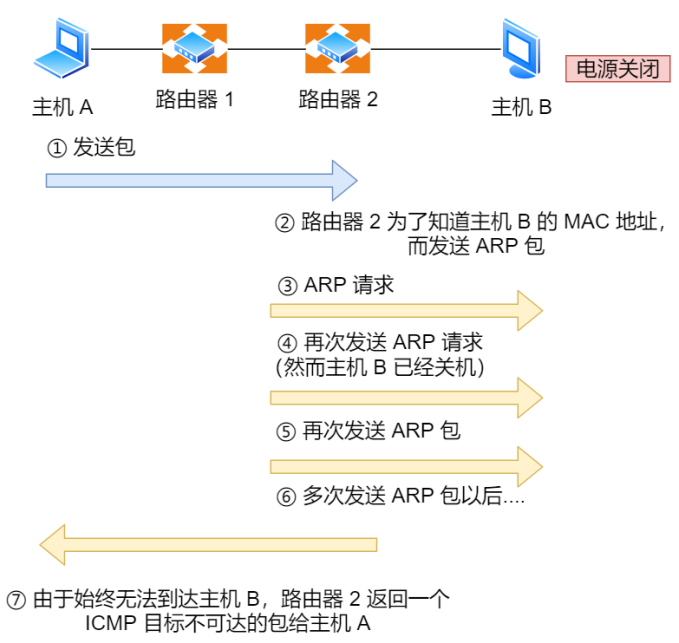
ICMP 的这种通知消息会使用IP进行发送。因此,从路由器 2 返回的 ICMP 包会按照往常的路由控制先经过路由器 1 再转发给主机A。收到该 ICMP 包的主机 A 则分解 ICMP 的首部和数据域以后得知具体发生问题的原因。
(2)ICMP的类型
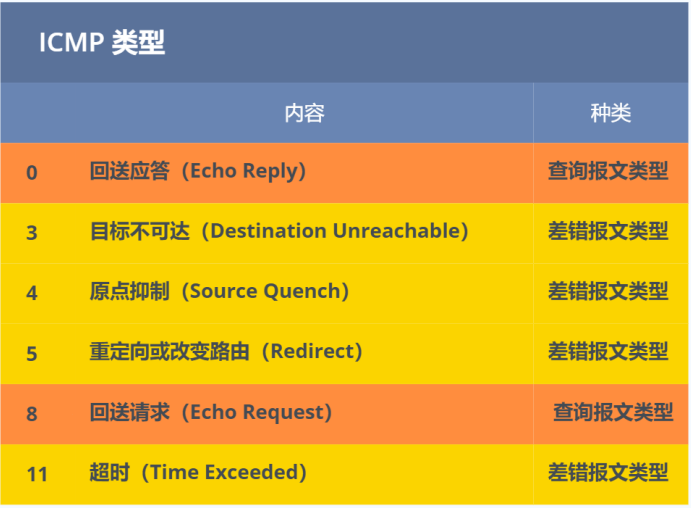
ICMP大致可以分为两大类:
一类是用于诊断的查询消息,也就是「查询报文类型」
一类是通知出错原因的错误消息,也就是「差错报文类型」
那么,就需要 IGMP 协议了。
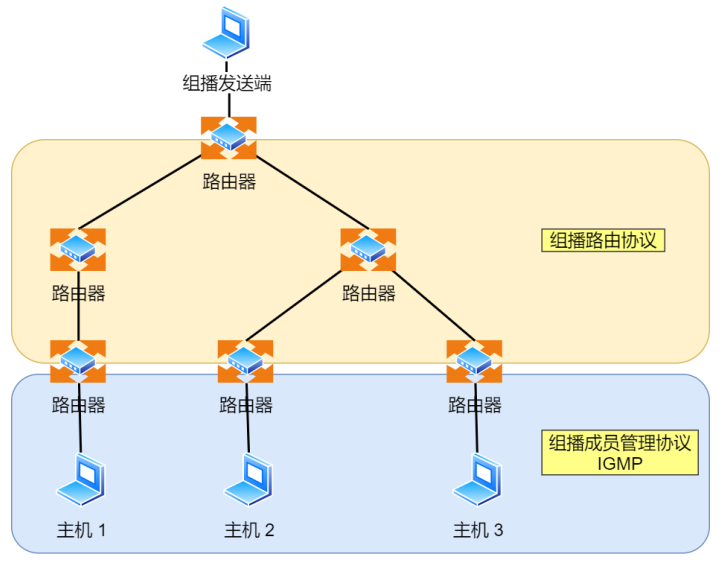
IGMP 是因特网组管理协议,工作在主机(组播成员)和最后一跳路由之间,如上图中的蓝色部分。
IGMP 报文向路由器申请加入和退出组播组,默认情况下路由器是不会转发组播包到连接中的主机,除非主机通过 IGMP 加入到组播组,主机申请加入到组播组时,路由器就会记录 IGMP 路由器表,路由器后续就会转发组播包到
对应的主机了。
IGMP 报文采用 IP 封装,IP 头部的协议号为 2,而且 TTL 字段值通常为 1,因为 IGMP 是工作在主机与连接的路由器之间。
(1)IGMP的工作机制
IGMP 分为了三个版本分别是,IGMPv1、IGMPv2、IGMPv3。接下来,以 IGMPv2 作为例子,说说常规查询与响应和离开组播组这两个工作机制。
常规查询与响应机制:
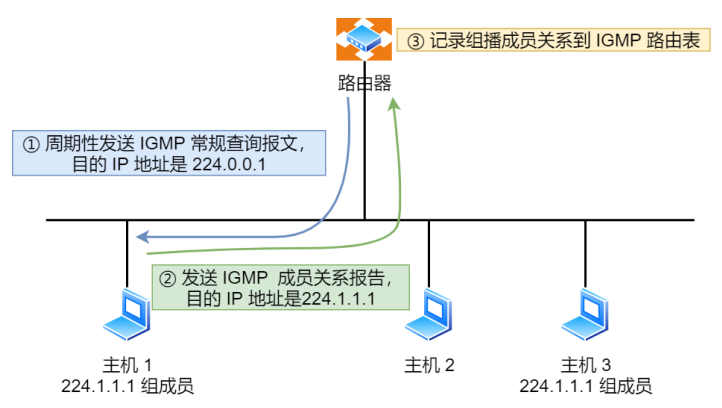
秒,计时器超时后主机就会发送 IGMP 成员关系报告报文(源 IP 地址为自己主机的 IP 地址,目的 IP 地址为组播地址)。如果在定时器超时之前,收到同一个组内的其他主机发送的成员关系报告报文,则自己不再发送,这样可以
减少网络中多余的 IGMP 报文数。
(iii)路由器收到主机的成员关系报文后,就会在 IGMP 路由表中加入该组播组,后续网络中一旦该组播地址的数据到达路由器,它会把数据包转发出去
离开组播组工作机制:
情况1:
网段中仍有该组播组
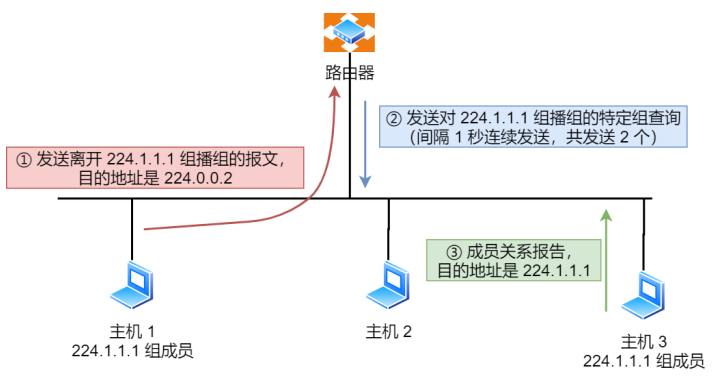
(i)主机 1 要离开组 224.1.1.1,发送 IGMPv2 离组报文,报文的目的地址是 224.0.0.2(表示发向网段内的所有路由器)
(ii)路由器收到该报文后,以 1 秒为间隔连续发送 IGMP 特定组查询报文(共计发送 2 个),以便确认该网络是否还有 224.1.1.1 组的其他成员。
(iii)主机 3 仍然是组 224.1.1.1 的成员,因此它立即响应这个特定组查询。路由器知道该网络中仍然存在该组播组的成员,于是继续向该网络转发 224.1.1.1 的组播数据包。
情况2:
网段中没有该组播组
全站分卷索引 · 230 卷
- 1代码随想录知识星球精华(最强八股文)第五版(计算机基础篇)
- 2DNS
- 3DNS解析过程
- 4递归查询和迭代查询
- 5HTTP特性与简述
- 6HTTP版本演变
- 7HTTP/2
- 8HTTP1.1协议的性能问题
- 9兼容HTTP1.1
- 10二进制帧
- 11并发传输
- 12服务器主动推送资源
- 13总结
- 14HTTP/3
- 15HTTP/2的缺点
- 16QUIC协议的特点
- 17HTTP/3协议
- 18HTTP缓存
- 19协商缓存
- 20HTTPS
- 21HTTPS的特点
- 22非对称加密
- 23摘要算法+数字签名
- 24数字证书
- 25证书信任链
- 26HTTPS是怎么建立连接的
- 27TCP与UDP头部格式
- 28TCP
- 29列举TCP选项
- 30TCP三次握手
- 31为什么需要三次握手?
- 32什么是半连接队列
- 33什么是SYN攻击
- 34为什么挥手需要四次
- 35TIME_WAIT 过多有什么危害?
- 36TCP的滑动窗口
- 374. 程序是如何表示发送方的四个部分的呢?
- 386. 接收窗口和发送窗口的大小是相等的吗?
- 391. 慢启动
- 403. 拥塞发生
- 414. 快速恢复
- 42IP基础
- 43IP地址
- 44在浏览器中输入URL并按下回车之后会发生什么
- 45TCP 抓包实践
- 46TCP连接与断开优化
- 47TCP内核参数
- 48主动方的优化
- 49被动方的优化
- 50Linux是如何收发网络包的
- 51收发流程
- 52面试题
- 53TCP/IP四层网络模型
- 54五层网络体系结构
- 55HTTP响应报文
- 56HTTP常见字段
- 57什么是TCP粘包问题?如何解决TCP粘包问题?
- 58UDP会不会产生粘包问题呢?
- 59请求报文
- 60时间消耗
- 61HTTP缓存有几种
- 62HTTP1.0和HTTP1.1的区别?
- 63HTPP1.1和HTTP1.0有什么区别
- 64HTTP/3
- 65HTTPS是如何建立连接的
- 66DNS是什么
- 67递归查询和迭代查询
- 68TCP与UDP的区别
- 69TCP和UDP分别在什么场景使用?
- 70三次握手的过程
- 71Keep-Alive的优缺点
- 72CDN的工作流程
- 73Session的工作原理
- 74TCP重传机制是怎么实现的?
- 75什么是SS0
- 76HTTP优化方案
- 77浏览器地址栏输入URL回车后涉及到的流程
- 781.5 浏览器发送HTTP/HTTPS请求到web服务器
- 79SYN攻击
- 80操作系统
- 81操作系统的功能
- 82进程和线程
- 83线程基础
- 84进程调度
- 85进程调度方式
- 86进程通信
- 87消息传递(消息队列)
- 88信号量
- 89信号
- 90线程通信
- 91多线程
- 92进程通信
- 93消息队列
- 94信号
- 95守护进程
- 96互斥与同步
- 974. 互斥锁解锁
- 983. 处理方法
- 99读写锁
- 1002. 销毁读写锁
- 1014. 写锁定
- 1021. 创建条件变量
- 1034. 阻塞线程
- 104信号量
- 1054. V操作
- 1062. 读者-写者问题
- 107存储系统
- 108虚拟内存
- 109内存分段
- 110内存分页
- 111虚拟内存
- 112文件系统
- 1135. 文件访问
- 114目录
- 1154. 目录操作
- 1163. 目录的实现
- 1177. 虚拟文件系统
- 1184. 文件系统性能
- 119磁盘编址
- 120三层抽象
- 121外设管理
- 122Linux
- 123select/poll/epoll的区别和联系
- 124Linux 内存管理
- 125Linux虚拟内存
- 126Linux 信号
- 127Linux设计
- 1283. 各种IO模型的比较
- 129Linux网络
- 130Linux中的软链接和硬链接有什么区别?
- 131什么是中断和异常
- 132信号和信号量有什么区别
- 133Linux中如何查看一个进程
- 134进程、线程的区别?
- 135进程之间的通信方式
- 136如何解除死锁
- 137分段和分页的区别
- 138IO多路复用
- 139MySQL表连接
- 140过滤条件
- 141执行一次update语句,发生了什么
- 142用户账号存储
- 143用户账号删除
- 144索引
- 145索引有哪些类别
- 1462. 按照存储分类
- 1475. 按照字段个数分类
- 148索引区分度
- 149索引什么时候会失效
- 150事务的四大特性ACID
- 151并行事务会出现什么问题
- 152幻读是如何解决的
- 153事务隔离的实现
- 154读已提交是怎么实现的
- 155锁
- 1561、全局锁
- 1573、行级锁
- 158锁的划分
- 1592.、程序员角度
- 160Innodb使用表锁还是行锁
- 161什么是binlog
- 162执行引擎
- 163MySQL常见问题
- 1642. 事务
- 1653. 脏页
- 1664. 表结构
- 1676. 查询效率
- 168MySQL分库分表
- 169垂直分表
- 170水平分库
- 171分库分表的问题
- 172数据库排序思路
- 173MySQL主从复制
- 1745. 主从复制模式
- 175面试题
- 176执行一条select语句,发生了什么?
- 177你对关系范式有哪些了解
- 178数据库
- 179Redis基础
- 180Redis单线程为什么还这么快
- 181Redis底层数据结构
- 182Redis持久化
- 183AOF日志
- 184RDB快照
- 185Redis功能
- 1862. 哨兵模式
- 1873. 切片集群
- 188Redis哨兵机制是什么
- 189什么是集群脑裂
- 190过期删除策略有哪些
- 191Redis的LRU算法和LFU算法有什么区别
- 192什么是缓存击穿
- 193如何保证删除缓存操作一定能成功?
- 194为什么Redis是单线程
- 195Redis底层使用了什么数据结构
- 196Redis实现分布式锁
- 197缓存中的热点数据和冷数据是什么
- 198缓存雪崩、击穿、穿透和解决办法【常问】
- 199Redis过期删除策略有哪些
- 200关键概念
- 201单例模式的应用场景
- 202工厂模式
- 203实际应用
- 204抽象工厂模式
- 205概念
- 206应用
- 207实现步骤
- 208主要角色
- 209代理模式应用
- 210策略模式
- 211示例
- 212装饰模式
- 213主要角色
- 21423种设计模式的概念
- 215创建型模式
- 216行为型模式
- 217设计原则
- 218迪米特法则
- 219你在实际开发中用过哪些设计模式
- 220依赖倒置
- 221代理模式和适配器模式有什么区别
- 222固定长度编码
- 223冯诺依曼模型
- 224总线
- 225输入/输出设备
- 226编译系统如何工作
- 227处理器解释指令
- 228场景题 & 系统设计
- 229如何设计一个本地缓存
- 230如何设计一个RPC框架