被动方的优化
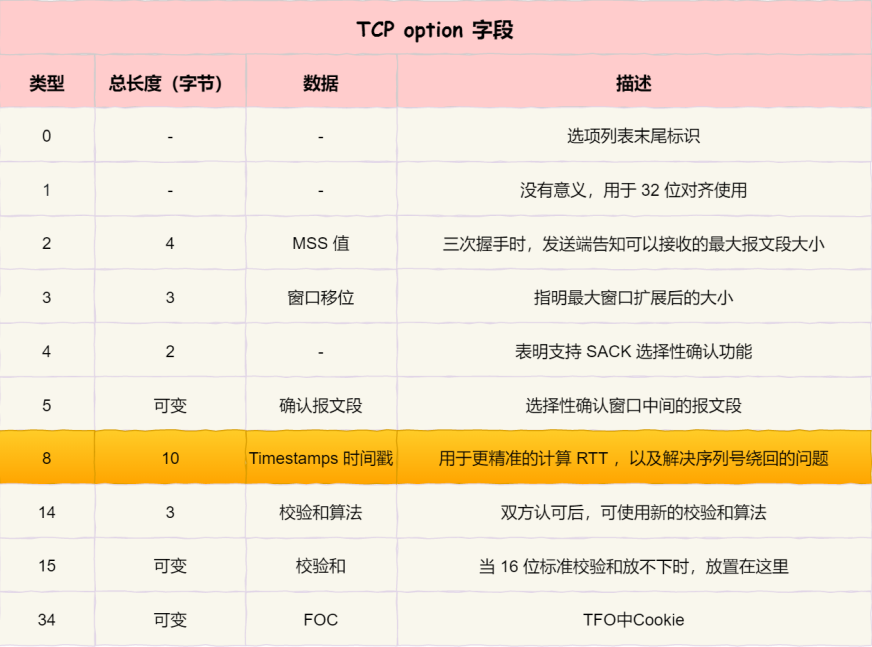
开启tcp_tw_reuse功能后,如果四次挥手中的最后一次ACK在网络中丢失了,会发生什么?
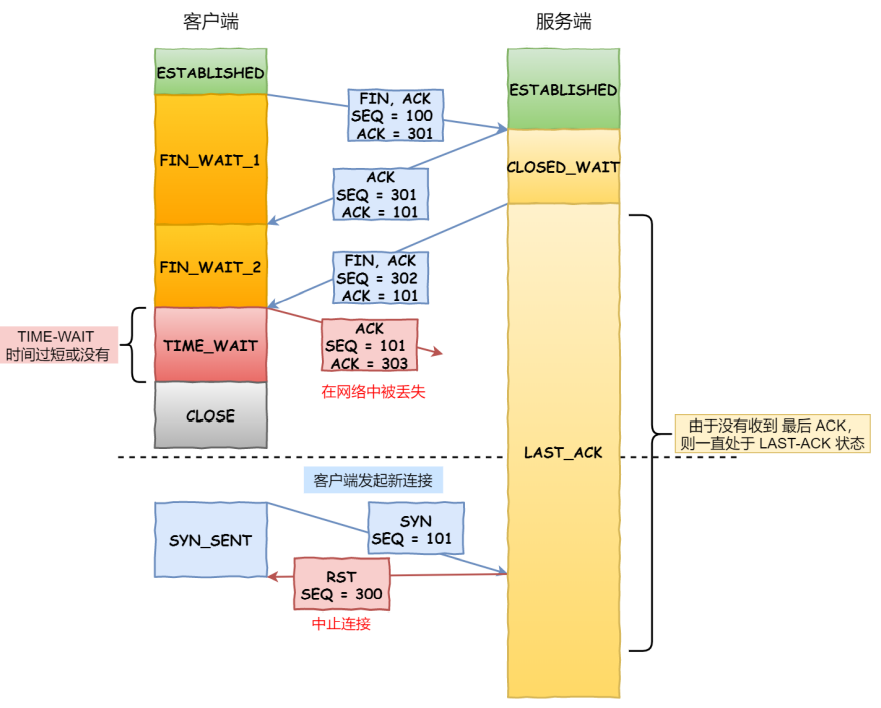
被动方的优化
1、如果连接双方同时关闭连接,会怎么样?
由于 TCP 是双全工的协议,所以是会出现两方同时关闭连接的现象,也就是同时发送了 FIN 报文。
此时,上面介绍的优化策略仍然适用。两方发送 FIN 报文时,都认为自己是主动方,所以都进入了 FIN_WAIT1 状
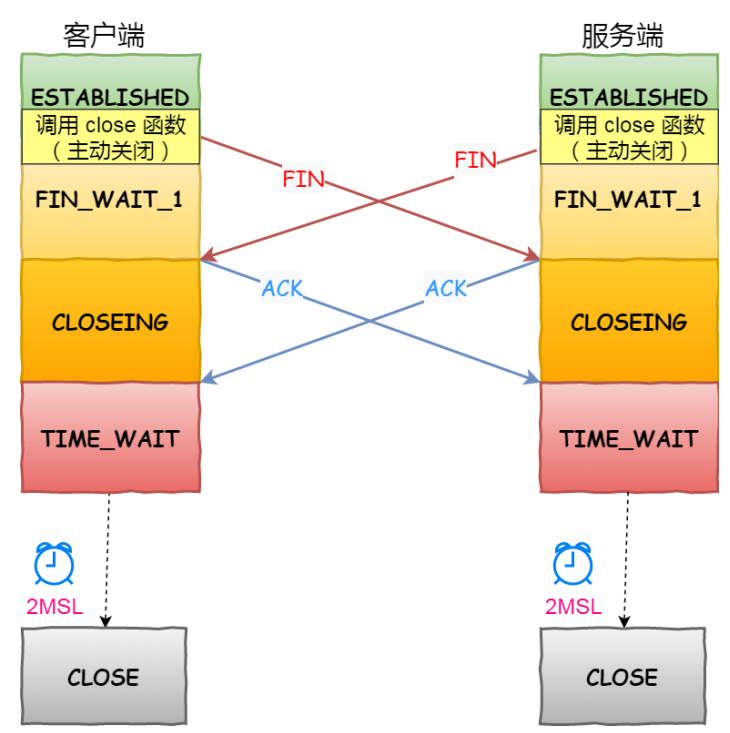
接下来,双方在等待 ACK 报文的过程中,都等来了 FIN 报文。这是一种新情况,所以连接会进入一种叫做 CLOSING 的新状态,它替代了 FIN_WAIT2 状态。接着,双方内核回复 ACK 确认对方发送通道的关闭后,进入
TIME_WAIT 状态,等待 2MSL 的时间后,连接自动关闭。
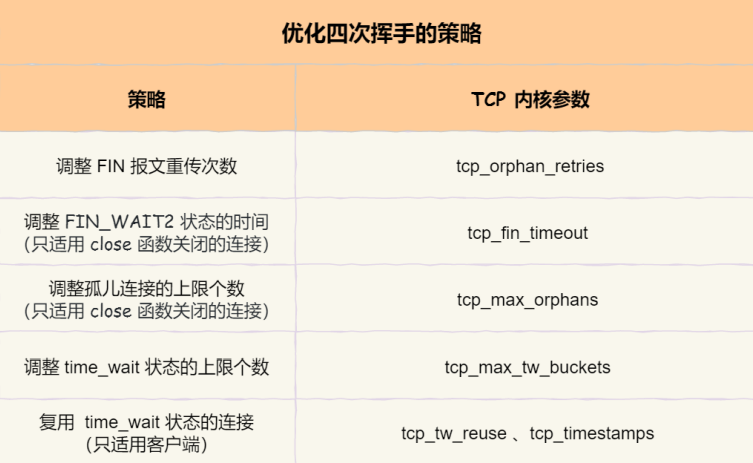
小结:
针对 TCP 四次挥手的优化,我们需要根据主动方和被动方四次挥手状态变化来调整系统 TCP 内核参数。
2、TCP数据传输性能的提升
TCP 连接是由内核维护的,内核会为每个连接建立内存缓冲区:
因此,我们必须理解 Linux 下 TCP 内存的用途,才能正确地配置内存大小。
(1)滑动窗口是如何影响传输速度的?
TCP 会保证每一个报文都能够抵达对方,机制如下:报文发出去后,必须接收到对方返回的确认报文 ACK,如果迟迟未收到,就会超时᯿发该报文,直到收到对方的 ACK 为止。
因此TCP报文发出去后,并不会立马从内存中删除,因为重传时还需要用到。由于TCP是由内核维护的,所以报文存放在内核缓冲区。
应答:
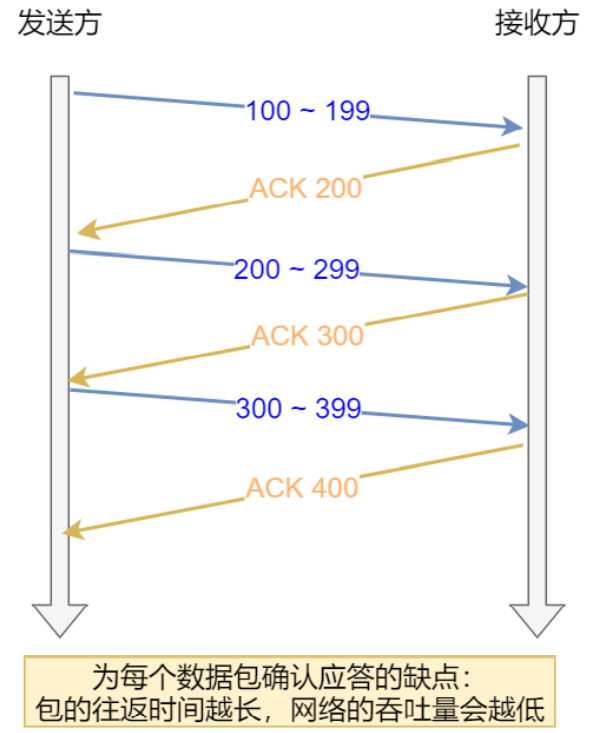
批量发送,批量应答:
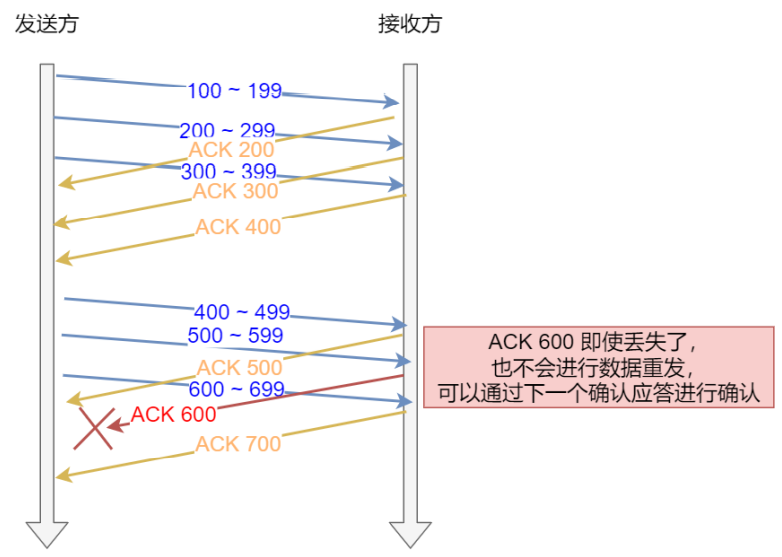
引发的问题:
当接收方硬件不如发送方,或者系统繁忙、资源紧张时,是无法瞬间处理这么多报文的。于是,这些报文只能被丢掉,使得网络效率非常低。
为了解决这种现象发生,TCP 提供一种机制可以让「发送方」根据「接收方」的实际接收能力控制发送的数据量,这就是滑动窗口的由来。
接收方根据它的缓冲区,可以计算出后续能够接收多少字节的报文,这个数字叫做接收窗口。当内核接收到报文时,必须用缓冲区存放它们,这样剩余缓冲区空间变小,接收窗口也就变小了;当进程调用 read 函数后,数据被
读入了用户空间,内核缓冲区就被清空,这意味着主机可以接收更多的报文,接收窗口就会变大。
因此,接收窗口并不是恒定不变的,接收方会把当前可接收的大小放在 TCP 报文头部中的窗口字段,这样就可以起到窗口大小通知的作用。
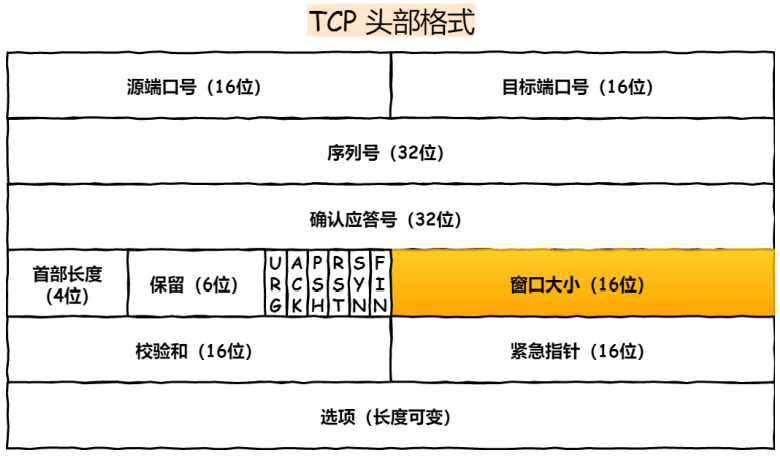
从上图中可以看到,窗口字段只有 2 个字节,因此它最多能表达 65535 字节大小的窗口,也就是 64KB 大小。
这个窗口大小最大值,在当今高速网络下,很明显是不够用的。
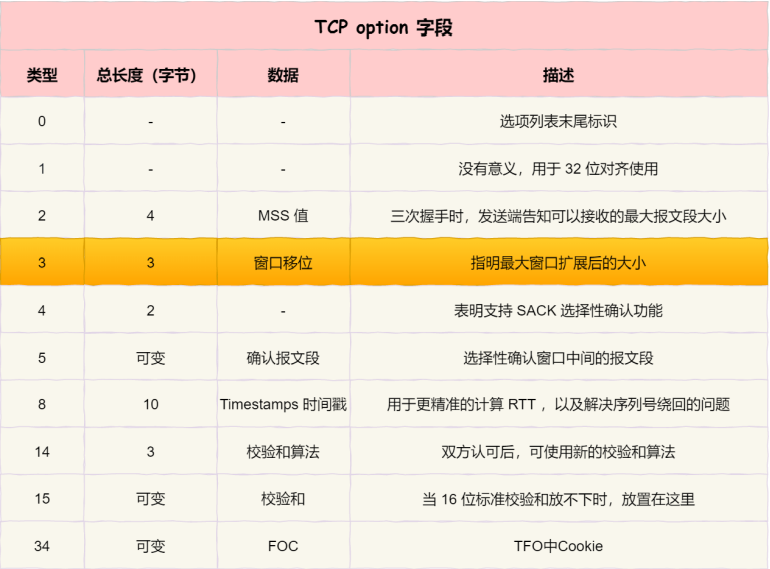
网络的传输能力是有限的,当发送方依据发送窗口,发送超过网络处理能力的报文时,路由器会直接丢弃这些报文。因此,缓冲区的内存并不是越大越好。
(2)如何确定最大传输速度?
TCP的传输速度,受限于发送窗口,接收窗口以及网络设备传输能力。
其中,窗口大小由内核缓冲区大小决定。如果缓冲区与网络传输能力匹配,那么缓冲区的利用率就达到了最大化。
(3)如何计算网络传输能力呢?
网络是有「带宽」限制的,带宽描述的是网络传输能力
它与内核缓冲区的计量单位不同:
带宽是单位时间内的流ᰁ,表达是「速度」,比如常见的带宽 100 MB/s;
缓冲区单位是字节,当网络速度乘以时间才能得到字节数。
带宽时延积BDP决定网络中飞行报文的大小。所谓【飞行】,是指它们就在网络线路、路由器等网络设备上。
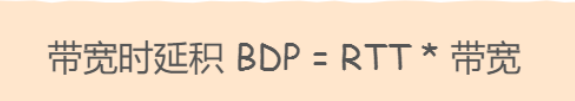
其中:RTT为网络时延。
由于发送缓冲区大小决定了发送窗口的上限,而发送窗口又决定了「已发送未确认」的飞行报文的上限。因此,发送缓冲区不能超过「带宽时延积」。
发送缓冲区与带宽时延积的关系如下:
如果发送缓冲区「超过」带宽时延积,超出的部分就没办法有效的网络传输,同时导致网络过载,容易丢包;

接收缓冲区范围调节

接收缓冲区可以根据系统空闲内存的大小来调节接收窗口:
如果系统的空闲内存很多,就可以自动把缓冲区增大一些,这样传给对方的接收窗口也会变大,因而提升发送方发送的传输数据数
反之,如果系统的内存很紧张,就会减少缓冲区,这虽然会降低传输效率,可以保证更多的并发连接正常工作
发送缓冲区的调节功能是自动开启的,而接收缓冲区则需要配置 tcp_moderate_rcvbuf 为 1 来开启调节功能
调节TCP内存范围
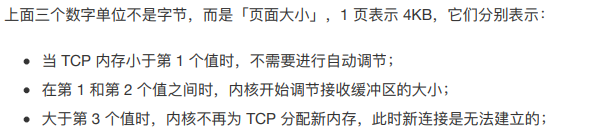
根据实际场景调节的策略
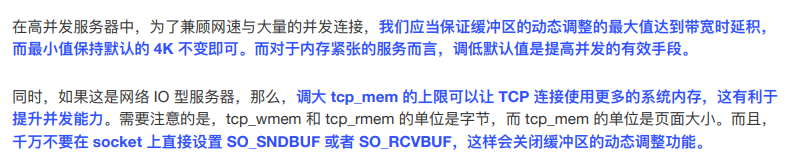
小结:
全站分卷索引 · 230 卷
- 1代码随想录知识星球精华(最强八股文)第五版(计算机基础篇)
- 2DNS
- 3DNS解析过程
- 4递归查询和迭代查询
- 5HTTP特性与简述
- 6HTTP版本演变
- 7HTTP/2
- 8HTTP1.1协议的性能问题
- 9兼容HTTP1.1
- 10二进制帧
- 11并发传输
- 12服务器主动推送资源
- 13总结
- 14HTTP/3
- 15HTTP/2的缺点
- 16QUIC协议的特点
- 17HTTP/3协议
- 18HTTP缓存
- 19协商缓存
- 20HTTPS
- 21HTTPS的特点
- 22非对称加密
- 23摘要算法+数字签名
- 24数字证书
- 25证书信任链
- 26HTTPS是怎么建立连接的
- 27TCP与UDP头部格式
- 28TCP
- 29列举TCP选项
- 30TCP三次握手
- 31为什么需要三次握手?
- 32什么是半连接队列
- 33什么是SYN攻击
- 34为什么挥手需要四次
- 35TIME_WAIT 过多有什么危害?
- 36TCP的滑动窗口
- 374. 程序是如何表示发送方的四个部分的呢?
- 386. 接收窗口和发送窗口的大小是相等的吗?
- 391. 慢启动
- 403. 拥塞发生
- 414. 快速恢复
- 42IP基础
- 43IP地址
- 44在浏览器中输入URL并按下回车之后会发生什么
- 45TCP 抓包实践
- 46TCP连接与断开优化
- 47TCP内核参数
- 48主动方的优化
- 49被动方的优化
- 50Linux是如何收发网络包的
- 51收发流程
- 52面试题
- 53TCP/IP四层网络模型
- 54五层网络体系结构
- 55HTTP响应报文
- 56HTTP常见字段
- 57什么是TCP粘包问题?如何解决TCP粘包问题?
- 58UDP会不会产生粘包问题呢?
- 59请求报文
- 60时间消耗
- 61HTTP缓存有几种
- 62HTTP1.0和HTTP1.1的区别?
- 63HTPP1.1和HTTP1.0有什么区别
- 64HTTP/3
- 65HTTPS是如何建立连接的
- 66DNS是什么
- 67递归查询和迭代查询
- 68TCP与UDP的区别
- 69TCP和UDP分别在什么场景使用?
- 70三次握手的过程
- 71Keep-Alive的优缺点
- 72CDN的工作流程
- 73Session的工作原理
- 74TCP重传机制是怎么实现的?
- 75什么是SS0
- 76HTTP优化方案
- 77浏览器地址栏输入URL回车后涉及到的流程
- 781.5 浏览器发送HTTP/HTTPS请求到web服务器
- 79SYN攻击
- 80操作系统
- 81操作系统的功能
- 82进程和线程
- 83线程基础
- 84进程调度
- 85进程调度方式
- 86进程通信
- 87消息传递(消息队列)
- 88信号量
- 89信号
- 90线程通信
- 91多线程
- 92进程通信
- 93消息队列
- 94信号
- 95守护进程
- 96互斥与同步
- 974. 互斥锁解锁
- 983. 处理方法
- 99读写锁
- 1002. 销毁读写锁
- 1014. 写锁定
- 1021. 创建条件变量
- 1034. 阻塞线程
- 104信号量
- 1054. V操作
- 1062. 读者-写者问题
- 107存储系统
- 108虚拟内存
- 109内存分段
- 110内存分页
- 111虚拟内存
- 112文件系统
- 1135. 文件访问
- 114目录
- 1154. 目录操作
- 1163. 目录的实现
- 1177. 虚拟文件系统
- 1184. 文件系统性能
- 119磁盘编址
- 120三层抽象
- 121外设管理
- 122Linux
- 123select/poll/epoll的区别和联系
- 124Linux 内存管理
- 125Linux虚拟内存
- 126Linux 信号
- 127Linux设计
- 1283. 各种IO模型的比较
- 129Linux网络
- 130Linux中的软链接和硬链接有什么区别?
- 131什么是中断和异常
- 132信号和信号量有什么区别
- 133Linux中如何查看一个进程
- 134进程、线程的区别?
- 135进程之间的通信方式
- 136如何解除死锁
- 137分段和分页的区别
- 138IO多路复用
- 139MySQL表连接
- 140过滤条件
- 141执行一次update语句,发生了什么
- 142用户账号存储
- 143用户账号删除
- 144索引
- 145索引有哪些类别
- 1462. 按照存储分类
- 1475. 按照字段个数分类
- 148索引区分度
- 149索引什么时候会失效
- 150事务的四大特性ACID
- 151并行事务会出现什么问题
- 152幻读是如何解决的
- 153事务隔离的实现
- 154读已提交是怎么实现的
- 155锁
- 1561、全局锁
- 1573、行级锁
- 158锁的划分
- 1592.、程序员角度
- 160Innodb使用表锁还是行锁
- 161什么是binlog
- 162执行引擎
- 163MySQL常见问题
- 1642. 事务
- 1653. 脏页
- 1664. 表结构
- 1676. 查询效率
- 168MySQL分库分表
- 169垂直分表
- 170水平分库
- 171分库分表的问题
- 172数据库排序思路
- 173MySQL主从复制
- 1745. 主从复制模式
- 175面试题
- 176执行一条select语句,发生了什么?
- 177你对关系范式有哪些了解
- 178数据库
- 179Redis基础
- 180Redis单线程为什么还这么快
- 181Redis底层数据结构
- 182Redis持久化
- 183AOF日志
- 184RDB快照
- 185Redis功能
- 1862. 哨兵模式
- 1873. 切片集群
- 188Redis哨兵机制是什么
- 189什么是集群脑裂
- 190过期删除策略有哪些
- 191Redis的LRU算法和LFU算法有什么区别
- 192什么是缓存击穿
- 193如何保证删除缓存操作一定能成功?
- 194为什么Redis是单线程
- 195Redis底层使用了什么数据结构
- 196Redis实现分布式锁
- 197缓存中的热点数据和冷数据是什么
- 198缓存雪崩、击穿、穿透和解决办法【常问】
- 199Redis过期删除策略有哪些
- 200关键概念
- 201单例模式的应用场景
- 202工厂模式
- 203实际应用
- 204抽象工厂模式
- 205概念
- 206应用
- 207实现步骤
- 208主要角色
- 209代理模式应用
- 210策略模式
- 211示例
- 212装饰模式
- 213主要角色
- 21423种设计模式的概念
- 215创建型模式
- 216行为型模式
- 217设计原则
- 218迪米特法则
- 219你在实际开发中用过哪些设计模式
- 220依赖倒置
- 221代理模式和适配器模式有什么区别
- 222固定长度编码
- 223冯诺依曼模型
- 224总线
- 225输入/输出设备
- 226编译系统如何工作
- 227处理器解释指令
- 228场景题 & 系统设计
- 229如何设计一个本地缓存
- 230如何设计一个RPC框架